存算一体架构别急着吹:忆阻器芯片、HBM-PIM和那堵内存墙
内存墙。听烂了。可每次看大模型推理时GPU风扇狂转,我还是会冒出一个很土的问题:数据非得来回搬吗?
冯·诺依曼架构里,计算和存储分家。CPU/GPU算得飞快,内存那边慢半拍。矩阵乘加这种活儿,权重刚从DRAM搬到片上缓存,算完再搬回去。能耗账更扎心:很多场景里,数据搬运的能耗比计算本身还高。存算一体架构就是冲着这笔搬运费去的。别把它想成魔法,它更像把厨房和仓库打通——菜就在货架旁边炒。
但注意,存算一体有两条容易混的线:近存计算和存内计算。近存是把计算单元挪到内存旁边,HBM-PIM是典型;存内是直接在存储阵列里做乘加,RRAM、MRAM、SRAM-CIM都有人做。差别不小,后面拆开聊。
存算一体架构到底在“省”什么?不是玄学,是少搬砖
先看最直观的模拟存内计算。交叉阵列,横着走输入电压,竖着读输出电流,交叉点放一个忆阻器,电导值就是权重。欧姆定律给电流,基尔霍夫电流定律把一列电流加起来。一次读操作,矩阵向量乘加就在阵列里完成了。输入电压向量V,权重电导矩阵G,输出电流I≈V×G,再送ADC转成数字。
我第一次看这个原理图,觉得简单得离谱。然后就被现实打脸。ADC要吃功耗,DAC也要,外围电路一加,系统能效没PPT那么梦幻。器件还有非线性、漂移、良率。对吧,实验室里的“100倍能效”经常是阵列级数字,落到板子上先被ADC和编译器砍一刀。
 忆阻器存算一体芯片交叉阵列结构示意图
不过话说回来,省搬运这件事是真有价值。大模型推理里大量稠密矩阵乘,权重重复读,搬一次算很多次,存算一体架构正好对口。可要是控制密集、稀疏跳转多的算子,硬塞进crossbar就尴尬了。它不是万能扳手。
科研圈不是纸上谈兵:忆阻器存算一体芯片已经能片上学习
2023年,清华大学吴华强、高滨团队在《Science》发了忆阻器存算一体芯片的工作,核心点很硬:不止做推理,还能在片上做权重更新和学习。传统方案训练时要把权重搬来搬去,存算一体芯片把更新放到阵列附近,少绕路。论文展示的芯片把忆阻器阵列和外围电路集成在一起,支持多种神经网络训练任务。这个方向的意义在于,它把“存算一体只能做低精度推理”的老印象往前推了一步。
当然,别急着开香槟。模拟器件的写噪声、电导漂移、耐久性还在。片上学习要解决校准和误差累积,系统设计得跟器件特性绑在一起。科研突破和量产之间,隔着工艺、封装、测试、软件栈。说实话,这中间的距离,比论文里的SEM图长多了。
 清华大学忆阻器存算一体芯片片上学习架构图
产业侧也在动。知存科技的WTM2101在语音唤醒、识别这类低功耗场景量产落地;后摩智能把存算一体架构推到智能驾驶芯片,公开资料里鸿途H30主打256TOPS级别算力和几十瓦功耗。场景选得挺聪明——语音和智驾都对功耗、延迟敏感,又不用一上来就硬刚高精度通用计算。
HBM-PIM和SRAM-CIM:两条路线,别混着吹
HBM-PIM这几年声量很大。三星Aquabolt-XL把计算单元塞进HBM2堆叠里,SK海力士的AiMX用GDDR6-AiM做加速卡,盯着大语言模型推理。它的好处是带宽高、离数据近,在内存内部做部分计算,减少数据在内存和GPU之间的往返。挑战也明显:DRAM里加计算单元,热、成本、良率都难受;编程模型和现有GPU生态怎么接,是另一道坎。
SRAM-CIM走的是数字路线。用SRAM位线做乘加,精度好,工艺兼容性强,适合边缘端。缺点是面积开销,存权重的地方还要加计算外围。RRAM这类模拟存内计算密度高、能效潜力大,可精度和可靠性要慢慢磨。MRAM、PCM也各有拥趸。别听人一句“存算一体”就以为是一家,模拟和数字、近存和存内,工程取舍完全不同。
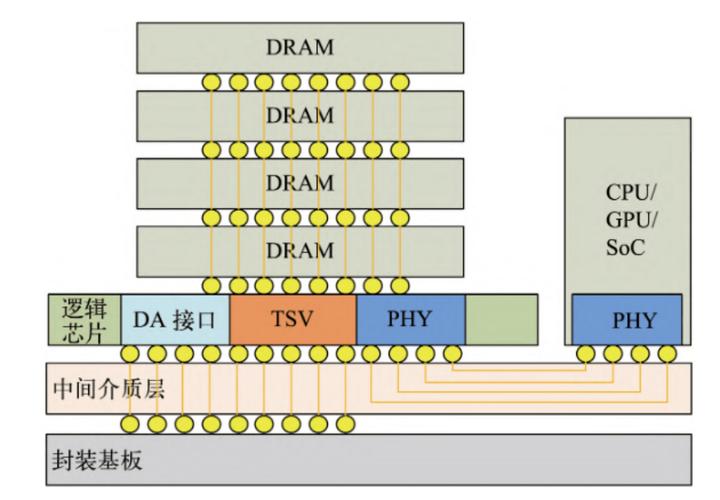 三星HBM-PIM存算一体内存堆叠结构示意图
我个人的判断:短期内,HBM-PIM和SRAM-CIM更容易在特定推理场景落地;模拟RRAM在边缘AI、传感器端有戏,但工具链和校准要补课。谁先跑出来,不只看阵列能效,还看编译器能不能把算子稳稳当当地映射上去。
真正难的不是阵列,是软件栈和“算得准”
 真正难的不是阵列,是软件栈和“算得准”
存算一体架构最容易被低估的坑,是软件。一个卷积或矩阵乘,拆成多大阵列?权重放不下要不要复制?ADC怎么共享?量化误差怎么补?这些事编译器不解决,芯片就是一块漂亮的硅。实验室里跑一个MNIST很顺,到了Transformer的注意力机制,KV cache、softmax、layer norm这些算子未必适合crossbar。对吧,GEMM好办,别的算子不见得。
可靠性也是硬骨头。温度一变,电导漂移;写多了,器件疲劳;阵列大了,IR drop和寄生效应上来。系统得做校准、冗余、纠错。端到端收益要拿真实模型、真实板卡去测,别拿阵列级峰值能效当系统能效。行业现在缺的是公开、可复现的benchmark,不是又一张“能效提升XX倍”的柱状图。
所以存算一体架构能不能成,关键看三件事:器件一致性、外围电路开销、软件映射效率。少一个都难受。下一步我更关心谁先把工具链做顺,让算法工程师不用懂忆阻器物理也能用起来。那一天到了,内存墙才真的松一口气。