Chiplet互连:几毫米的走线,怎么就成了硬骨头?
先讲个真事。去年冬天,我在客户实验室看一颗2.5D封装的样片。CPU die和IO die并排躺在硅中介层上,中间隔着不到两毫米。上电,跑16GT/s的PRBS,眼图一出来,全屋子安静了半秒。眼高只剩几十毫伏,眼宽也快合上了。有人嘀咕:这么短的线,怎么还要按三十厘米主板走线的规矩来伺候?
这就是Chiplet互连的日常。它不性感。也不像“把大芯片拆小”那么轻巧。真正卡人的,是那条几毫米的线。
别被“短”骗了:短距离互连的敌人不是长度
很多人一听Chiplet互连,脑子里就是“把几个小芯片拼起来”。对,但太粗。你先看物理层:die和die之间不是拿根铜线一焊就完事。中间要过微凸点、再布线层、硅中介层,有的还要穿TSV。微凸点就是芯片脸上的小焊球,直径几十微米;再布线层像小区里的支路,把信号从焊球引到该去的地方;硅中介层是一块没有晶体管的硅片,专门当“高架桥”。
短,只是表象。长度短,损耗确实小。可高速信号怕的不只是损耗。它怕阻抗不连续,怕相邻线打架,怕过孔和凸点带来的寄生电容,怕测试点像一根多余的尾巴。你想想,一条两毫米的线,两头各挂一个焊球,中间还拐两个弯。信号走到那儿,像开车刚上高架就遇到连续减速带。能不难受?
 Chiplet 2.5D硅中介层微凸点互连截面示意图
更麻烦的是密度。Chiplet互连要在很窄的die边缘塞下成百上千根信号。bump pitch从100微米往40微米、再往更小走,留给布线和屏蔽的空间越来越抠。你想加地线隔离?面积不答应。你想拉大间距降串扰?带宽和凸点数量不答应。工程师就在这几条约束里拧巴。
所以别把Chiplet互连理解成“主板走线的缩小版”。它更像在两家挨着的商场之间修连廊。距离是短,可连廊上要过人、过货、过空调管,还要考虑消防和承重。短距离的互连,拼的是出口和接口,不是马路长度。
眼图闭合那一刻,标准才有意义
说回眼图。眼图就是高速信号叠在一起的样子,眼睛张得开,说明0和1还分得清;眼睛闭合,误码率就上来了。那天高温一跑,眼图塌得厉害。查来查去,不是芯片坏了,是通道的阻抗和串扰在作怪。硅中介层上的线太密,相邻通道耦合;凸点电容又把高频边沿磨圆。再加上测试探针的寄生,眼图就给你脸色看。
这时候UCIe这类Die-to-Die互连标准才有存在感。它不只是规定“用多少根线、跑多快”,还把物理层、适配层、协议层拆开。物理层管电信号怎么发、怎么收、怎么均衡;适配层管数据打包和重传;协议层尽量沿用PCIe或CXL那套生态。说白了,标准解决的是“两边芯片不是一个爹”时的握手问题,不是替你解决硅片上的电磁场。
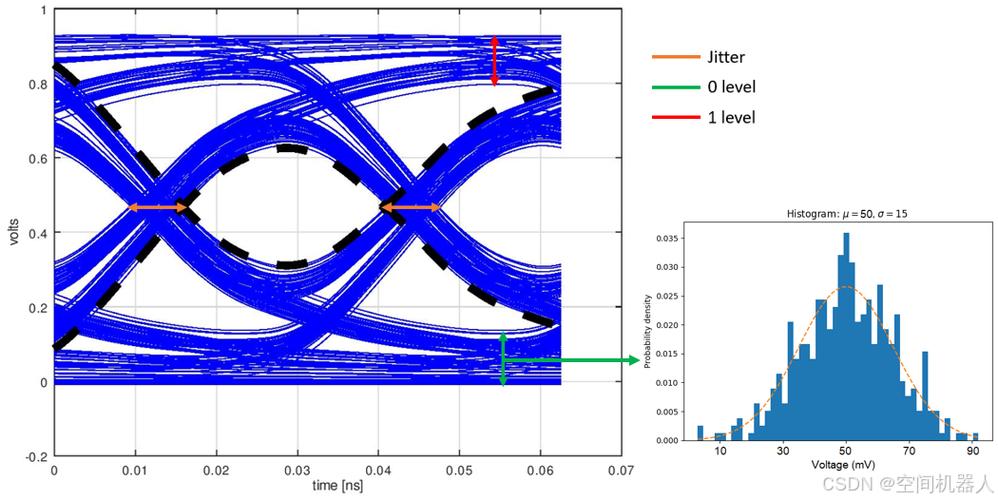 UCIe Die-to-Die高速互连眼图测试场景
我见过一种误解:只要用了UCIe,互连就能随便拉。真不是。标准给的是模板,封装厂和设计团队还得做通道仿真、电源完整性、热应力。16GT/s的NRZ还是32GT/s的PAM4,用标准封装还是先进封装,bump pitch多少,通道插损预算多少,这些选型会直接决定眼图。你以为在选协议,其实在选封装和材料。
还有功耗。Die-to-Die互连的能效常用pJ/bit衡量,就是每传一位数据花多少皮焦。别小看这点。AI加速器里几千根通道同时跑,省0.1 pJ/bit都是大事。短距离并行互连看着省电,但驱动器和接收器多了,静态功耗和面积也上来了。串行互连线少,可SerDes本身不便宜。怎么折中?看场景。CPU和IO die之间,带宽和延迟要平衡;HBM和计算die之间,密度和能效更敏感;多FPGA拼接,可测试性和生态又跳出来。
混合键合很香,但不是“万能胶”
再说3D。2.5D是并排躺,3D是上下叠。混合键合把铜和铜直接压在一起,不用焊球,pitch能往个位数微米走。听起来很爽,对吧?互连密度上去了,功耗也降了。可它真不是拿胶水一粘。
铜表面要平整,颗粒要控制,对准精度要够,热膨胀还得匹配。更头疼的是测试。你很难在堆叠之后再去探每一颗die的凸点。所以KGD,也就是已知良好芯片,变得特别关键。堆之前不筛干净,堆完一颗坏die拖垮一整叠。成本不是线性的,是跳崖式的。
 混合键合铜铜界面截面扫描电镜图
还有热。上下叠起来,中间那层die散热路径变长。功耗密度一高,热点就冒出来。热又会影响时序和互连电阻。你说互连越短越省电?理论上对,但前提是驱动器和寄生没把你的收益吃掉。混合键合的电容是小了,可散热和良率账单跟着来。工程师做选型,不能只看一根线的电阻。
选型时,别只盯着带宽
 选型时,别只盯着带宽
我现在看Chiplet互连项目,先问几个很土的问题。距离多远?通道多密?每比特功耗预算多少?封装成本能扛到哪?测试方案在哪一步做?生态上,IP和协议栈跟不跟得上?这些问题不回答,光说“带宽翻倍”没意义。
用在哪?CPU拆成计算die和IO die,图的是工艺分开、良率提升;AI芯片外挂HBM,图的是内存带宽和容量;网络芯片多die拼大,图的是die尺寸和产能。场景不同,互连的甜点区完全不同。你拿先进封装的UCIe方案去套一个成本敏感的小芯片,大概率是杀鸡用牛刀。反过来,你在高密度计算里还用老式标准封装互连,带宽和能效又不够看。
常见误解得泼点冷水。误区一:互连越短越好。短有短的好处,但短距离的阻抗控制更抠,测试更难,散热更挤。误区二:标准能解决一切。标准解决兼容,不解决物理。误区三:带宽越高越先进。带宽上去了,功耗、面积、误码率、成本都跟着走。误区四:混合键合会全面替代微凸点。没那么快。成本、良率、测试、生态,每道坎都要时间。
边界也很清楚。硅中介层面积大、成本高,适合高密度场景;有机基板便宜,但互连密度和电气性能有限;桥接方案在局部高密度和成本之间找平衡;混合键合把密度推到新台阶,可热和测试还没到“随便用”的程度。选哪条路,得看产品生命周期、出货量和团队能力。
说实话,Chiplet互连的难点从来不在“连”。把两个die连起来,实验室总能想办法。难的是连得让人敢量产。眼图要留裕量,测试要能覆盖,热要压得住,成本要算得过来。那条几毫米的线,背后是一整套封装、材料、电路和测试的拉扯。
下次再有人跟你说“Chiplet就是把芯片拼起来”,你可以笑笑。拼起来容易。拼完还能让信号睁着眼、让良率不跳水、让老板不拍桌子,那才是Chiplet互连的真功夫。