小样本学习落地有多难?从原型网络到提示微调的科研与工程拆解
产线只给20张缺陷图,模型怎么活?
先别急着上大模型。产线新缺陷只攒了20张图,类别还偏。传统监督学习那套,喂不饱。小样本学习要干的,就是让模型在每类只有1张、5张、10张标注时,还能分出没见过的类。注意,这不是零样本。零样本连支持集都没有,小样本好歹给你几张“样例”。
核心难点在任务级泛化。训练时构造一堆小任务,每个任务里分支持集和查询集,模型学的是“拿几张样本快速适配新类”的能力。学术圈常写N-way K-shot。5-way 1-shot,就是5个类每类1张标注。听起来很极限,对吧?工业界真会遇到。
说实话,我第一次看到论文里5-way 1-shot刷到90%多,也兴奋。后来自己复现,翻车。数据划分有泄漏,预训练骨干在目标域见过相似图,超参还偷偷按测试集挑。啧。小样本实验,水挺深。
 小样本学习原型网络特征空间分类示意图
所以别只看一个指标。要看episode怎么采、骨干预训练数据干不干净、跨域测试做没做。否则论文很漂亮,上线就露馅。
三条主线:度量、元学习、迁移微调
第一条线,度量学习。Matching Networks、Prototype Network、Relation Network,都是老熟人了。原型网络最直观:把每个类的支持集特征求均值,得到类原型;查询样本离谁近,就判给谁。原型网络的关键不是公式,是嵌入空间能不能迁移。骨干不行,距离度量再花哨也白搭。
第二条线,元学习。MAML那套思路是学一个初始化,让模型在新任务上走几步梯度就能适配。任务采样构造episode,训练和测试都按小任务来。想法很漂亮。代价也实在:二阶导、计算图、任务分布匹配,一个都躲不开。任务分布偏了,元学习照样崩。
第三条线,迁移微调。这几年更现实。预训练表征够强,少量标注做轻量微调,往往比从头元学习香。文本侧有SetFit、PET、提示学习,把分类改成完形填空或者句子对;视觉侧有CLIP做few-shot分类器,用文本锚点对齐图像。大模型上下文学习也来凑热闹,不更新参数,靠提示里塞几个示例。方便。但成本、上下文长度、输出稳定性,都是坑。
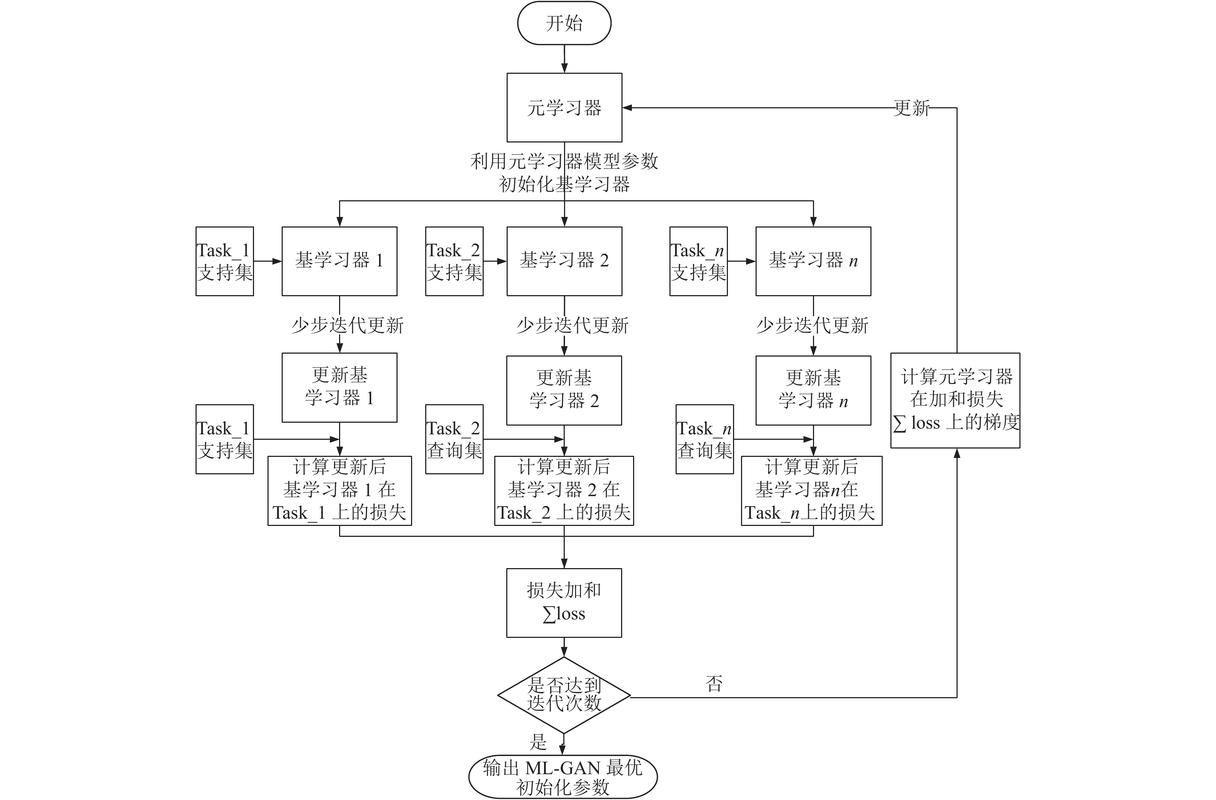 小样本学习元训练任务采样流程图
行业动态也明显:视觉基础模型往工业质检、医疗影像、遥感解译里扎。标注贵,长尾多,冷启动急。小样本学习正好卡在这个缝里。不过话说回来,它适合冷启动,不适合替代长期数据闭环。想靠20张图吃一辈子?不现实。
科研圈的新风向,和工程坑
2023年以后,风向更务实。预训练表征加轻量适配,参数高效微调,合成数据,主动学习,贝叶斯不确定性,跨域小样本。论文一堆。真落地,先问四个问题:标注预算多少?类别定义稳不稳?有没有无标注数据?部署算力够不够?
评估这块,坑最多。基准饱和了,5-way 5-shot刷到顶,换个域就掉。类别不平衡、长尾、开放集,论文里经常轻描淡写。小样本学习最怕“任务分布作弊”。训练任务和测试任务同源,指标好看;一到产线新缺陷,分布漂移,直接傻眼。所以要看跨域实验、置信区间、多次采样,别被单次结果忽悠。
工程上,我见过两种翻车。一种是把小样本当万能药,标注不补齐,数据闭环也不做。另一种是样本扩增乱来,复制粘贴、强增强,把小样本扩成“假多样”,模型学偏。合成数据能用,得控制分布。主动学习更实在,挑模型最不确定的样本去标,钱花在刀刃上。
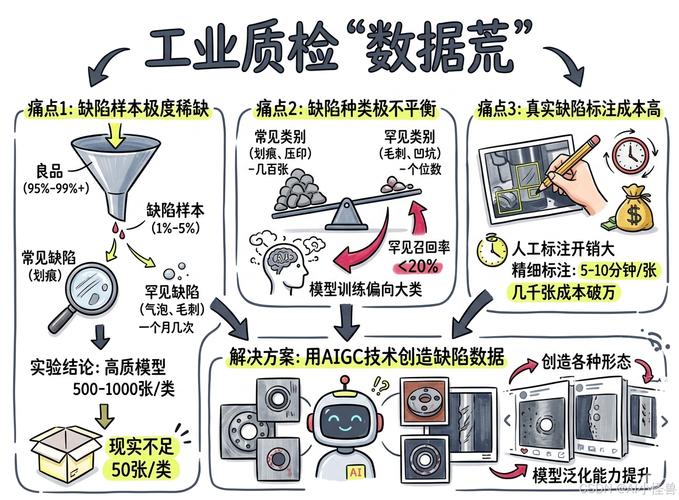 工业质检小样本缺陷检测样本扩增示意图
医疗影像那边也类似。少数病种标注少,跨中心域偏移大。小样本方法能救急,但不能替代临床验证。遥感解译更明显,季节、传感器、地域一变,特征空间就挪。谁忽视域泛化,谁吃亏。
给个不总结的收尾:别迷信指标,先画任务分布。小样本学习是方法,不是许愿池。先把支持集采干净,把基线跑扎实,再谈元学习和大模型提示。真的。