模型可解释性:别把黑箱当借口,科研圈到底在捣鼓啥?
模型可解释性。这词儿现在快被用烂了。你去开个AI产品会,十个人里有八个在说“我们要做可解释”。可真问下去——解释给谁看?解释到什么粒度?出了错谁负责?全哑火。我见过最扯的一个项目:风控模型拒了用户的贷款,产品经理非要加个“解释”按钮。点开,弹出一张特征重要性条形图。用户盯着“年龄”那根柱子看了半天,问:“所以呢?”没人答得上来。这叫解释?这叫视觉安慰剂。
热力图不是解释,别被漂亮图骗了
先泼盆冷水。很多所谓“可解释性”工具,本质上就是事后归因。比如SHAP、LIME,它们干的事是:模型已经黑箱了,我在外面套一层近似,猜猜哪些输入对输出影响大。注意,是“猜”。SHAP值有博弈论底子,数学上漂亮,但你拿到的仍然是相关性,不是因果性。模型说“年龄大所以拒贷”,到底是年龄本身,还是年龄背后绑着的收入、职业、地域?SHAP不告诉你。
更麻烦的是,热力图特别容易骗人。一张医疗影像,模型圈出病灶区域,看着挺对。但科研人员把背景像素稍微扰动一下,热力图全变——模型其实在盯扫描仪的标记,根本不是病灶。这种事在2023年那波“可解释性审计”论文里被扒了个底朝天。你猜怎么着?有些商用解释工具自己的稳定性都不过关。
说实话,我特别烦那种把可解释性当合规橡皮图章的做法。欧盟AI法案要求高风险系统提供解释,结果一堆公司就塞个特征重要性页面交差。监管要是真较真,一测一个准。
 深度学习模型SHAP特征归因可视化对比图
从SHAP到因果,科研圈在补什么课
不过话说回来,科研圈没闲着。这两年风向变了——从“事后解释”往“内生可解释”和“因果可解释”猛转。什么意思?要么模型结构本身就透明,比如概念瓶颈模型(Concept Bottleneck Models):先让模型预测人类能理解的概念(比如“有羽毛”“有喙”),再用这些概念做分类。你能直接看到“因为预测有羽毛,所以判为鸟”。代价是精度掉点,但换来了可审计性。值不值?看场景。医疗影像诊断,掉两个点换医生敢用,太值了。
另一条路更硬核:机制可解释性(Mechanistic Interpretability)。这拨人想把神经网络拆成电路。Anthropic前阵子用稀疏自编码器在大模型里找到了“可解释特征”——比如一个神经元专门对“金门大桥”有反应,另一个对“代码里的bug”有反应。听着玄乎,但确实在往“打开黑箱”的方向走。当然,离工程落地还远。我跟你讲,现在能稳定解释的,还是小模型、特定任务。大模型?呵呵。
因果推断那边也没闲着。传统可解释性只问“模型看了啥”,因果可解释性问“如果我把这个特征改一改,输出会怎么变”。这叫反事实解释。举个例子:用户被拒贷,系统告诉他“如果收入提高两千,就能过”。这比“年龄贡献了0.3”有用一万倍。但反事实解释有个坑——它可能给出不现实的建议。比如“如果你年轻十岁”。这就得靠领域约束来兜底。
还有个趋势我得提一嘴:可解释性正在从“模型中心”往“人中心”转。以前论文比的是解释保真度(faithfulness),现在越来越多工作测“人类能不能看懂、会不会用”。2024年CHI和FAccT上好几篇论文都在吐槽:解释得再准,用户看不懂等于零。有个实验挺逗——给医生看两种解释:一种是精确但复杂的SHAP瀑布图,一种是粗糙但直白的“因为肺部有阴影”。你猜医生信哪个?后者。精确性输给了可理解性。这巴掌打得响。
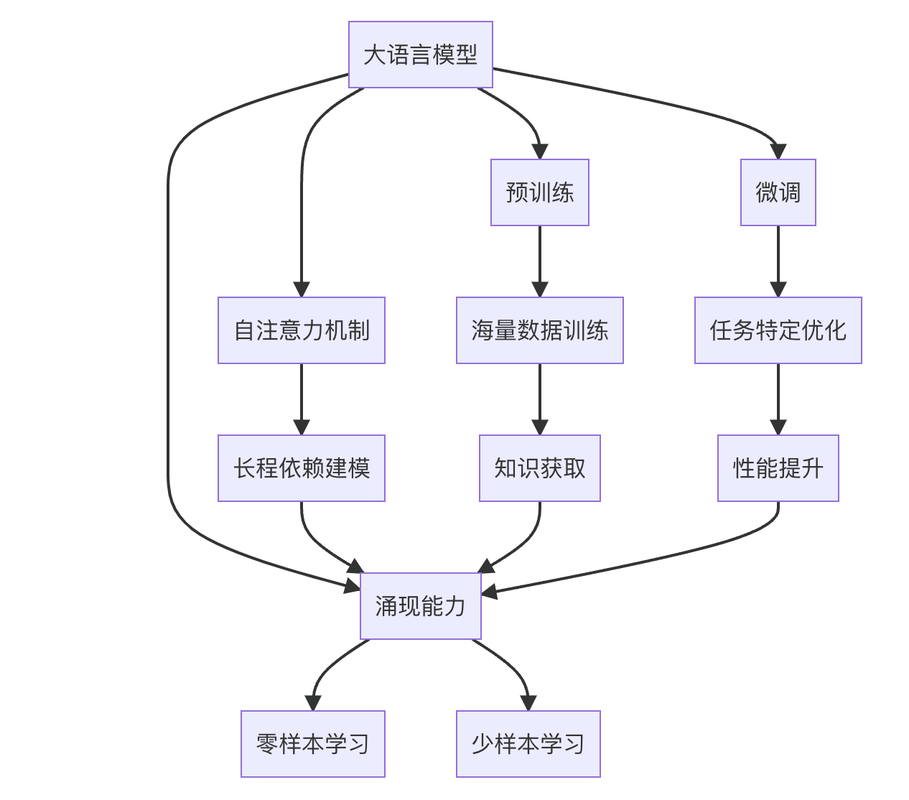 大语言模型注意力机制可解释性分析示意图
大模型时代,可解释性反而更难了?
难。太难了。参数动辄千亿,注意力头几千个。你跟我说解释?现在大模型的可解释性基本三条路:注意力可视化、探针分类器、还有前面说的稀疏自编码器。注意力可视化最直观——给你看模型在哪些token上“看”得重。但2023年有篇论文直接打脸:注意力权重和实际因果影响之间的相关性,弱得可怜。有时候模型把注意力放在某个词上,但把那个词删了,输出压根不变。这叫解释?这叫视觉噪音。
探针分类器呢?在中间层训个小分类器,看某个概念(比如“情感”)能不能被线性解码。能解码不代表模型用了这个特征。又是相关性陷阱。
所以大模型可解释性现在最前沿的,反而是行为层面的可解释性——不拆神经元了,直接测输入输出。比如给模型看一段带偏见的文本,看它输出有没有跟着偏。这叫“黑箱测试”,粗暴但有效。监管机构其实更认这个。你解释不了内部,那就拿行为证据说话。
但这里有个要命的矛盾:越强大的模型,越难解释;越难解释,越不敢用在关键场景。金融、医疗、司法,这三个领域对可解释性要求最严,偏偏大模型在这三个领域落地最慢。不是技术不行,是解释关过不了。我认识一个做医疗AI的团队,模型AUC刷到0.95,医院不敢用。为啥?医生问:“它为什么说这个病人有风险?”团队只能答:“因为注意力权重……”医生直接打断:“别跟我扯权重,你就说它看的是不是肺结节?”答不上来。换了个可解释性稍差但能输出“高风险区域对应结节位置”的模型,AUC只有0.91,医院反而签了。可解释性不是锦上添花,是准入门槛。
再说个行业动态。今年年初欧盟AI法案落地第一阶段,高风险AI系统的可解释性要求从“建议”变成“义务”。很多公司慌了,临时抱佛脚找解释工具。结果发现市面上的工具要么只能处理表格数据,要么对多模态模型直接失灵。有个做自动驾驶的哥们跟我吐槽:“解释个鬼。激光雷达点云、摄像头图像、毫米波雷达,三模态融合。你告诉我怎么解释?SHAP跑一张图要十分钟,跑一帧点云内存直接炸。”现实就是这么骨感。
那怎么办?我的看法可能不太主流:别追求全局可解释性,追求局部可操作解释。全局解释听起来爽,但大模型根本没有稳定的全局逻辑。局部解释——就针对当前这个输入、这个预测,给出人能理解、能行动的反馈。比如自动驾驶在某个路口刹车,解释是“右侧有行人横穿,距离3米”。这不比“第47层注意力头权重0.7”强一万倍?
当然,局部解释也有坑。它可能被对抗攻击利用——你改一点输入,解释就变了。所以还得配合稳定性测试。科研圈现在在搞“解释鲁棒性”指标,专门测这个。进展嘛……只能说在路上了。
最后说句大实话。模型可解释性这摊子事,短期内别指望完美。科研在往前走,但工业落地永远比论文慢三拍。我的建议很粗暴:别把可解释性当学术表演,当产品功能做。用户要的不是SHAP值,是“我该怎么办”。搞清楚这个,比发十篇顶会有用。
扯远了。回到开头那个问题——解释给谁看?我的答案:给做决策的人看,给受决策影响的人看。不是给论文审稿人看。这句话,值得所有做可解释性的人贴在显示器上。