联邦学习中的非独立同分布:凌晨三点,模型在客户机里偷偷跑偏
凌晨两点半,群里弹出来一张截图。三条曲线,头两轮还手拉手,第三轮开始分家——客户A的本地准确率飙到0.97,客户C一路掉到0.61,中间那条聚合后的全局模型卡在0.78横盘,像被人按了暂停键。
干这行的都懂,这不是代码写错了,也不是通信断了。这是联邦学习里最烦人的那只鬼:非独立同分布,Non-IID。
说真的,头一回碰上的时候我也怀疑人生。加密没毛病,梯度也没传错,怎么模型就是不收敛。后来想明白了——我们一直在用“各家的数据长得差不多”这个默认前提做设计。而现实里,压根没人跟你差不多。
“不一样”这件事,其实分好几层
 “不一样”这件事,其实分好几层
很多人一开口就说数据异构,讲得跟天气一样笼统。拆开来看,它至少是四件事叠在一起。
标签分布不一样,叫标签倾斜。特征分布不一样,叫特征倾斜。样本量悬殊。还有时间上的漂移——早上采的样本和晚上采的不是一个世界,这在风控里尤其明显。
而联邦学习恰好对这四种偏差零容忍。
拿个具体的说。某风控场景,A机构是家大型银行,欺诈样本占比大概0.02%;B机构是家做下沉市场的小贷公司,欺诈率4%。两百倍的差距。这两家要是搞横向联邦,会出什么事?
A的梯度里几乎全是“正常”信号,B的梯度里密密麻麻全是“异常”信号。聚合的时候,按样本量加权,B的更新被稀释稀释再稀释,最后全局模型学出来一个什么玩意儿——对欺诈几乎麻木。B机构接入一个月,坏账率反而涨了。这种事故,不是模型笨,是聚合规则在欺负人。
客户端漂移:几个人拉一辆车,各朝各的方向
我一直觉得FedAvg这个算法名字起得挺老实。它就是平均。每个客户端本地跑几轮SGD,把权重交上去,服务端取个加权平均。
听起来合理对吧。但平均这件事有个隐含前提——每个人交上来的东西,是同一个目标函数的不同估计。换句话说,大家在做同一张卷子,只是题型不同。
实际呢?A在考语文,B在考物理,C在考数学。你把他们脑子里的参数平均一下,出来的不是全才,是四不像。
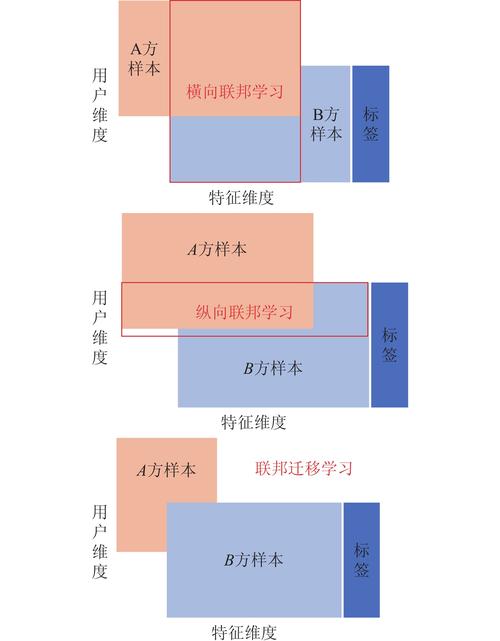 联邦学习客户端标签倾斜数据分布对比示意图
学术上管这叫客户端漂移(client drift)。我更喜欢一个更土的比喻——五个人拉一辆车,每个人都在自己家门口多走了五步。步长不一样,方向不一样,矢量和算下来,车要么原地打转,要么被拽到某个人的家门口去。而那个“某个人”,往往还不是数据质量最好的那个。
更要命的是,这个偏差会随轮次累积。不是越训越准,是越训越偏。所以你会发现有些任务训到第五十轮,全局模型的性能还不如第三轮。
这时候新人常问:那我多加几轮不就行了?
不行。多几轮,漂得更狠。
真正有效的做法,是在本地训练的时候给它拴一根绳。这就是FedProx的思路——在本地损失函数里加一个近端项,约束本地模型别离全局模型太远。你可以理解成:出门可以,别走太远,走远了拽你一下。
SCAFFOLD走的是另一条路,给每个客户端维护一个控制变量,本质上是在记录“你跟全局到底偏了多少、偏在哪”,下一轮本地更新时把这个偏差补回去。方向修正,比单纯拉绳子更聪明一点,代价是通信开销翻倍——每个客户端要多传一份控制变量。
工程上就是这么回事,没有白拿的好处。
那些年我们踩过的坑
讲讲几个真金白银换来的经验。有些是常识,有些反常识。
坑一:以为Non-IID只影响收敛速度。
错。它不只是慢,它会收敛到一个更差的点。而且这个差点,往往是对少数群体不友好的点。谁样本少,谁的诉求就被平均掉。这不是技术问题,这是合规问题。你做医疗联邦,两家三甲加一家社区医院,社区医院的罕见病样本在聚合里根本听不见声音,最后模型对罕见病就是瞎的。上临床,出事。
坑二:按样本量加权,觉得这叫“公平”。
公平个鬼。样本多的客户端不一定是好客户端,可能是刷单大户、可能是埋点重复上报、可能是把测试集混进了训练集。我在一个项目里见过,某客户端样本量是别人的三十倍,一查,日志格式化bug,同一条记录写了好几遍。它一加权,全局模型基本等于只训了它一家。
现在我的习惯是:先看客户端的数据画像,标签分布、特征分布、时间分布,三张表摆一块儿。谁疑似异常,先降权或者踢出去。宁可少几家,不要带病聚合。
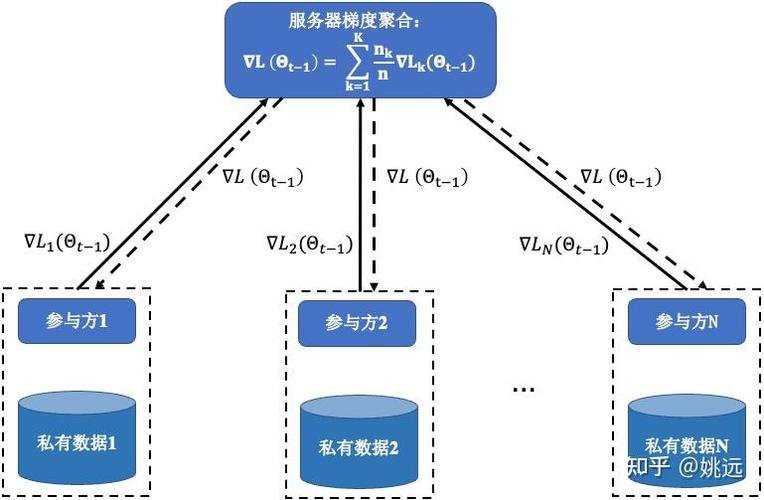 联邦平均算法客户端漂移梯度方向偏差示意图
坑三:拿IID的benchmark吹效果。
这行里最不缺的就是这个。论文里在CIFAR上按类别切几刀,切得还挺均匀,然后报告一个漂亮的收敛曲线。你真拿去银行跑,客户数据是不按你切的方式分布的。真实场景里,你压根没有一个全局的IID测试集。你只有各家自己的验证集。你怎么评估全局模型?这是个很硬的开放问题,别装作它不存在。
坑四:以为加个差分隐私、加个安全聚合就万事大吉。
两码事。DP管的是隐私泄露,安全聚合管的是通信过程中的信息暴露。Non-IID管的是统计上的异质性。三者可以同时出现在一个系统里,互不解决。把隐私做好了,不代表模型不偏。
治不好,但可以管住
 治不好,但可以管住
我的态度是:别指望彻底消灭Non-IID,它不是bug,它是现实。你能做的是把它管住。
数据层,做客户端选择。每一轮挑哪几家上,本身就是个策略问题。全量参与当然稳,但成本高;随机采样便宜,但容易被极端分布的客户端带偏。比较务实的做法是按标签分布做分层采样,让每一轮的参与集合尽量接近全局分布。
算法层,算法上就用FedProx一类的近端约束,或者直接上个性化联邦学习——干脆不追求一个模型服务所有人,全局模型学共性,每个客户端再挂一个自己的私有头学个性。这个思路我越来越认同。医疗场景尤其合适,各家医院的诊疗习惯本来就不该被抹平。
聚合层,服务端学习率别设太大。本地多跑几轮、服务端小步走。听起来笨,稳。
还有一种情况要认命:极端Non-IID。比如某个客户端只有一类样本,甚至只有几十条。这种用FedAvg基本没救,权重怎么调都是噪声。老老实实走个性化,或者干脆把它从联邦里摘出去单独训,别硬凑。
最后一个冷思考。我们做联邦学习,图的往往不是“训一个更强的模型”,而是“在不挪数据的前提下,让各方都别太吃亏”。这两件事目标不同,评价标准也不同。如果你拿中心化训练的精度当基准去要求联邦模型,Non-IID会让你彻底失望。
反过来说,一旦你接受“每个客户端本来就该有自己的偏好”,很多设计就顺了。全局模型不是终点,它是个起点。
凌晨三点半,那三条曲线终于收敛了。改的不是模型结构,是加权方式——把那个样本量大得离谱的客户端权重压下去,把社区医院那家提上来。
事情往往就这么朴素。这世界上没有一个模型,能同时懂所有人。