大模型推理优化:从KV Cache到PD分离,钱到底烧在哪?
先甩个结论:现在大模型推理最贵的,不是把模型跑起来,而是把每个 token 又快又便宜地吐出来。贵得肉疼。你以为买了 H100 就完事了?不,显存墙、带宽墙、调度墙,一堵接一堵。
我最近看线上账单,发现一个很反直觉的事:同样一张卡,跑短 prompt 和跑长上下文,成本能差出好几倍。为啥?答案大半藏在 KV Cache 里。
显存墙先撞上:KV Cache 才是推理的隐形账本
大模型推理分两段。prefill 把整段 prompt 一次算完,算力吃紧;decode 一个 token 一个 token 往外蹦,显存带宽吃紧。问题来了:每生成一个 token,都要把历史 token 的 Key/Value 缓存下来。上下文越长,batch 越大,KV Cache 越像滚雪球。70B 模型、长上下文、几十路并发,缓存能把显存啃得干干净净。
所以别只盯模型参数量。推理优化的第一战场,是 KV Cache 的分配和复用。
早年的做法很粗暴:预分配一大块连续显存,按最大长度留坑。结果呢?碎片、浪费、并发上不去。vLLM 那篇 PagedAttention 论文干的事,说白了就是把操作系统的分页思路搬进推理:KV Cache 切成固定大小的 block,按需映射。碎片少了,并发吞吐上来了。这招不玄学,但很管用。
再往下走,是结构层面的省。MHA 的 KV 头太多,GQA/MQA 把 KV 头砍下来,缓存直接瘦身。DeepSeek 的 MLA 更狠,用低秩压缩把 KV 表示压小,长上下文推理的成本压力能缓一大口。工程上还有 prefix caching:系统提示词、few-shot 示例、固定文档,只要前缀重复,就别重复算。命中率高的时候,TTFT 能明显往下掉。
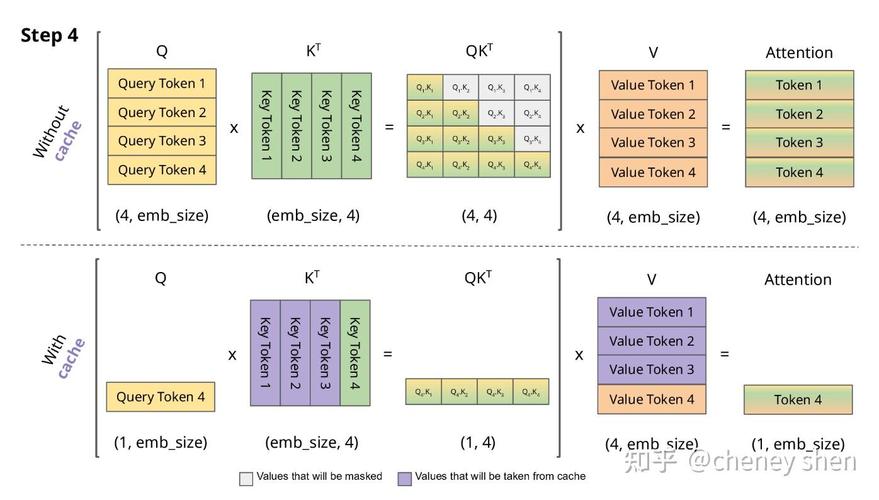 大模型推理优化 KV Cache 分页管理 PagedAttention 示意图
不过话说回来,分页不是银弹。block 太小,调度开销和元数据上来;block 太大,内部碎片又回来了。调参这事,真得像调咖啡研磨度,粗一点细一点,口感完全不同。
批处理不是越大越好:连续批处理、PD 分离和调度
很多人一提推理吞吐,第一反应是加大 batch。对,也不对。静态 batch 的问题在于:请求长度参差不齐,短请求算完了还得等长请求,GPU 空转。连续批处理(continuous batching)把调度粒度做到 token 级,谁结束谁下车,新请求随时补位。vLLM、TensorRT-LLM、SGLang 都在这一层做文章。
但 prefill 和 decode 混在一起跑,会互相打架。prefill 是计算密集型,decode 是访存密集型;长 prompt 一进来,decode 的 TPOT 抖动就上来了。于是有了 chunked prefill:把长 prompt 切块,和 decode 交错调度,牺牲一点 TTFT,换更稳的尾延迟。Sarathi-Serve 这类工作就在抠这个平衡。
更激进的是 PD 分离。prefill 和 decode 拆到不同实例,甚至不同 GPU 池。DistServe、Splitwise 这些系统研究的核心就一句:别让两种完全不同负载抢同一张卡。 听着简单,做起来全是坑。KV Cache 要跨节点传,带宽和延迟都是钱;调度器要懂 SLO,不然拆了还不如不拆。Llumnix 这类工作又在动态迁移和调度上补刀。
 大模型推理优化 连续批处理 GPU 调度 时序图
所以别迷信某个引擎的默认配置。线上流量有高峰有低谷,有长文有短问,有对话有批量离线任务。调度策略得跟着负载走。吞吐、TTFT、TPOT、P99,这四个指标经常互相拉扯。想要全都要?先看看钱包。
算得少一点:量化、投机解码和 MoE 推理
硬件不会无限便宜,那就让模型少算点。量化是最直接的路子。FP8 在 H100 这类卡上已经很实用,INT8/INT4 更激进。AWQ、GPTQ、SmoothQuant 这些方法,本质上是在权重和激活上做取舍。别只看精度掉多少,要看真实任务掉多少。有些模型量化后聊天还行,一到代码和数学就露馅。
投机解码是另一条很香的路线。小模型先草拟几个 token,大模型并行验证。接受率高的时候,decode 速度能明显提。Medusa 用多头草稿,EAGLE 在特征层做文章,思路都在降低草稿成本、提高接受率。可这玩意也挑场景:草稿模型和主模型分布不匹配,接受率就崩。 temperature 一高,收益也缩水。真不是插上就翻倍。
MoE 推理则是另一套账本。稀疏激活让单 token 计算量下来,但专家并行带来 all-to-all 通信。专家负载不均,热门专家排队,冷门专家闲着。DeepSeek 系列把 MLA 和 MoE 放一起,就是在显存、带宽、通信之间找平衡。科研上很漂亮,工程落地得盯着通信拓扑和 batch 组成。
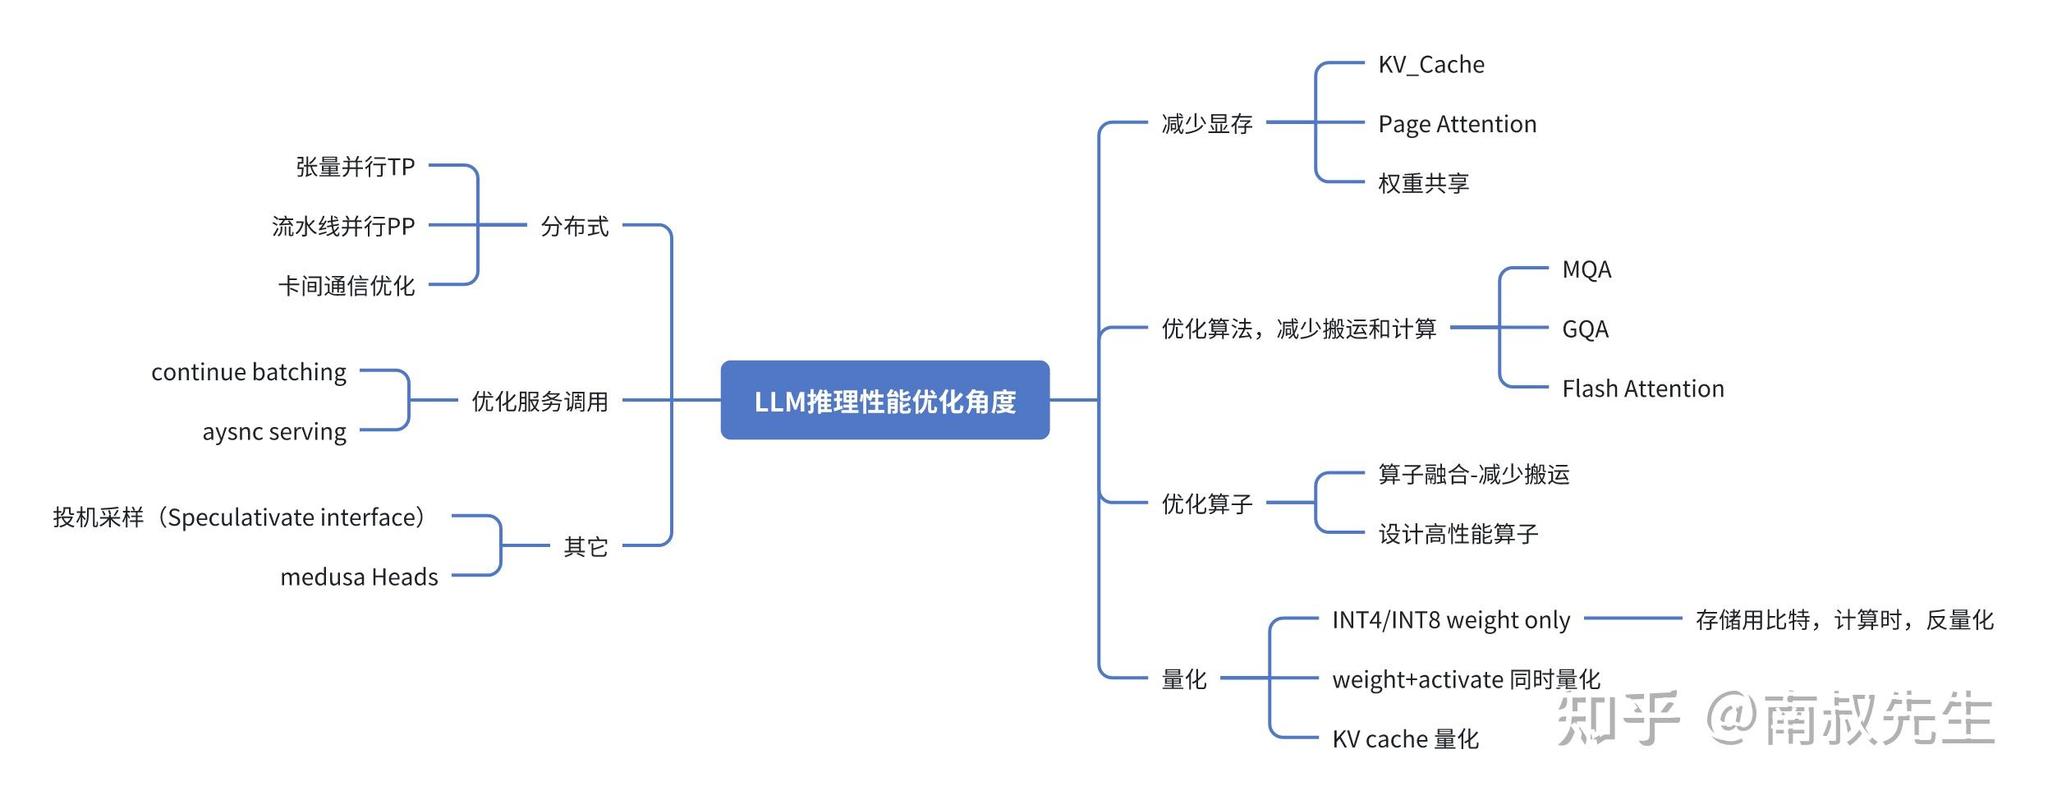 大模型推理优化 投机解码 草稿模型验证流程图
还有个趋势别忽视:推理模型火了,decode 的 token 数暴涨。以前回答几十个 token,现在思考链一拉就是几百上千。prefill 优化的边际收益在变,decode 侧的带宽和调度压力更突出了。长上下文、长输出、多轮对话,三件事叠一起,推理系统的账本会重写。
科研和工程别两张皮:评测指标与落地坑
 科研和工程别两张皮:评测指标与落地坑
论文里的吞吐数字,看看就好。真实负载里,请求长度分布、到达率、SLO、缓存命中率,全都能把结论掀翻。我见过太多 benchmark 跑得漂亮,一上线 P99 就炸的案例。为啥?因为离线测试喜欢均匀流量,线上流量偏偏爱扎堆。
所以评测至少得看几层:单卡吞吐、端到端 P99、每百万 token 成本、GPU 利用率、KV Cache 命中率、排队时延。 还要压长上下文和短请求混合的场景。只测 decode 不测 prefill,等于只看一半。只测平均不测尾延迟,等于自欺欺人。
行业动态也在往这走。vLLM 生态扩得快,SGLang 在前缀缓存和结构化输出上很活跃,TensorRT-LLM 吃 NVIDIA 全家桶的红利。云厂商卷推理实例,芯片厂商卷 FP8 和互联。模型侧也没闲着:GQA、MLA、MoE、线性注意力、稀疏注意力,全在给推理减负。
说到底,大模型推理优化不是某个单点魔法。它是显存管理、调度策略、数值格式、模型结构、硬件拓扑一起拧螺丝。哪颗螺丝松了,账单都会教你做人。别急着追新框架,先把 KV Cache 和调度看明白。真的,省下来的钱,比换个模型版本实在多了。