系统可靠性设计,别先堆冗余:从失效物理到数字孪生的硬仗
先别急着上双电源、三模冗余。真的。我见过太多项目,原理图一打开,备份一堆,热却压不住,接插件选型也随意。现场返修率照样难看。系统可靠性设计这事,很多时候不是“加什么”,而是“先弄清楚会怎么坏”。
我特别怕一种讨论:一上来就问“冗余几重”。这就像房子漏水,先买三台抽水机,却不查管子在哪裂。FMEA、FTA这些老工具,别嫌土。真做细,能把单点失效、潜伏失效、交叉失效一条条翻出来。尤其是新器件、新工艺,失效物理没吃透,冗余只会把问题藏得更深。
别急着加备份,先把失效路径摸清楚
科研项目里这两年很热的一个方向,是把失效物理模型、加速寿命试验和数字孪生绑在一起。说白了,就是别等坏了再猜。功率模块在热循环下焊层怎么裂,连接器在振动下接触电阻怎么飘,电解电容在纹波电流下寿命怎么掉,这些都能建模。Arrhenius模型、Coffin-Manson模型不新,但跟在线数据一融合,味道就变了。
不过话说回来,模型不是护身符。参数拍脑袋,仿真再漂亮也白搭。我见过报告里写“预计寿命十五年”,一问试验剖面,只有常温满载。这就有点自嗨了。可靠性增长试验、HALT、现场返回件分析,得形成闭环。数据不回流,设计部门永远觉得自己挺稳。
 服务器主板电源冗余设计实拍图
可靠性不是测出来的,是设计进去的。这句话听着像口号,做起来全是细节。降额够不够,热裕量够不够,容差分析做没做,维修性有没有考虑。还有MTBF,真别把它当寿命。指数分布假设一摆,很多现场问题就被平均掉了。用户骂人的时候,可不管你的平均值。
降额、热和EMC:老三样仍然最要命
现在行业热词多。SiC、GaN、chiplet、AI加速卡,功率密度往上蹿。热设计稍微松一点,结温就敢给你看脸色。电热联合仿真这几年很实用,芯片、封装、PCB、散热器一起算,别各算各的。器件的降额曲线也别只看厂家首页,得看应用条件。电容尤其是重灾区,纹波、温度、寿命,三个一叠加,故障率很难看。
EMC也是。很多系统可靠性设计栽在“偶发复位”上。实验室过认证,现场却抖。线束走向、接地、屏蔽、滤波,样机阶段嫌麻烦,量产就等着救火。说真的,热和EMC的裕量,是最不该抠的成本。抠下来的那点钱,售后一趟出差就还回去了。
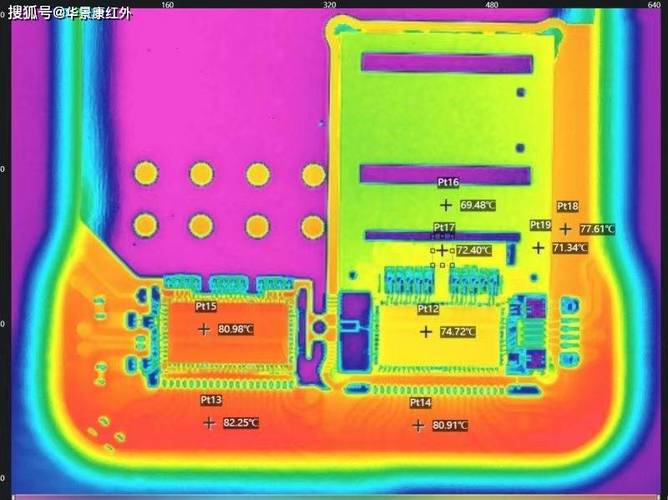 芯片结温热红外成像可靠性测试图
冗余不是万能药,共因失效专治不服
 冗余不是万能药,共因失效专治不服
冗余当然有用。电源冗余、控制器冗余、通信冗余,关键场合该上就上。但冗余设计有几个坑,特别深。第一,切换逻辑要真能切。第二,故障检测覆盖率要够。第三,共因失效要算。雷击、粉尘、温升、软件bug、同一批次的器件缺陷,都可能让两套备份一起躺。beta因子不是论文里的装饰,工程上得认真估。
汽车电子讲ISO 26262,工业控制讲IEC 61508,底层逻辑都绕不开诊断覆盖率和安全完整性。数据中心也一样,双路供电做得漂亮,末端切换装置卡死,照样掉电。冗余不是堆数量,是把失效模式、检测时间、切换时间、维修策略一起算账。这话不好听,但省事。
软件和系统级:混沌工程别变成表演
 软件和系统级:混沌工程别变成表演
软件可靠性更玄。内存泄漏、时序竞争、异常恢复、升级回滚,哪个都能让硬件背锅。故障注入是个好办法,混沌工程也是。但别搞成表演:挑几个无关紧要的服务停一停,拍个视频,写个复盘,完了。真要测,就盯着关键链路,盯着恢复时间,盯着数据一致性。可观测性得先做好,不然连故障现场都留不下。
这两年PHM和数字孪生在科研圈很热,产业界也在试。我的看法是,先有可信的数据,再谈智能预警。传感器装一堆,标定稀里糊涂,模型天天报警,运维人员三天就把它关了。可靠性增长要靠闭环:现场失效、失效分析、设计更改、再验证。贝叶斯方法可以帮忙更新认知,但前提是数据别造假。
所以,系统可靠性设计别从“堆冗余”开始。先算失效,再做降额和热设计,再谈冗余和诊断,最后用试验和现场数据把模型拽回地面。这个顺序反了,后面全是补丁。补丁多了,系统看着壮,其实更脆。