当模型先查资料:检索增强生成的工程真相与边界
一个常见误判是,把检索增强生成等同于给模型外挂一个向量库。不够。它更像一条知识供应链:文档怎么来、怎么切、怎么索引、怎么召回、怎么重排、怎么塞进上下文、怎么约束回答、怎么追溯引用。任何一环塌陷,最后都会表现为“模型胡说”。演示视频常把这条链藏起来,只留下一个漂亮问答框。说实话,这块常被掩盖。
问题不在搜到,而在搜对之后怎么用
检索增强生成的核心不是“检索”这个动作,而是把外部证据转化为可约束的生成条件。用户问题先被改写,可能拆成多跳子问题;检索器在倒排索引、向量索引或混合索引中召回候选;重排器按相关性、时效、权限、来源可信度重新排序;上下文构造器决定哪些片段进入提示词;生成器被要求基于证据回答,必要时拒答或标注引用。这里有一个常被忽略的反例:引用不等于忠实。模型可以引用一段真实文档,却给出文档不支持的结论。更麻烦的是,检索到的证据彼此冲突时,模型倾向于用流畅叙述抹平矛盾,而不是暴露冲突。
 检索增强生成系统查询改写与多路召回架构图
适用条件也要说清。开放域长尾知识、企业私有文档、强时效政策、需要来源追溯的场景,外部检索有优势。反过来,任务主要依赖语言风格、格式迁移或已内化常识,检索可能只增加延迟和噪声。延迟敏感的高频问答,缓存和轻量微调有时更划算。长上下文模型能吞下更多材料,但能放进去不等于能用好:注意力稀释、位置偏差、成本上升都会出现。短文档、单跳问题,简单拼接可能够用;多跳、跨表格、跨版本问题,才需要更复杂的检索编排。
切分与重排:常被低估的脏活
文档切分看似机械,实际决定召回粒度。切得太碎,语义不完整;切得太长,噪声稀释向量。父子块、滑动窗口、标题层级、表格行列结构、脚注和版本号,都会影响结果。嵌入模型不是语义万能钥匙,专有名词、编号、缩写经常需要BM25类稀疏检索兜底。混合检索加重排,通常比单一向量召回稳,但重排模型有成本和延迟,候选太多会拖垮线上服务。权限过滤尤其要前移:召回阶段就应剔除无权文档,不能等生成后再删敏感句。检索文档还可能携带提示注入,攻击者把指令藏进网页或PDF,模型若不加区分地服从,就会绕过系统约束。
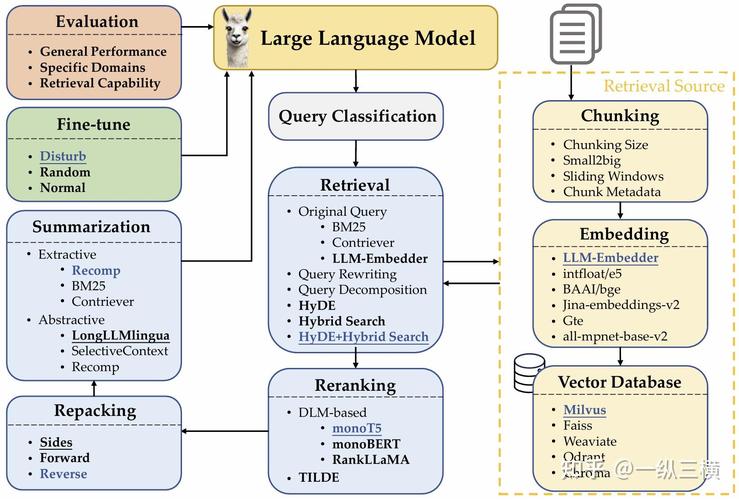 大语言模型RAG文档切分父子块与重排序流程图
上下文构造也有取舍。把所有高分片段堆进去,容易让模型在重复信息中迷失;只给一条证据,又可能漏掉限定条件。较稳的做法是保留来源、时间、章节路径和冲突标记,让生成器知道证据的边界。这里没有银弹。工程上更可靠的是可观测的检索链路:记录查询改写、召回分数、重排理由、最终上下文和引用映射,出问题时能定位是检索错、排序错还是生成错。
评估别只看答案像不像
 评估别只看答案像不像
答案流畅,不代表链路健康。评估至少要拆开看:检索侧看召回率、上下文精确率、难负例误召;生成侧看忠实性、答案相关性、引用支持度、拒答是否恰当;系统侧看延迟、成本、权限泄漏和注入成功率。人工评估贵,但关键样本不能省。用模型当裁判可以扩规模,却要校准偏差,尤其是长答案和带引用答案。测试集要覆盖版本冲突、表格问答、多跳问题、无答案问题。短句:别只看像不像。端到端A/B和线上日志同样重要,用户点开引用、继续追问、纠正答案,都是信号。
边界与风险:它不是外挂知识库的万能胶
风险往往不在模型参数里,而在知识供应链上。过期文档、版权不明内容、隐私字段、错误权限、恶意注入、虚假来源,都会顺着检索进入回答。知识冲突时,系统需要版本优先级和来源可信度规则,不能把判断全推给生成器。多模态和结构化数据会继续扩展RAG的边界:图表、报表、工单、代码库,单靠文本切分不够,需要结构化查询与图关系检索配合。趋势上,agentic检索、多跳规划、图增强、可验证引用都在推进,但工程落地仍要回到数据治理和评估闭环。否则模型越强,错误越自信。RAG的尽头不是更花哨的检索器,而是可审计的知识供应链。