近存计算:别再把数据搬来搬去了,真的搬不动了
先看一个尴尬的场面。GPU风扇狂转,HBM温度飙升,结果呢?算力单元在等数据。等得花儿都谢了。这个场景在AI推理里太常见了。大模型每吐一个token,权重得从内存里读一遍。带宽不够,能效更不够。于是近存计算又被拎出来了——不是新概念,但这回真有点挡不住。
 近存计算DRAM存内计算架构对比示意图
我见过一些方案,把ALU塞进DRAM bank旁边,做GEMV这种向量矩阵乘。为什么盯上GEMV?因为大模型推理的decode阶段,每生成一个token都要和权重矩阵做一次向量乘。数据量大,复用低。传统CPU/GPU得把权重从DRAM搬到缓存,再搬到寄存器。搬来搬去,能量全耗在线上。有研究给过数字:在先进工艺下,从DRAM读一次数据的能耗可能比一次浮点运算高两个数量级。这个账一算,近存计算就不是“锦上添花”,而是“被逼上梁山”。
不过话说回来,近存计算不是万能药。它解决带宽和能效,但带来编程模型、精度、散热、良率一堆麻烦。别听某些PPT吹得天花乱坠。真的。
 三星HBM-PIM近存计算封装截面示意图
但别急着鼓掌。HBM-PIM的算力密度和通用性怎么平衡?bank级计算单元面积小,能做的运算有限。精度呢?模拟存内计算受工艺偏差影响大,做推理还行,做训练就头疼。编程生态更是硬骨头。CUDA那一套太成熟了,你让算法工程师重新写kernel?难。所以产业界现在更现实的路径是:先做特定算子加速,比如GEMV、注意力里的某些步骤,做成库或者指令,别一上来就颠覆。
这一点很关键。近存计算要想落地,得“偷偷”嵌进去。用户无感,性能提升。而不是让开发者重新学一门语言。对吧?
 3D堆叠DRAM近存计算TSV硅中介层结构图
但散热是个大坑。HBM本来就热,你再塞计算单元进去,热密度更高。良率也头疼。堆叠层数越多,测试越难。成本更别说了。所以近存计算不会一夜之间替代GPU。它更像是“异构计算”里的一个专有加速器。CPU管逻辑,GPU管吞吐,近存计算管那些“搬数据比算数据还贵”的活儿。
 科研前沿:从DRAM-PIM到模拟存内计算
学术界这两年很猛。ISCA、MICRO、HPCA上,PIM相关论文一抓一把。有做DRAM bank内SIMD的,有做bank间通信优化的,有做编译器自动映射的。UPMEM那套PIM-DRAM已经商用了,虽然编程模型还是有点劝退。SRAM-CIM在边缘AI上很热,因为SRAM快、工艺成熟,但面积大。RRAM-CIM密度高,但器件一致性还得磨。模拟计算精度不够?那就做混合方案,模拟做粗算,数字做精算。
这里有个容易被忽略的点:近存计算不只是硬件问题。数据布局、算子切分、调度策略,全都得跟着变。你把ALU放到内存旁边,数据怎么分块?bank间怎么同步?编译器怎么知道该把哪段代码扔过去?这些都是硬骨头。有些论文只跑仿真,流片之后性能掉一半。正常。别迷信论文里的数字。
说真的,我挺看好近存计算在推理侧的机会。训练侧暂时别想太多。推理对精度容忍度高,算子相对固定,批量也大。大模型推理成本现在压得这么狠,谁能把每token的能耗降下来,谁就有戏。但别指望它取代HBM。它更像是HBM的“补丁”,把最堵的那段路拓宽。
最后吐槽一句:别再把近存计算当成新概念炒了。上世纪90年代就有PIM的讨论。现在火,是因为AI把内存墙撞得更疼了。技术路线还没收敛,产业界还在试错。对工程师来说,这是好事——有活儿干。对投资人来说,得擦亮眼。对普通用户来说,你只需要知道:以后你的手机、你的推理卡,可能偷偷用上了近存计算。而你根本感觉不到。这就对了。
别把近存计算和存内计算混成一锅粥
说实话,这俩词经常被营销文案揉在一起。近存计算(Near-Memory Computing)是把计算单元放到内存旁边,物理距离缩短,数据少走几步路。存内计算(In-Memory Computing)更激进,直接在存储阵列里做运算,比如SRAM、RRAM里的模拟计算。近存计算改的是“位置”,存内计算改的是“结构”。对吧?一个像把厨房搬到菜市场旁边,一个像在菜摊上直接炒菜。两回事。学术界也分得清:PIM(Processing-in-Memory)常被当成大伞,近存计算和存内计算都在伞下。近存计算DRAM存内计算架构对比示意图
我见过一些方案,把ALU塞进DRAM bank旁边,做GEMV这种向量矩阵乘。为什么盯上GEMV?因为大模型推理的decode阶段,每生成一个token都要和权重矩阵做一次向量乘。数据量大,复用低。传统CPU/GPU得把权重从DRAM搬到缓存,再搬到寄存器。搬来搬去,能量全耗在线上。有研究给过数字:在先进工艺下,从DRAM读一次数据的能耗可能比一次浮点运算高两个数量级。这个账一算,近存计算就不是“锦上添花”,而是“被逼上梁山”。
不过话说回来,近存计算不是万能药。它解决带宽和能效,但带来编程模型、精度、散热、良率一堆麻烦。别听某些PPT吹得天花乱坠。真的。
HBM-PIM、AiMX、UPMEM:产业界在试什么
三星的HBM-PIM是个典型。把计算单元放进HBM堆栈的每个DRAM bank附近,做并行处理。SK海力士的AiMX更偏加速卡形态,瞄准大模型推理。UPMEM走的是另一条路,在DRAM里加处理单元,做可编程的近存加速。美光也在看存内计算和近存计算的结合。国内也有团队在做DRAM-PIM、SRAM-CIM的芯片流片。热闹。三星HBM-PIM近存计算封装截面示意图
但别急着鼓掌。HBM-PIM的算力密度和通用性怎么平衡?bank级计算单元面积小,能做的运算有限。精度呢?模拟存内计算受工艺偏差影响大,做推理还行,做训练就头疼。编程生态更是硬骨头。CUDA那一套太成熟了,你让算法工程师重新写kernel?难。所以产业界现在更现实的路径是:先做特定算子加速,比如GEMV、注意力里的某些步骤,做成库或者指令,别一上来就颠覆。
这一点很关键。近存计算要想落地,得“偷偷”嵌进去。用户无感,性能提升。而不是让开发者重新学一门语言。对吧?
内存墙不是一堵墙,是一排收费站
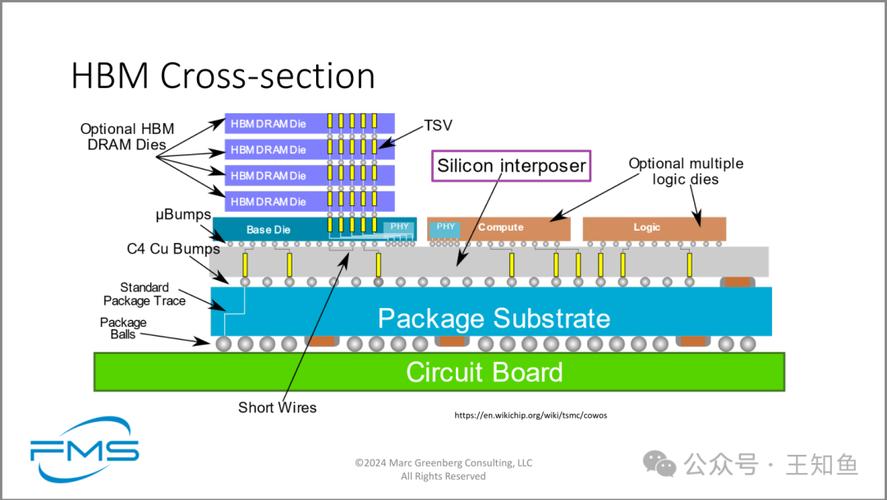
很多人把内存墙说成一堵墙。我觉得更像一排收费站。你每搬一次数据,交一次费。缓存层级越多,收费站越密。近存计算干的事,是把收费站往前挪,甚至拆掉几个。CXL、HBM、3D堆叠、硅中介层,这些封装技术都在给近存计算铺路。TSV把DRAM层和逻辑层连起来,带宽上去了,距离下来了。2.5D封装把HBM和GPU放一块,已经量产。下一步是把计算单元再往内存里塞一点。3D堆叠DRAM近存计算TSV硅中介层结构图
但散热是个大坑。HBM本来就热,你再塞计算单元进去,热密度更高。良率也头疼。堆叠层数越多,测试越难。成本更别说了。所以近存计算不会一夜之间替代GPU。它更像是“异构计算”里的一个专有加速器。CPU管逻辑,GPU管吞吐,近存计算管那些“搬数据比算数据还贵”的活儿。
科研前沿:从DRAM-PIM到模拟存内计算
科研前沿:从DRAM-PIM到模拟存内计算
学术界这两年很猛。ISCA、MICRO、HPCA上,PIM相关论文一抓一把。有做DRAM bank内SIMD的,有做bank间通信优化的,有做编译器自动映射的。UPMEM那套PIM-DRAM已经商用了,虽然编程模型还是有点劝退。SRAM-CIM在边缘AI上很热,因为SRAM快、工艺成熟,但面积大。RRAM-CIM密度高,但器件一致性还得磨。模拟计算精度不够?那就做混合方案,模拟做粗算,数字做精算。
这里有个容易被忽略的点:近存计算不只是硬件问题。数据布局、算子切分、调度策略,全都得跟着变。你把ALU放到内存旁边,数据怎么分块?bank间怎么同步?编译器怎么知道该把哪段代码扔过去?这些都是硬骨头。有些论文只跑仿真,流片之后性能掉一半。正常。别迷信论文里的数字。
说真的,我挺看好近存计算在推理侧的机会。训练侧暂时别想太多。推理对精度容忍度高,算子相对固定,批量也大。大模型推理成本现在压得这么狠,谁能把每token的能耗降下来,谁就有戏。但别指望它取代HBM。它更像是HBM的“补丁”,把最堵的那段路拓宽。
最后吐槽一句:别再把近存计算当成新概念炒了。上世纪90年代就有PIM的讨论。现在火,是因为AI把内存墙撞得更疼了。技术路线还没收敛,产业界还在试错。对工程师来说,这是好事——有活儿干。对投资人来说,得擦亮眼。对普通用户来说,你只需要知道:以后你的手机、你的推理卡,可能偷偷用上了近存计算。而你根本感觉不到。这就对了。