小样本学习:当AI不再需要百万级数据喂饱
大模型落地的隐形门槛
预训练大模型的泛化能力看起来很强,真要落去具体场景,比如制药公司要识别某种新合成化合物的晶体结构,比如车企要识别厂区里罕见的违规闯入物,哪来几十万张标注好的训练数据?罕见病的临床影像,全世界加起来都未必过千,分到每个亚型,能拿出来的标注样本可能两位数都不到。靠堆数据堆出来的大模型,到这直接卡壳。
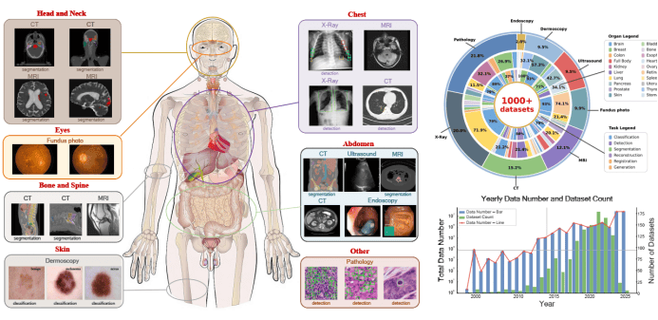 医学领域小样本罕见病影像数据集
很多人说那用预训练模型微调啊。微调也得要不少样本才行,十几个样本调出来的模型,泛化性差到离谱,换个设备拍的图都认不出来。这才把那个概念推到了台前。 不是说大模型不好,是大模型的天生优势,在低资源领域根本施展不开。你有你的百万级数据集,我只有我的十几个标注样例,难道就不做AI了?
核心逻辑:学会“学习”比学会任务更重要
很多人以为这是近几年大模型带火的新概念,不对。早在上世纪90年代就有相关研究,核心思路从一开始就没变过:不让AI直接学具体任务,而是让AI先学怎么从少量样本里找规律,也就是业内常说的元学习。现在出圈的大模型上下文小样本学习,本质上也是预训练阶段学到的元能力的体现。
核心的突破其实发生在表征层面。现在主流的路径,本质上都是做跨任务特征空间对齐。什么意思?就是不管你要学什么新任务,都把新样本的特征映射到模型已经熟悉的特征空间里,只要找到相似的已有特征,就能完成分类或者预测,不需要重新学一套参数。
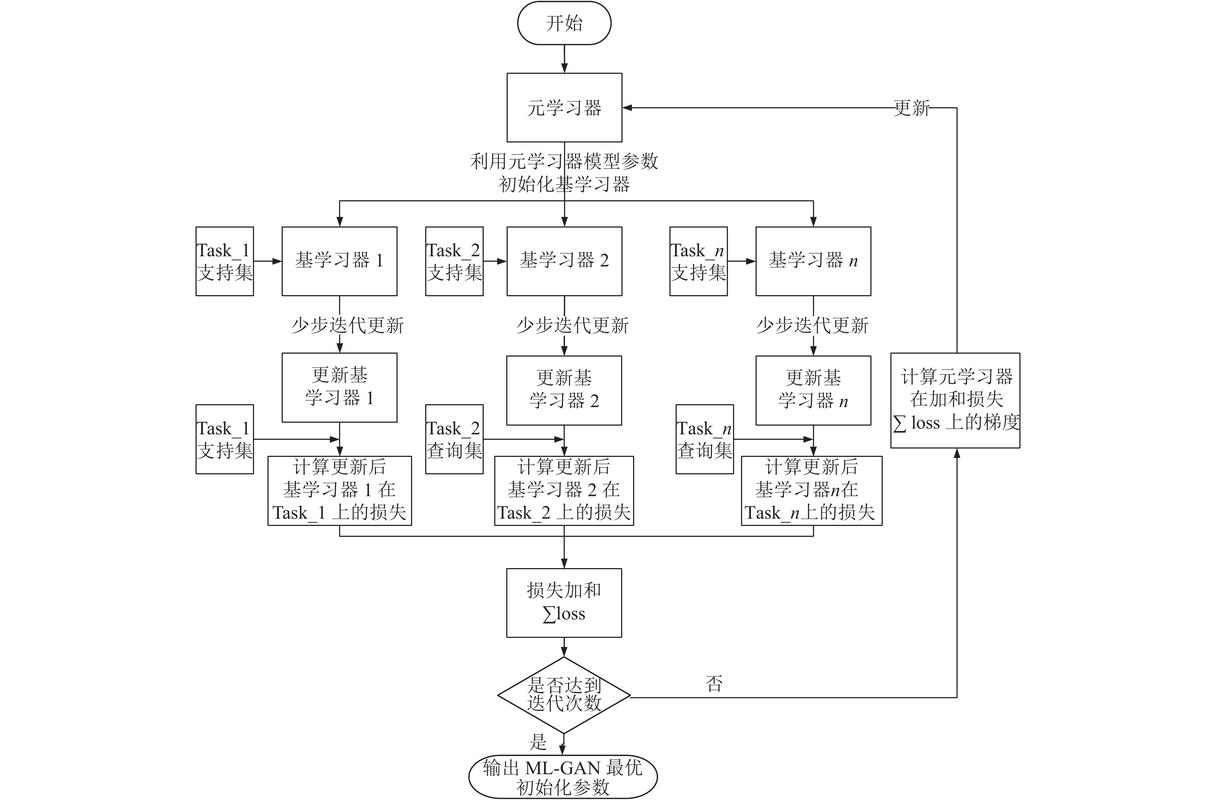 小样本元学习训练任务分布示意图
常见的实现路径有几种,一种是基于模型微调的,通过元训练调整模型初始化参数,让模型只需要几步梯度更新就能适配新任务;一种是基于度量的,直接计算新样本和支撑集样本的特征距离,最近邻分类就出结果,不需要改参数;还有就是现在大模型常用的,把少量样本拼接到prompt里,靠大模型预训练学到的泛化能力直接输出结果。
不过话说回来,这三种路径各有各的限制。基于度量的,对支撑集样本的分布要求极高,只要有一个样本标注错了,整个结果就歪了。基于微调的,在元分布和新任务差异大的时候,效果直接跳水。大模型上下文小样本呢,样本一多就塞不下上下文窗口,而且逻辑复杂的任务,给十个样本都未必能理清楚规则。
被夸大的能力,没填上的坑
 被夸大的能力,没填上的坑
现在行业里最常见的误导,就是把预训练阶段用到的大量通用数据不算成数据,说自己只需要10个样本就能搞定任务。说实话,这不就是偷换概念吗?没有预训练阶段几千万几亿的文本或者图像数据打底,哪来的泛化能力?10个样本只是最后推理阶段用到的标注样本,把前面的预训练数据吃了不说,只说最后这一步,骗外行而已。
第一个绕不开的边界就是分布偏移的天花板。如果新任务的特征分布,和模型在元训练或者预训练阶段见过的分布差太远,哪怕给你十个样本,也出不来能用的结果。举个例子,你用互联网上爬的千万张普通动物图片做元训练,让模型学识别三种新发现的深海虾类,每个给三张标注图,模型大概率会把三个类分成两类,因为它的特征空间里根本没有深海生物的肢体结构特征,对齐都对齐不上,怎么学都不对。
第二个边界,就是对噪声的鲁棒性极差。大样本学习里,几个错标样本根本不影响大局,模型靠大量数据就能把错误平滑掉。在这里不一样,总共就十个标注样本,错一个就是十分之一的误差,整个模型的判断逻辑直接偏了。哪怕你用最先进的大模型做上下文学习,放一个错误的样例进去,模型就会顺着错误学,输出全错。
还有现实层面的风险,比如现在很多行业用它来做决策辅助,医疗领域用小样本训练的罕见病诊断模型,一旦错判,代价就是患者的治疗时机,这个风险现在还没有很好的应对方案。毕竟样本太少,连做误差分析的足够数据都没有,出了错都不知道是为什么。
当然,不能一棒子打死。它确实解决了很多过去解决不了的落地问题。比如文创领域,要训练一个模型学习某个已故设计师的风格,设计师留下来的作品本来就不多,总不能为了训练模型让别人重新画几百张吧?这种场景下,十几个样本就能出个能用的模型,已经帮了大忙了。比如古籍修复里,识别某个馆藏孤本里的特殊字体,总共就能拿到几十页标注样本,用这个思路做出来的模型,比传统方法准太多。
未来的方向,现在看主要是两个,一个是和开放世界大模型结合,进一步压缩对标注样本的需求,一个是和主动学习结合,让模型自己选最有价值的样本去标注,进一步降低标注成本。只是现在这个概念被炒得太凶,太多人拿着它当圈钱的幌子,反倒把真正做研究的声音盖住了。路还很长,远没到收割的时候。