多模态对齐:为什么大模型离真正“看懂世界”还差这一步
上个月跟做多模态预训练的发小撸串,他喝了两瓶冰啤酒之后拍桌子吐槽,说现在圈内90%对外宣传的多模态大模型,都是“伪对齐”。我当时夹着烤五花肉的手都停了。
什么叫伪对齐?就是看起来能答能说,骨子里根本没把不同模态的信息对上号。
你不信可以自己测,找一张背景复杂点的生活照,问它某个角落的小物件是什么,十个模型有八个能给你瞎说八道。
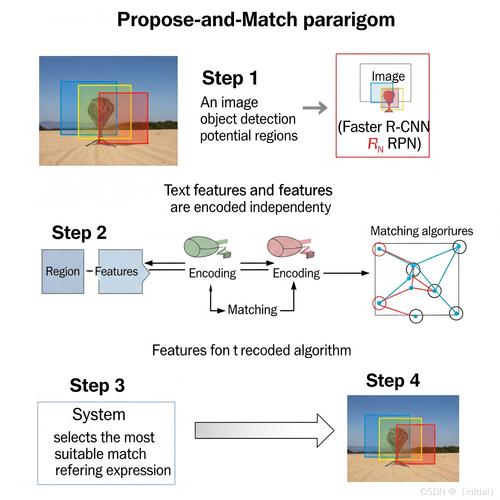 多模态对齐错误示例对比图
说实话,这种情况太常见了。很多顶会论文里刷出来的SOTA指标,换一批非公开的野生测试图,准确率直接掉三分之一。为什么?因为训练集都是规整好的配对数据,对齐都是在规整数据里练出来的,到了真实开放场景,直接露馅。
挺扯的。真不是吹毛求疵,连实体位置都对不准,谈什么理解世界?
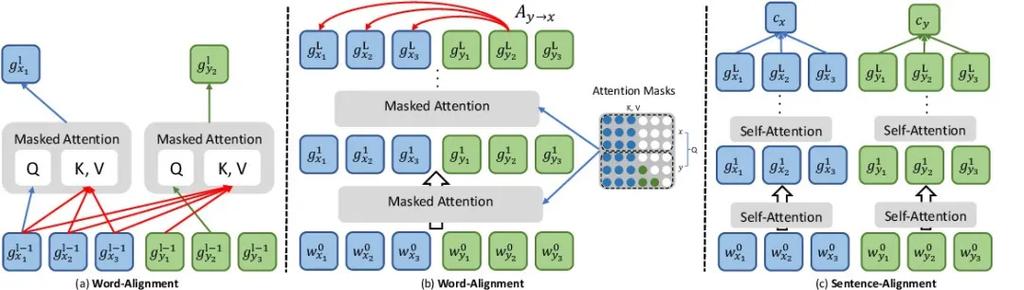 多模态共同隐空间对齐示意图
不过话说回来,最影响落地的还是静态对齐的问题。现在绝大多数模型都是预训练的时候一次性对齐完,推理的时候就不再调了。可用户的问题是动态的啊,同一张图,你问“图里有几个人”和问“最左边那个人衣服上的logo是什么”,需要对齐的粒度和区域完全不一样。静态对齐怎么可能适配所有问题?对不准太正常了。
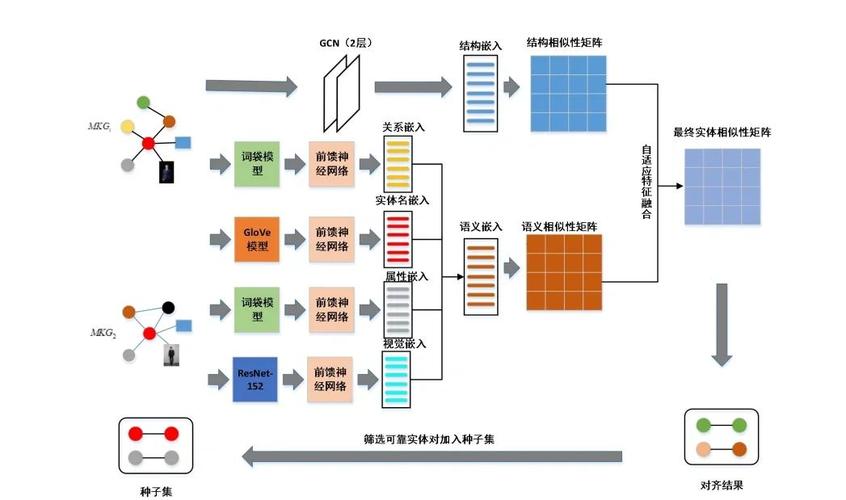 多模态对齐的下一步,正在发生什么变化
现在GPT-4V带火了端侧多模态,国内不管是大厂还是创业团队,都在攒自己的多模态大模型,所有人都盯着对齐这块,因为这才是真正的壁垒。你对齐做不好,产品体验就是差,用户用一次就再也不用了。
我最近看了几篇新出的预印本,还有几个大厂内部朋友透的方向,已经有挺有意思的突破了。
一个方向是语义引导的动态对齐,简单说就是模型不再预训练完就固定对齐结果,拿到用户的问题之后,先把问题拆成一个个语义节点,再根据每个语义节点去其他模态找对应的区域做对齐,问题变了对齐的方式跟着变。比如用户问logo,模型就自动把对齐粒度调到衣服那块的局部,问有几个人就调到全局的实体检测粒度。我看到的测试结果,这个思路在野生测试集上把准确率提了快20%,挺惊喜的。
还有一个方向是把对齐和推理合并,不再分“预训练对齐-下游推理”两步走,每一步推理都实时调整对齐结果,错了马上修正。相当于你找东西的时候,找一步看一步,不对就换地方找,比一次性找完放在那准多了。
另外还有弱对齐的思路,用大模型已经学到的世界知识,来引导不同模态对齐,不需要那么多标注的配对数据,成本降了一大块,泛化性还更好,碰到训练集里没有的新实体,对齐准确率也掉得没那么多。
现在很多人吹多模态多么成熟,我就笑笑。很多创业公司拿开源模型改改prompt,就吹自己做了通用多模态,连对齐关都没过,就出来圈钱。真的没意思。
多模态对齐哪里是个纸面的研究问题?自动驾驶要融合视觉、激光雷达、指令多个模态,对齐错了把障碍物当成广告牌,那是要出人命的。做AI生图,文字和图像对不齐,你说“红色猫蓝色狗”它给你反过来,用户能用?
上次撸串那个发小,说他熬了三个多月,就为了把细粒度对齐的准确率提5个点,天天调数据调loss函数调得掉头发。我那时候突然觉得,真正的技术进步从来都不是喊两句“通用人工智能”的口号就来的,都是这么一点点抠细节抠出来的。
等真正的动态细粒度对齐真的做熟了,我们才能说,大模型真的“看见”这个世界了,而不是对着一堆像素瞎猜。
别被“图文问答”骗了,多数多模态都没真对齐
很多人刷到过短视频里多模态模型的演示,给一张图就能说出来上面有什么,看起来特别神奇。其实扒开底裤看,大部分模型只是学会了抓关键词匹配,根本没做到同一语义跨模态对齐。 什么是多模态对齐?说白了,就是让文字、图像、语音这些完全不同格式的信息,都映射到同一个语义空间里。提到“杯子”,不管是文字写的“杯子”,还是图像里角落那个半露的杯子,还是语音说的“那个杯子”,都要对应到同一个语义点上。 对不上会怎么样?就是我刚才说的,瞎蒙。我上个月拿某头部厂商的开放多模态接口做测试,给了一张奶茶店柜台的实拍图,问“站在收银台后面的人,左手边堆的杯套是什么颜色”,模型一口答“红色”。实际上那堆杯套是米白色,红色的杯子在收银台前面,完全是两个位置。 它错在哪?就是把“杯套”的语义,错误对齐到了图里另一个红色物体上,根本没搞清楚我说的位置对应图里哪块区域。多模态对齐错误示例对比图
说实话,这种情况太常见了。很多顶会论文里刷出来的SOTA指标,换一批非公开的野生测试图,准确率直接掉三分之一。为什么?因为训练集都是规整好的配对数据,对齐都是在规整数据里练出来的,到了真实开放场景,直接露馅。
挺扯的。真不是吹毛求疵,连实体位置都对不准,谈什么理解世界?
现在的对齐方案,到底卡在哪了
多模态对齐研究快小十年了,从最早的有监督配对对齐,到CLIP带火的对比学习对齐,再到现在细粒度对齐,每一步都有进步,但还是绕不开几个核心的坑。 最早的方案是攒一批标注好的图文配对数据,逼着模型把同一张图和对应的文本往一块拉。这个方法太笨了。标注一对多模态数据成本顶得上十段文本,攒一百万对就得烧几千万,你还覆盖不了所有实体所有场景。开放世界里天天有新东西出来,你总不能天天标注吧? 后来对比学习出来,CLIP那种不需要精细标注,只要知道图和文本对应就行,把同配对的图文拉近距离,不同配对的推开,一下子把对齐成本降下来了,效果也提升了。但是CLIP的对齐是粗粒度全局对齐,它只对齐整张图和整段话的整体相似度,你要找某个局部的小实体,它就懵了。就像你把一堆水果装一个箱子里,告诉模型“这箱对应水果两个字”,模型只知道箱子对应水果,不知道箱子里哪个位置是苹果哪个是香蕉。 最近两年大家都在做细粒度对齐,思路是对的,但是又撞上了模态固有偏差的墙。文字是抽象的,图像是具体的,你怎么把“好喝”这种很主观的抽象概念,对齐到几百种不同口味不同包装的奶茶上?训练集里的“好喝”都是配网红奶茶的图,换一杯家里泡的茶,模型可能就对不上“好喝”这个概念了。多模态共同隐空间对齐示意图
不过话说回来,最影响落地的还是静态对齐的问题。现在绝大多数模型都是预训练的时候一次性对齐完,推理的时候就不再调了。可用户的问题是动态的啊,同一张图,你问“图里有几个人”和问“最左边那个人衣服上的logo是什么”,需要对齐的粒度和区域完全不一样。静态对齐怎么可能适配所有问题?对不准太正常了。
多模态对齐的下一步,正在发生什么变化
多模态对齐的下一步,正在发生什么变化
现在GPT-4V带火了端侧多模态,国内不管是大厂还是创业团队,都在攒自己的多模态大模型,所有人都盯着对齐这块,因为这才是真正的壁垒。你对齐做不好,产品体验就是差,用户用一次就再也不用了。
我最近看了几篇新出的预印本,还有几个大厂内部朋友透的方向,已经有挺有意思的突破了。
一个方向是语义引导的动态对齐,简单说就是模型不再预训练完就固定对齐结果,拿到用户的问题之后,先把问题拆成一个个语义节点,再根据每个语义节点去其他模态找对应的区域做对齐,问题变了对齐的方式跟着变。比如用户问logo,模型就自动把对齐粒度调到衣服那块的局部,问有几个人就调到全局的实体检测粒度。我看到的测试结果,这个思路在野生测试集上把准确率提了快20%,挺惊喜的。
还有一个方向是把对齐和推理合并,不再分“预训练对齐-下游推理”两步走,每一步推理都实时调整对齐结果,错了马上修正。相当于你找东西的时候,找一步看一步,不对就换地方找,比一次性找完放在那准多了。
另外还有弱对齐的思路,用大模型已经学到的世界知识,来引导不同模态对齐,不需要那么多标注的配对数据,成本降了一大块,泛化性还更好,碰到训练集里没有的新实体,对齐准确率也掉得没那么多。
现在很多人吹多模态多么成熟,我就笑笑。很多创业公司拿开源模型改改prompt,就吹自己做了通用多模态,连对齐关都没过,就出来圈钱。真的没意思。
多模态对齐哪里是个纸面的研究问题?自动驾驶要融合视觉、激光雷达、指令多个模态,对齐错了把障碍物当成广告牌,那是要出人命的。做AI生图,文字和图像对不齐,你说“红色猫蓝色狗”它给你反过来,用户能用?
上次撸串那个发小,说他熬了三个多月,就为了把细粒度对齐的准确率提5个点,天天调数据调loss函数调得掉头发。我那时候突然觉得,真正的技术进步从来都不是喊两句“通用人工智能”的口号就来的,都是这么一点点抠细节抠出来的。
等真正的动态细粒度对齐真的做熟了,我们才能说,大模型真的“看见”这个世界了,而不是对着一堆像素瞎猜。