挤干显存每一滴:大模型推理优化的隐形战场
卡住产业落地的那根鱼刺
大模型能训出来,不代表能用起来。
很多团队砸了几千万堆出参数千亿的模型,拿到真实场景一跑,瞬间傻眼。单张A100跑7B参数模型,全精度加载撑死了也就十几个并发,用户端提问完盯着转圈圈,三秒不出结果直接退走。要是赶上个热点请求峰值,服务器分分钟给你报OOM。
算一笔账你就懂了,现在云GPU按小时计费,推理成本占到大模型产品整体运营成本的六成以上。要是优化做不到位,越火亏得越多,根本没有商业化的可能。
过去几年行业的焦点全在训练,抢数据抢参数抢算力,现在才回过神,卡在落地门口的,从来不是训练,是推理。
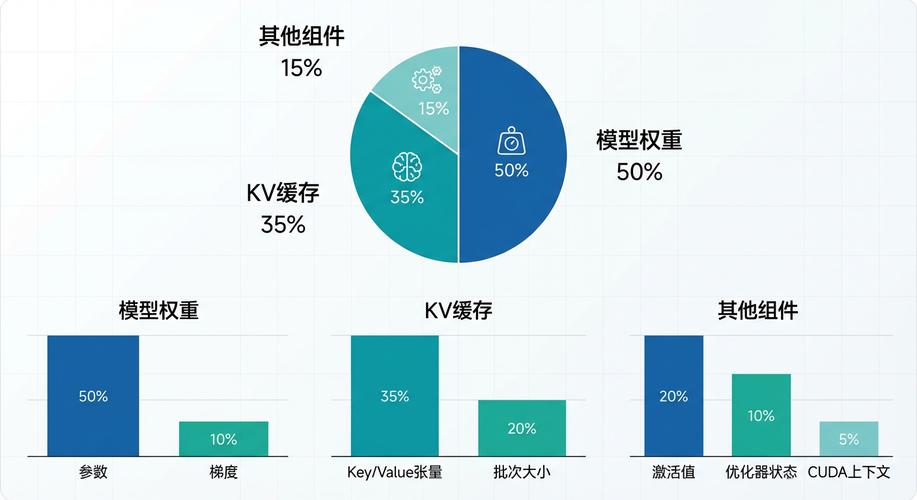 大模型推理部署显存占用对比图
不是所有优化都能落地
现在打开学术网站,随便搜搜能跳出几千篇相关论文,个个都说自己能提速降显存,真拿到实际场景跑,一半以上都不好使。
就说量化,现在圈内开口就是4位、8位量化,仿佛把模型压成低位就能解决一切问题。我上个月帮朋友测过三个不同方案的4位量化7B模型,普通闲聊确实看不出差别,一碰到数学计算、代码生成、低资源语言翻译,准确率掉点能超过十个百分点,甚至有一个算12乘13都能得出146的结果,这不扯吗?
量化不是万能的,它有自己的适用边界。要是你做的是对准确率要求不高的对内客服,低位量化完全够用,要是做医疗报告分析、代码生成,那还是老老实实从别的地方挤性能,别碰太过压缩的量化方案。
再说说热门的投机解码,理论上能把推理速度提一倍,核心是用小模型出草稿,大模型只做验证修改。听起来很美好,对不对?可你得先训一个和大模型分布对齐的小草稿模型,中小团队既没有足够的标注数据,也没有多余的算力折腾,这个方法对他们来说,就是论文里的空中楼阁,看着好,拿不到。
即便是大家都公认有效的KV缓存优化,也不是所有场景都好用。对话场景下每次只生成一个新token,缓存复用能省下大量重复计算,可如果你做的是批量文档预处理,所有token一次性输入,缓存优化能带来的收益微乎其微。
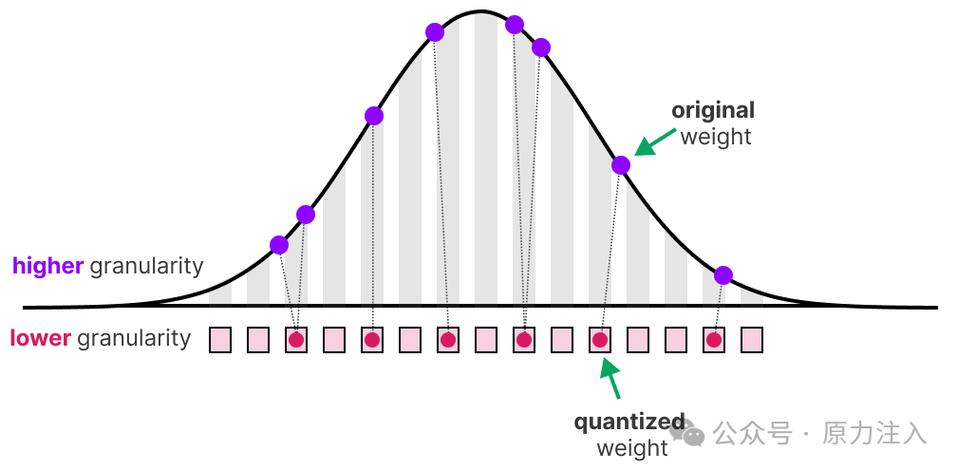 大模型不同量化精度准确率下降对比图
真正能落地的优化,得跨层协同
 真正能落地的优化,得跨层协同
单维度的优化现在已经挖得差不多了,要拿到实实在在的收益,就得从算法模型到系统调度全栈动起来。
最基础的是算子层优化,现在主流推理引擎都会针对不同硬件做算子融合,把多个小算子合并成一个大算子,减少数据搬运的开销。但这里也有坑,不是所有融合都能提性能,有些融合反而会增加寄存器占用,小batch场景下性能反而掉了,得根据你的实际场景调。
再往上是模型架构和推理机制的协同。现在长上下文需求越来越多,几十万上百万token的输入,要是把所有KV都存在显存里,再多显存也不够吃。现在成熟的方案是把KV缓存做成分页换入,不用的块放到内存里,要用的时候再换进来,配合模型本身的滑动窗口注意力,能把长上下文推理的显存占用压到原来的三分之一,成本直接砍半,这个方案现在已经在不少长上下文产品里用了。
很多人容易忽略服务调度层面的优化,其实这里全是能白捡的性能。在线推理场景下,请求从来不是均匀的,有几个字的短对话,也有几万字的长文档总结,要是按先来先服务排队,长请求占满整张卡,短请求全在外面排队,整体平均延迟能翻三倍。现在做动态批处理加优先级调度,把同长度的请求打包处理,给短对话更高优先级,整体吞吐一下子就能提二三十个点,不需要改模型改算子,只要调调服务逻辑就能拿到收益,很多团队居然到现在都没重视。
说实话,现在行业里很多优化都盯着云侧GPU部署,端侧推理的优化逻辑完全不一样。端侧要考虑功耗、内存,不能为了快把手机电干没了,所以得先做结构化剪枝、知识蒸馏把模型本身做小,再配合量化,才能跑起来,这里没有通用方案,得看你的终端设备能给出多少资源。
现在还有很多没填上的坑。多模态大模型的推理优化,现在大部分方案都是针对文本的,图像、音频特征怎么存储调度,还没有成熟的通用方案。过度优化带来的偏见放大问题,也很少有人提,本身大模型对低资源语言、小样本任务的准确率就偏低,量化剪枝之后,掉点最多的恰恰就是这些任务,真到出海或者细分场景用的时候,就是躲不开的大坑。
不过话说回来,大模型要从实验室走到千家万户,本来就是抠抠搜搜挤性能的过程。挤出来的每一兆显存,省下来的每一毫秒延迟,都是用户能摸到的体验提升,也是能算进成本里的真金白银。这个隐形战场,才真正决定大模型能走多远。