藏在稳定背后:系统可靠性设计的隐形陷阱
被低估的耦合性干扰
绝大多数架构故障,本质上都和没拆干净的耦合有关。
很多人做冗余设计的时候,只盯着核心服务的节点数,忘了那些被共享的基础组件。比如说拆库拆表后,十个业务分库共用同一个binlog同步节点,那个节点一磁盘打满,十个库全没法写入,白做了分库。哪怕你给每个核心服务都做了跨可用区的多活部署,只要共享了同一个没做降级的配置入口,一次配置推送的重试风暴就能把所有节点一起拖垮。
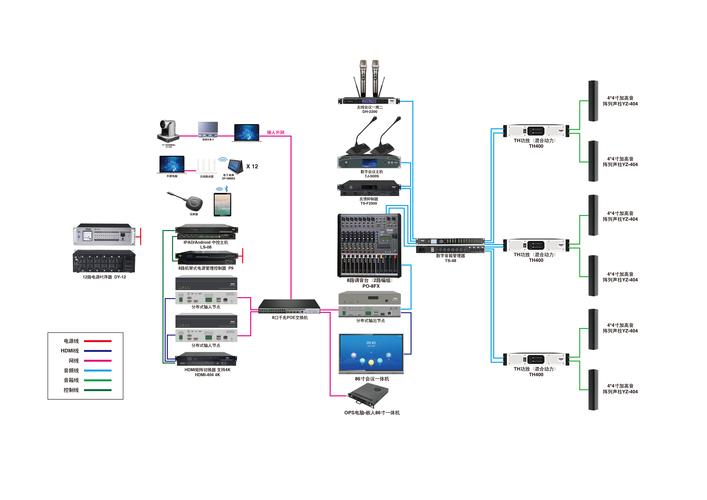 分布式系统跨可用区耦合故障拓扑图
我之前碰过一个电商项目,大促前花了三个月搭三套集群,就为了扛峰值流量,结果上线前一天凌晨,因为配置中心的推送集群是共用的,运维改了一个参数推错版本,全集群一起停服二十多分钟。
谁想得到?
耦合分三种:资源耦合、逻辑耦合、隐式配置耦合。大部分人能看到资源层面的共享,却看不见逻辑里的隐式依赖——比如A服务调用B服务的时候,默认B一定在线,哪怕A做了三倍扩容,B挂了A照样全挂。还有更隐蔽的,不同服务共用同一个业务主键生成规则,主键冲突直接把两个服务的数据都写坏了,这种问题,压测根本测不出来,只有真出问题才会爆。
故障推演的普遍盲区
现在大部分团队都会做故障演练,但十有八九都是走个过场。
演练都是炸个把随机节点,验证一下自动容灾能不能拉起,就算完成任务。没人愿意花时间推演那种概率不到千分之一的极端场景。可实际上,能造成大面积服务中断的,全是这种低概率的极端场景。
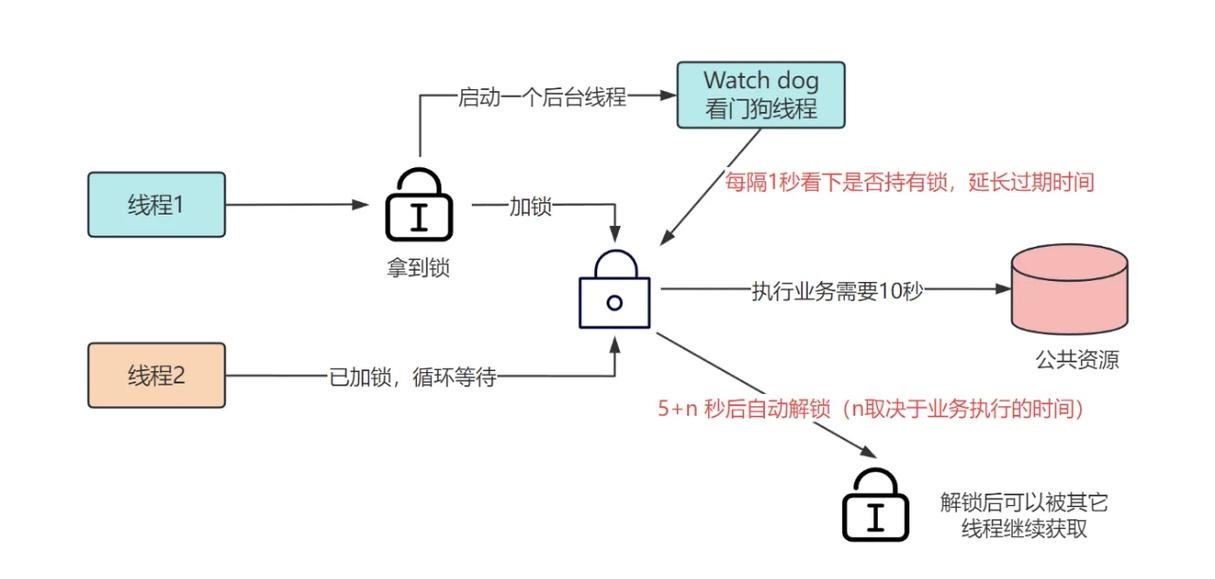 分布式锁时序重叠故障推演示意图
比如说分布式锁的设计,所有人都知道要加超时,可很少有人会测:锁超时释放之后,前一个锁持有者还没执行完写操作,新的持有者拿到锁又开始写,会出现什么情况?数据覆盖,脏写,整个库的一致性直接炸掉。这种时序错误,概率确实低,可只要发生一次,就是灾难性的。
之前某公众熟知的支付故障,根源不过是证书更新的时候,旧证书的撤销时间比新证书的生效时间早了三分钟。整个网关集群找不到可用证书,直接全断。这种时间差的问题,谁会提前放到故障演练里测?
很多人算整体可靠性,习惯把每个节点的可靠性相乘,得出一个很漂亮的数字。这个算法的前提是每个节点的故障是独立的。可实际架构里,故障永远是关联的,时序错一次,再漂亮的可靠性计算结果直接清零。
被神化的可观测性
 被神化的可观测性
这几年可观测性被吹得很厉害,很多团队觉得只要把监控、日志、链路追踪全搭起来,可靠性就有保障了。
可实际上,可观测性只是定位问题的工具,不是解决可靠性问题的解药。我见过很多团队,堆了上万个监控指标,核心调用路径上的关键断点反而没加告警。
比如说有个微服务项目,网关把10%的流量导去了打错标签的灰度实例,那个实例的内网地址根本不存在,监控只报了整体5xx错误率升高,一堆人翻了一个多小时的链路日志才找到根因。要是核心标签校验加个简单告警,五分钟就能定位。
还有更离谱的,把大部分预算都砸在了可观测性平台上,核心服务没留冗余资源,真出问题要回滚,连拉版本镜像的带宽都不够,只能等着慢慢卡。
说实话,很多人陷入了指标迷信:觉得指标越多,可靠性越高。实际上刚好反过来,太多无效指标会把核心告警淹没,真出问题的时候,运维工程师刷几十页告警,根本找不到哪条是关键的。
其实不管什么架构,可靠性永远是和成本绑定的。没有必要追求不存在的100%可靠。面向内部员工的OA系统,一年不到十小时的宕机时间完全可以接受,没必要花几倍成本做多可用区。面向C端的核心交易系统,五个九的可用性都不够,必须抠每一个细节。
不过话说回来,现在很多人追求极致可靠,却忘了最基础的原则:把可能出问题的地方拆隔开,不让一个小故障拖垮整个系统。
AI现在开始介入故障推演,能帮我们枚举很多人类想不到的故障组合,可核心的拆分逻辑,还是要靠人来判断。那些藏在角落的隐式依赖,没被推演过的极端时序,才是真正决定架构稳不稳的东西。