为什么大模型总胡说八道?检索增强生成补脑子的秘密
上周六凌晨两点,我手机炸了。
做电商的发小找我哭,说他刚上线的AI客服,三天赔了小十万。
客人问定制沙发的质保期,AI张嘴就说三年,其实合同上写的是一年。客人组团索赔,他连夜给人退差价,头都大了。
“不是说大模型什么都懂吗?怎么连我自己产品册上的字都能瞎编?”
我给他扔了个方案,加个检索增强生成,也就是圈内常说的RAG,上去。一周后他请我吃火锅,客诉降了九成多。
 大模型电商客服问答幻觉错误示例
就这么个死结,给检索增强生成留了位置。
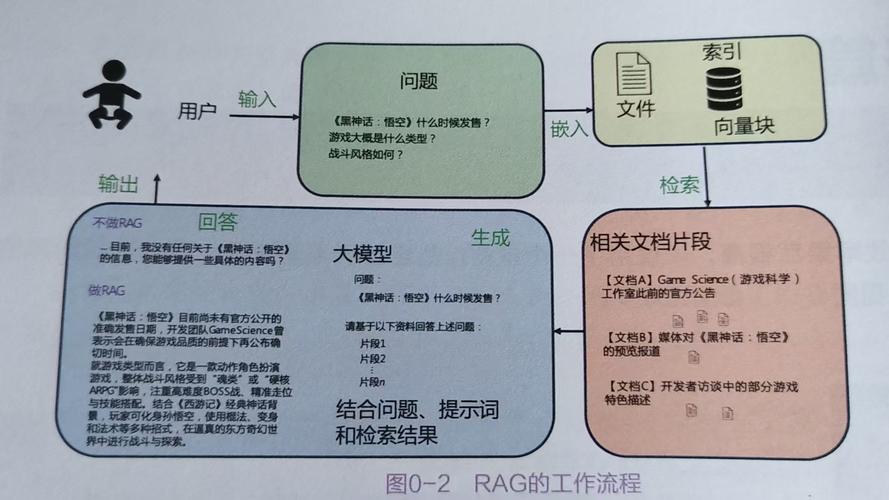 面向大模型问答的检索增强生成工作步骤流程图
我那个发小的沙发客服,就是把所有产品的参数、合同条款都做成了检索库,用户问什么,先找对应的条款,再让大模型组织成口语,再也没出过错。
 别神化,检索增强生成不是包治百病的银弹
现在圈子里把RAG吹得太神了,好像只要加了RAG,大模型的所有问题都解决了。我见过太多团队,上来就搭RAG,花了几十万,最后用起来还不如直接写死的规则好用。
说几个我踩过的坑吧。
第一个坑,资料切块全靠瞎蒙。很多人切文档,不管内容,一律切成1000字一块,结果呢?一个完整的产品参数被切成两半,检索出来一半,信息不全,大模型还是说错。要是切太大,一堆没用的内容混进去,大模型找不着重点,还是错。这块真的是细节决定成败,不同类型的内容要切不同的大小,没有通用的标准答案,全靠落地的时候调。
第二个坑,检索错了,全白搭。RAG的效果,九成看检索。你问“你们家有没有防过敏的床垫”,检索出来一堆“防蚊蚊帐”的内容,大模型再厉害也只能给你瞎扯。很多人向量模型选不对,索引做的烂,检索出来的内容牛头不对马嘴,最后怪RAG不行,其实是自己第一步就错了。
第三个坑,为了技术而技术。我上个月见一个开奶茶店的老板,要给十几款饮品做AI点单,也要加RAG。我听完都笑了,十几款产品,直接把所有参数写进prompt里才几百字,稳定又便宜,搭什么RAG啊?纯纯拿大炮打蚊子。RAG适合的是你的私有资料多,动辄几千几万份,还经常更新的场景,小场景真没必要瞎折腾。
还有绕不开的风险,要是你的原始资料本身就错了,RAG会把错的内容检索给大模型,大模型说的头头是道,错的更隐蔽,比原来的幻觉还坑。还有版权问题,你用了别人付费的内容做检索库,生成出来的内容算不算侵权,现在法律上还说不清楚,真要商用,得想清楚。
不过话说回来,检索增强生成确实是目前为止,解决大模型幻觉最便宜好用的方案。它不是什么颠覆式的黑科技,就是把原来检索领域的经验,和现在大模型的能力拼在了一起,刚好解决了落地最疼的那个问题。
你要是也在做大模型落地,被大模型胡说八道搞疯了,不妨试试。别上来就堆高端组件,先拿最简单的方案跑通,再慢慢调,比什么都强。
大模型为啥爱胡说,病根不是笨是天生
很多人骂大模型笨,其实错怪它了。大模型天生就不是给你存事实的。 它的本质,是根据上一个词,猜下一个词最可能是什么。你问它问题,它拼出来的话,逻辑顺,但内容对不对,它自己都不知道。 业内把这个毛病叫大模型幻觉。对吧? 尤其是涉及到你自己的私有数据——公司内部的规章制度、自家电商的产品参数、最新出的行业报告,这些内容根本没出现在大模型的训练数据里,它能不瞎编吗? 有人说,那我把这些数据拿去微调大模型不就行了? 说实话,微调贵啊。你动一次模型,几万块进去了,你每周更一次产品册,难不成每周掏几万微调?而且微调调坏了,原来会的东西都忘了,你找谁说理去? 还有人说,那我把所有资料都塞进prompt给大模型不行吗? 你有一万个产品,每个产品十页资料,全塞进去,prompt长度早就爆了,而且大模型看那么多内容,早把重点忘干净了,该错还是错。大模型电商客服问答幻觉错误示例
就这么个死结,给检索增强生成留了位置。
检索增强生成的本质,就是允许大模型翻“开卷考”笔记
说出来你可能不信,原理一点都不复杂。类比成考试你就懂了。 原来的大模型回答问题,是闭卷考,全靠自己脑子里记的东西,记不清就瞎蒙。检索增强生成呢,是开卷考,允许大模型提前翻你给它准备好的笔记本,找到对的内容,再照着内容组织答案,根本不用瞎蒙。 具体走三步,没什么玄乎的。 第一步,提前给你的私有资料“做索引”。把你所有的产品册、文档、聊天记录,切成一小块一小块的,再把每一块文字转成向量存在向量库里。听不懂向量也没关系,你就理解成给每一块内容贴了个标签,方便后面找就行。 第二步,用户问问题,先找笔记。把用户的问题也转成向量,去向量库里面找几块和问题最相关的内容,这一步就是“检索”。 第三步,把找到的内容和用户问题拼在一起,送给大模型,说清楚:你就照着我给你的这些内容说,不许瞎编别的。大模型再把这些内容整理成通顺的回答出来,这就是“增强生成”。 你看,整个过程,大模型根本不需要记这些内容,只要负责组织语言就行,事实性的内容都从你给的笔记里来,自然就很少胡说了。成本还低,也就微调的几十分之一,你更新产品册,只要更新索引就行,不用动大模型本身,灵活得很。面向大模型问答的检索增强生成工作步骤流程图
我那个发小的沙发客服,就是把所有产品的参数、合同条款都做成了检索库,用户问什么,先找对应的条款,再让大模型组织成口语,再也没出过错。
别神化,检索增强生成不是包治百病的银弹
别神化,检索增强生成不是包治百病的银弹
现在圈子里把RAG吹得太神了,好像只要加了RAG,大模型的所有问题都解决了。我见过太多团队,上来就搭RAG,花了几十万,最后用起来还不如直接写死的规则好用。
说几个我踩过的坑吧。
第一个坑,资料切块全靠瞎蒙。很多人切文档,不管内容,一律切成1000字一块,结果呢?一个完整的产品参数被切成两半,检索出来一半,信息不全,大模型还是说错。要是切太大,一堆没用的内容混进去,大模型找不着重点,还是错。这块真的是细节决定成败,不同类型的内容要切不同的大小,没有通用的标准答案,全靠落地的时候调。
第二个坑,检索错了,全白搭。RAG的效果,九成看检索。你问“你们家有没有防过敏的床垫”,检索出来一堆“防蚊蚊帐”的内容,大模型再厉害也只能给你瞎扯。很多人向量模型选不对,索引做的烂,检索出来的内容牛头不对马嘴,最后怪RAG不行,其实是自己第一步就错了。
第三个坑,为了技术而技术。我上个月见一个开奶茶店的老板,要给十几款饮品做AI点单,也要加RAG。我听完都笑了,十几款产品,直接把所有参数写进prompt里才几百字,稳定又便宜,搭什么RAG啊?纯纯拿大炮打蚊子。RAG适合的是你的私有资料多,动辄几千几万份,还经常更新的场景,小场景真没必要瞎折腾。
还有绕不开的风险,要是你的原始资料本身就错了,RAG会把错的内容检索给大模型,大模型说的头头是道,错的更隐蔽,比原来的幻觉还坑。还有版权问题,你用了别人付费的内容做检索库,生成出来的内容算不算侵权,现在法律上还说不清楚,真要商用,得想清楚。
不过话说回来,检索增强生成确实是目前为止,解决大模型幻觉最便宜好用的方案。它不是什么颠覆式的黑科技,就是把原来检索领域的经验,和现在大模型的能力拼在了一起,刚好解决了落地最疼的那个问题。
你要是也在做大模型落地,被大模型胡说八道搞疯了,不妨试试。别上来就堆高端组件,先拿最简单的方案跑通,再慢慢调,比什么都强。