联邦学习中的非独立同分布:落地绕不开的核心坑
你搭完联邦学习框架,调通了跨节点通信,结果一跑测试集,准确率比集中式训练低了快10个点?怎么调正则都没用。
别骂框架,也别骂数据标注。90%的情况,都是联邦学习中的非独立同分布在搞鬼。
你真的搞懂什么是非独立同分布吗?
很多人看论文里写非IID,以为就是数据不一样。哪有这么简单。
联邦学习的核心是“数据不出域”,每个客户端(比如医院、银行分行、手机端)自己存自己的数据。独立同分布说的是,所有客户端的数据,特征和标签的分布都差不多。比如你做手写数字识别,每个用户手机里存的1到9的数量差不多,每个数字的写法分布也差不多,这就是IID。
可实际落地呢?哪有这么好的事。
做医疗AI的,三甲医院收的都是重症,社区医院都是轻症,病例的标签分布能差出天壤去。做推荐系统的,北方用户搜得多的是保暖内衣,南方用户搜得多的是短袖,特征分布完全不是一回事。做风控的,新成立的小支行根本没有多少坏账样本,老行存量样本多,坏账占比差了好几倍。
说白了,每个客户端的数据都带着自己的场景烙印,这就是非独立同分布。
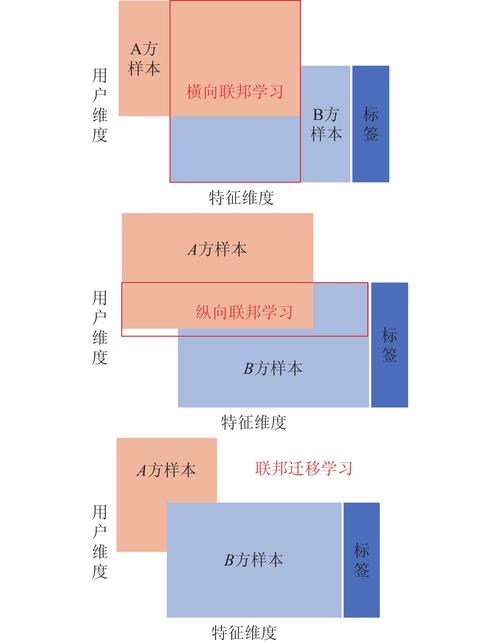 联邦学习不同客户端非独立同分布数据差异示意图
就这么简单。很多新手一开始非要搞什么复杂定义,其实落地的时候你只要记住:每个客户端的数据长得不一样,就是非IID。
非独立同分布到底把模型坑成什么样?
最常见的问题,就是全局模型漂移。
联邦平均算法你肯定用过对吧?就是每个客户端训完本地模型,把参数传上来平均,得到全局模型。如果各个客户端分布差得大,参数更新方向就完全不一样,平均完之后,哪个方向都不对,整体就飘了。
我之前帮一家互联网公司做广告推荐的联邦模型,五个客户端,四个是新用户占比80%,一个是老用户占比90%,参数平均完,全局模型对老用户的推荐准确率直接掉了15个点,你说邪门不邪门?
还有更坑的,就是少数客户端的偏置把整个全局模型带歪。比如一千个客户端,九十九个分布差不多,一个分布差特别大,它的参数更新幅度大,平均完整个模型就歪到它那边去了。
现在很多做端侧联邦大模型的朋友都吐槽,用户有的开了个性化推送,有的没开,数据分布差得离谱,训出来的大模型回答问题,要么太泛,要么太偏,根本没法用。
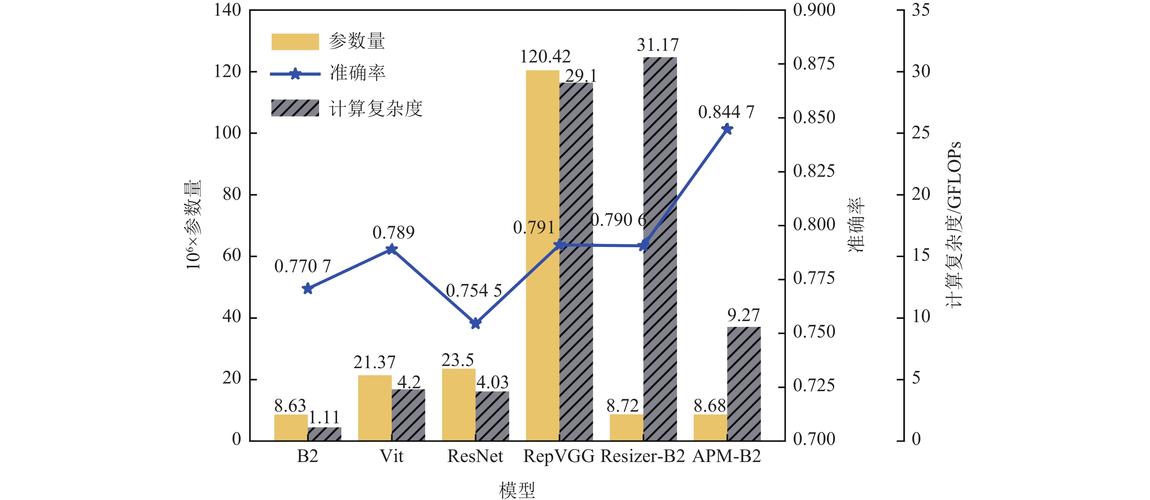 非独立同分布导致联邦模型准确率下降对比图
说实话,我见过太多联邦学习项目,实验室跑分很漂亮,一到落地就拉胯,根源全在这。不是算法不行,是你没处理非IID。
现在业内靠谱的解法都有哪些?
 现在业内靠谱的解法都有哪些?
这么多年啃这个问题,业内已经攒了不少实用的思路,没有银弹,但分场景用对了,能拉回来七八个点的准确率。
第一个思路,客户端聚类分层训练。简单说就是,把数据分布差不多的客户端归成一类,同一类训一个子全局模型,最后再聚合。这个思路在金融风控这种场景特别好用,因为同规模的支行,客户分布本来就差不多,归完类之后非IID的问题直接解决大半。
第二个思路,正则化约束。给本地训练或者全局聚合加约束,不让本地模型参数飘得离全局太远,相当于给模型拴个绳子。最经典的就是FedProx,在本地损失函数加了一个近似的项,限制本地参数更新的幅度,对于分布差异不是特别极端的场景,效果提升很明显。
第三个思路,数据对齐与补全。说白了就是在不泄露原始数据的前提下,每个客户端生成一点符合全局分布的合成数据,补到自己的本地训练里,把分布拉均匀。这个思路最近在大模型联邦里用得越来越多,效果不错,但就是额外费点算力。
不过话说回来,现在所有的解法,都只能缓解,没法根治。你要是拿一个分布差出十万八千里的数据集来,什么算法都救不了。我见过最极端的案例,两个客户端,一个只有正样本,一个只有负样本,这还训什么联邦,直接重来吧。
现在业内的趋势是什么?大家都不盯着那种通用解法了,开始针对具体场景做定制化。做医疗影像的就针对影像特征的非IID调,做风控的就针对标签分布偏做优化,反而出了不少好用的成果。
联邦学习现在能落地越来越多项目,说白了,就是大家终于不躲着非独立同分布走了,愿意沉下心来啃这个硬骨头了。之前很多项目为了刷点,刻意凑IID数据集,那都是自欺欺人,真到落地,该踩的坑一个都跑不了。
你要是现在做联邦学习落地,第一件事不是搭框架,是把各个客户端的分布拉出来看看,差多少,是什么类型的差异,先把问题摸清楚,再选解法,比上来就瞎调参数强一百倍。