机房热风里的高效能计算平台:算得快,不如搬得快
凌晨两点,南京。机房走廊里一股热风,混着灰尘和咖啡味。我盯着一屏 Slurm 状态,一个 CFD 作业跑了四个小时,进度条像死了一样。旁边同事说,加卡吧。我没吭声。因为我知道,卡可能没问题,问题在数据挪不动。
这就是我想聊的高效能计算平台。不是某台机器跑分多高,也不是把一堆服务器塞进机柜就完事。它更像一条流水线——算、存、传、调、散热、供电,哪一环掉链子,整条线都难受。
算力不是一块芯片,是一条流水线
很多人一听高效能计算平台,脑子里跳出来的是 GPU、CPU、内存条。对,但不全对。单节点里,CPU 和 GPU 之间走 PCIe,内存有 NUMA 节点,网卡插在哪个 PCIe 插槽,都会影响数据路径。你让 GPU 算得飞快,可数据从存储到内存再到显存,一路堵车,算力就干等。
我见过一个很典型的局:双路服务器,八张卡,看着很猛。结果 IB 网卡插在 CPU1 的 PCIe 上,而一半 GPU 挂在 CPU0 下面。跨 CPU 传数据,延迟和带宽都吃亏。作业一上规模,扩展效率惨不忍睹。你说这怪谁?怪采购单?怪装机师傅?还是怪没做拓扑感知。
真正决定体验的,常常是数据搬运路径,而不是峰值算力。
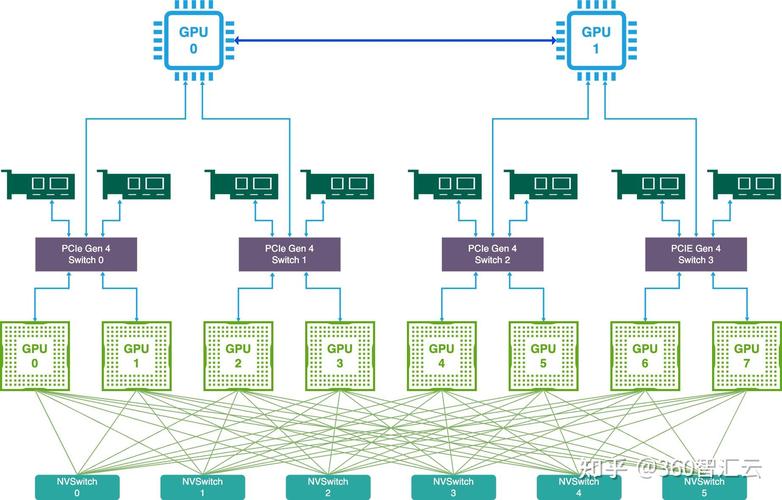 高性能计算集群节点内部GPU与网卡PCIe拓扑照片
厨房的比喻挺顺手。后厨有十个灶台,切菜师傅只有一个,传菜口还窄。灶再多,也只能站着看。高效能计算平台要解决的,就是让灶、墩子、传菜口、仓库之间的路别互相打架。
调度器像个交通警察,但路是它修的
作业调度这层,平时很没存在感。Slurm、PBS、LSF,名字听着都像老古董。可一旦排队排到明天,大家就开始骂调度器。说实话,调度器挺冤。它只是在已有资源里做分配,资源不够、策略不对,它也只能干瞪眼。
有个研究生找我,说他的作业永远排不上。我一看脚本,把一个大任务拆成了一千个单核小任务,每个跑三分钟。调度器疯了。回填、抢占、公平分享全被搅乱。后来改成数组作业,限制并发,问题小了一半。这不是什么黑魔法,就是别把交通警察当许愿池。
调度策略要跟科研节奏匹配。短作业多,就留出回填空间。长作业多,就得有预留和检查点。有人喜欢一刀切,所有队列一个优先级,最后就是互相踩。高效能计算平台里,公平和效率从来不是一回事,得做取舍。
 Slurm作业调度队列终端界面截图
还有个小坑:很多平台只盯 CPU 核数,不管内存带宽、本地盘、GPU 显存。一个作业要 64 核,内存却只给 128 GB,跑起来就换页。换页一开,整台机器都跟着咳嗽。调度器如果不懂这些维度,资源就配不准。
存储和网络:看不见的收费站
说个更扎心的。有次跑 checkpoint,模型每隔十分钟写一次,一次 10 TB。算十分钟,写三十分钟。大家盯着 GPU 利用率骂娘,其实 GPU 在等 IO。并行文件系统像 Lustre、GPFS,不是简单地把硬盘连起来。元数据服务、对象存储、条带化、客户端缓存,每一层都能卡人。
网络也一样。RDMA 这词听着高冷,说白了就是让网卡直接访问对方内存,少让 CPU 当搬运工。InfiniBand 和 RoCE 都在干这事。可配置不好,PFC、ECN、拥塞控制一塌糊涂,丢包重传照样让你怀疑人生。曾经有个集群,理论带宽 200 Gb/s,实际跑出来不到 20。查了三天,发现交换机缓冲区设置和网卡固件版本打架。
高效能计算平台里,网络不是配件,是骨架。计算节点之间要同步、要归约、要广播。Allreduce 这种操作,在 AI 训练里能把人逼疯。你以为是算力问题,其实是通信在拖后腿。拓扑结构、交换机层级、路由策略,甚至光模块兼容性,都会在规模上去以后冒出来。
存储和网络还有个共同点:平时没人夸,一出事全是锅。带宽不够,作业排队。元数据慢,ls 都能卡住。小文件多,并行文件系统也头疼。别问,问就是先做 IO 画像。
散热和电:算力上桌,热风先到
南京夏天,机房空调要是打个盹,报警短信能把你手机震没电。高效能计算平台越堆越密,单机柜功率从几 kW 涨到几十 kW。风冷吹不透,冷板液冷就上场了。冷板贴在 CPU、GPU 上,循环液把热带到 CDU,再排到室外。听着像给芯片贴退热贴,实际管路、快接头、漏液检测,全是工程活。
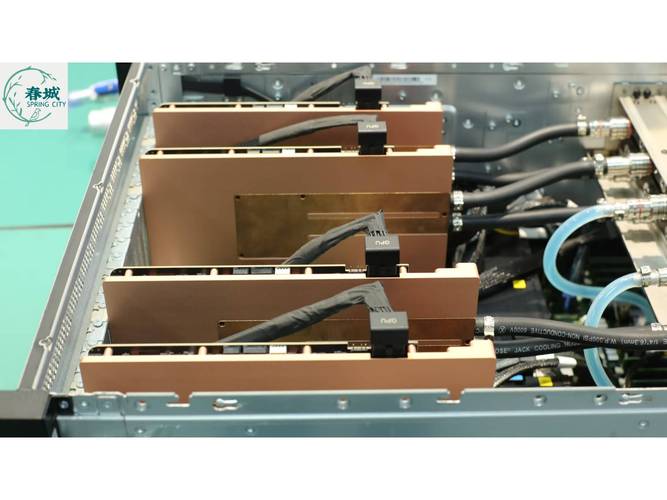 液冷高性能计算集群机柜冷板管路连接细节
电费这事更现实。PUE 每降 0.1,一年省下的钱能买不少硬盘。可液冷不是万能药。老机房承重、层高、水路改造,样样要钱。有的团队算了半天,最后发现把机柜门打开、冷热通道封好,收益更直接。别笑,真事。
散热和供电不是后勤,是高效能计算平台的上限。你买得到卡,未必供得上电,未必散得掉热。机房地板每平米承重多少,UPS 能撑几分钟,冷冻水温度能不能调高,这些事在规划阶段不问,后面就只能拍大腿。
常见误解,还有它管不到的地方
误解一:高效能计算平台等于高配电脑堆一起。差远了。没有并行文件系统、低延迟网络、资源调度、监控运维,那就是一堆昂贵的发热铁块。
误解二:核多、卡多就一定快。小矩阵、频繁小文件、强串行依赖的活,扔进高效能计算平台反而更慢。通信开销、排队开销、IO 开销,分分钟吃掉收益。
误解三:上了平台,科研就自动加速。工具只是工具。代码不并行、算法不收敛、数据布局不对,神仙平台也救不了。
反过来,有些场景真不适合。比如低延迟在线交易,要求微秒级响应,HPC 那套批处理思维不搭。又比如大量随机小 IO 的数据库,跟并行文件系统的脾气也不合。选型前先问:瓶颈到底在哪?是算、是存、是传、还是人。
我现在越来越觉得,高效能计算平台很值钱的部分,不是某张卡,也不是某个交换机。是那套让资源被看见、被度量、被调优的机制。还有一群愿意半夜爬起来看日志的人。机器会老,人会累,但问题不会自己消失。
凌晨三点半,那个 CFD 作业终于动了。不是因为我加了卡,是因为我把输出路径从 NFS 换到了并行文件系统,又调了条带。进度条爬得还是慢,但至少没躺平。机房热风继续吹。我关掉终端,心里想,高效能计算平台这事,真不是堆硬件,是跟瓶颈打交道。今天打一个,明天还有下一个。