灾备技术方案别只盯着备份成功,真切换时那几小时才要命
凌晨两点零七分,我被电话吵醒。不是告警短信,是业务负责人在群里@我:“订单库怎么这么慢?”
我打开监控,主库的IO延迟已经冲到三千多毫秒。机房那边说市电波动,UPS切了一下。听着像小事,对吧?可一台存储控制器的电池老化,切换后没能正常回写。主库半死不活。
老板问了一句:灾备能切吗?
我沉默了。脚本?有。方案?也有。但上次演练是半年前,改过的连接串没人复核。那一刻我特别想骂人,骂自己。
所以这篇不聊概念大全。就聊灾备技术方案里,真正会咬人的几个地方。
先别聊双活,先问RPO和RTO你能不能接受
RPO,恢复点目标。说人话:你最多能丢多少数据。RTO,恢复时间目标。你最多能停多久。
这俩数不是技术指标,是业务底线。订单支付说RPO等于零,RTO五分钟。财务月底结账可能说,丢半小时可以,停两小时也行。你得先逼业务签字,别自己替他们拍脑袋。
有个朋友在城商行做运维。他们核心交易系统,同城双活加异地灾备,RPO要求接近零。代价是什么?专线带宽、存储阵列、数据库许可、每季度演练,一年烧掉的钱够买几套房。值不值?看业务。
小公司就别硬抄。一个日活几千的SaaS,先把每日全量备份、每小时增量、异地对象存储做扎实。恢复演练每季度跑一次。这比买一套昂贵的双活存储有用得多。
备份和灾备,压根不是一回事。备份是找回数据,灾备是让业务继续跑。备份成功,不等于能恢复。恢复成功,不等于业务能按时回来。
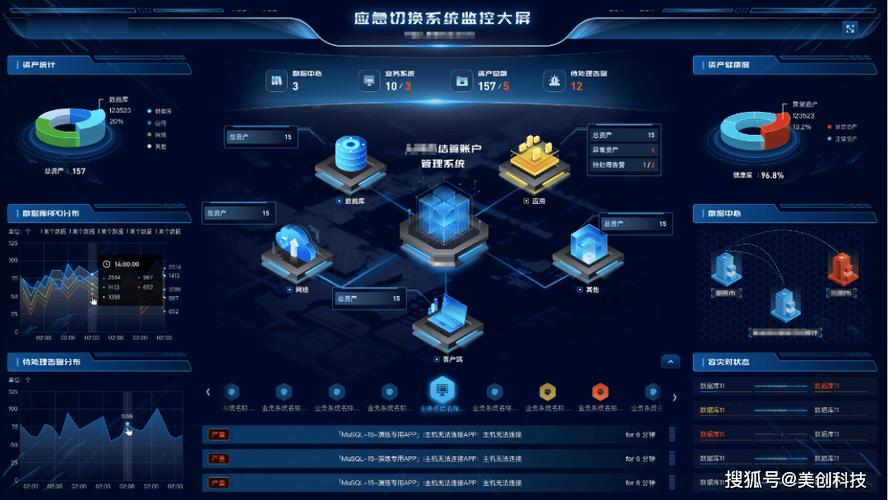 企业核心交易系统灾备切换演练监控大屏照片
我见过太多备份任务绿油油,一恢复发现索引坏了、权限丢了、序列号对不上。真的,绿不等于活。
备份、复制、双活,别混成一锅粥
很多方案PPT把这三样画在一个框里。实际干起来,它们各管一段。
备份解决“昨天的数据没了”。可以是全量、增量、差异,也可以快照。关键是离线。勒索病毒进来,头一件事就是加密你能访问的备份。所以要有不可变存储,要有气隙,可以有一份磁带或者对象存储开了合规锁。别笑磁带,有些场景它真香。
复制解决“站点挂了,另一个地方还有近实时数据”。存储复制、数据库主从、逻辑复制,都在这个范畴。同步复制性能影响大,异步复制会丢最后一段。怎么选?看RPO。别指望异步复制做到RPO等于零,那是骗自己。
双活解决“两个站点都跑业务,挂一个另一个顶上”。听着很美。但双活麻烦的不是存储,是仲裁、脑裂、数据一致性,还有应用配置。我们那次演练,数据库切过去了,应用还在连旧IP。为什么?DNS TTL设了十分钟。业务等了十分钟,等于没切。
还有个坑:双活不是自动的。自动切换需要决策系统,需要防脑裂。手动切换需要人敢按按钮。怕的是,切换脚本只有离职的老王看得懂。
真正决定生死的,是切换那天有没有人敢按按钮
方案写得再厚,落到后来就三样:预案、演练、权限。
预案别写“联系DBA”。要写具体IP、具体命令、具体检查点。谁决策?谁执行?谁验证?回切条件是什么?这些不写清楚,出事时群里能吵半小时。
演练别只演练“成功路径”。要演练失败。主库起不来怎么办?备库延迟太大怎么办?备份文件损坏怎么办?没演练过的灾备方案,约等于没有。这话难听,但真。
 数据中心灾备切换Runbook操作步骤截图
我们后来搞了个土办法。每季度抽一个周五凌晨,真切。切之前发公告,切之后跑核心用例。头一回花了五小时,后来两小时,再后来四十分钟。不是技术突然变好了,是每个人都知道自己该干嘛了。
还有个反直觉的点:回切往往比切换更难。因为切过去之后,新数据写到了备站。你要么丢,要么做反向同步。方案里如果没写回切,那就是只做了一半。
成本边界,和那些常见的错觉
 成本边界,和那些常见的错觉
灾备很贵。两地三中心、同城双活加异地灾备,钱、带宽、延迟、运维复杂度,一个都跑不掉。所以别一上来就抄大厂架构。先做业务分级,核心系统保,非核心系统降级保。这不是偷懒,是算账。
常见错觉一:上云就不用灾备。云厂商保的是机房、硬盘、网络。你误删数据库、被勒索、配置发错,云厂商不背锅。跨可用区不等于跨地域,快照不等于可恢复。
常见错觉二:容器化天然容灾。K8s能调度Pod,不代表数据能回来。有状态服务、PV、etcd,哪个不要备份?
常见错觉三:备份软件显示成功,就万事大吉。我建议你每月随机抽一个备份文件,真恢复一次。恢复到一个隔离环境,跑一遍校验。这事很烦,但能救命。
还有,别忘了人。灾备方案里很脆弱的一环,往往是那个唯一知道密钥在哪的人。密钥托管、权限双人复核、离职流程,都得有。
一个能落地的最小灾备方案
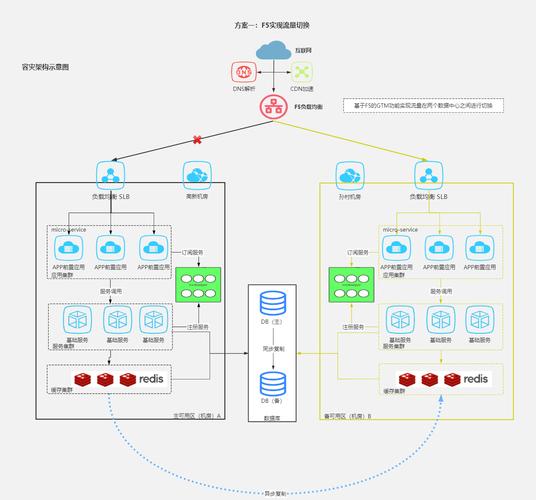 一个能落地的最小灾备方案
如果你现在手里就一套业务,预算不多,可以按这个顺序来。
- 业务分级,写下每个系统的RPO和RTO。让业务负责人确认,别自己扛。
- 备份做3-2-1:三份数据,两种介质,一份异地。可以加一份不可变。
- 核心数据库开日志备份,异地异步同步。带宽不够就压缩、限速,别把生产拖死。
- 每季度做一次恢复演练。记录实际RTO,别记录理论值。
- 切换脚本放进Git,版本化,双人复核。别放在老王电脑桌面。
- 监控备份任务,但更要监控恢复演练。告警要能叫醒人,不是发到没人看的群。
这套方案不酷。没有双活,没有两地三中心。但它能让你在凌晨两点,不至于只会说“我看看”。
回到开头那次事故。我们后来没切。靠从库和日志,硬扛了四小时,把数据捞回来了。老板没骂我,但我知道,运气帮了忙。
后来我们把脚本重写,每季度真演练。灾备技术方案不是买一堆设备,也不是画一张好看的架构图。它是买一份确定性。这份确定性,平时看不见,出事时按秒计价。