容错计算技术:冗余能买到的可靠性,边界在哪里
一次高能粒子穿过封装,SRAM 里的某一位翻转。系统可能永远不知道,也可能整条任务链要重跑。差别不在运气,而在设计之初,工程师把多少预算押在了“出错”这件事上。
先有故障模型,才有容错方案
讨论几模冗余、要不要上纠错码之前,得先把故障长什么样说清楚。瞬时翻转、永久失效、间歇性错误、拜占庭式任意行为——四类故障的分布、相关性和可观测性差异巨大。拿对付瞬时翻转的办法去处理拜占庭节点,等于没做;反过来给单粒子翻转配一套共识协议,代价高到没人愿意付。工程里最常见的失误恰恰在这里:先选了方案,再倒推假设。
还有一层容易被略过。检测环节自己也会坏。三模冗余里的表决器一旦失效,三份副本会被一起拖偏,可靠性曲线不是抬升而是断崖。这类问题在教科书里往往一笔带过,落到硅片上就是实打实的概率。
 三模冗余TMR表决器电路结构示意图
冗余的账单,从来不只在面积上
 冗余的账单,从来不只在面积上
时间冗余、空间冗余、信息冗余——三种老办法,各自对应一张不同的账单。
空间冗余把同样一件事交给多份硬件去做,面积、功耗、布线拥塞一起上行。芯片没有变快,只是变贵。对移动端,这意味着续航被吃掉一截;对数据中心,意味着每瓦性能下滑,机柜的电力预算跟着重算。
时间冗余,重复执行再比对,延迟随之膨胀。航天器上可以接受毫秒级的重试,汽车刹车控制里这一毫秒往往不存在。硬实时系统对时间冗余的容忍度,比想象中低得多。
信息冗余,纠错码、校验位这一类,开销最小,代价是能力有限。单比特纠、双比特检,是经典配置。位宽再宽、多比特翻转一起来,它就无能为力了。而且,纠错逻辑自身的门级电路也可能被同一束粒子打到——纠错器成了新的故障点,这个反例在设计评审里经常被漏掉。
共因失效:冗余最尴尬的对手
两份独立设计、独立实现的副本,理论上不该同时错。现实里它们常常同时错。同一块时钟、同一路电源、同一个编译器缺陷、同一条总线——相关性一旦出现,冗余度就开始贬值。
硬件层面的例子不少:同一颗芯片上的多个核共享电压调节器和时钟树,一次电源跌落,所有副本同时出错。软件层面也一样,N 版本编程如果由同一批人按同一份需求文档写,缺陷的相关性会高得让“独立”二字变成一种修辞。
于是就有了物理分隔、时序错开、异构实现这些手段。它们有效,但都贵。更麻烦的是,共因失效的评估本身缺少可靠方法——你无法用统计实验穷尽一个低频事件的耦合路径,只能靠故障树和工程判断,而这两样都带着主观成分。
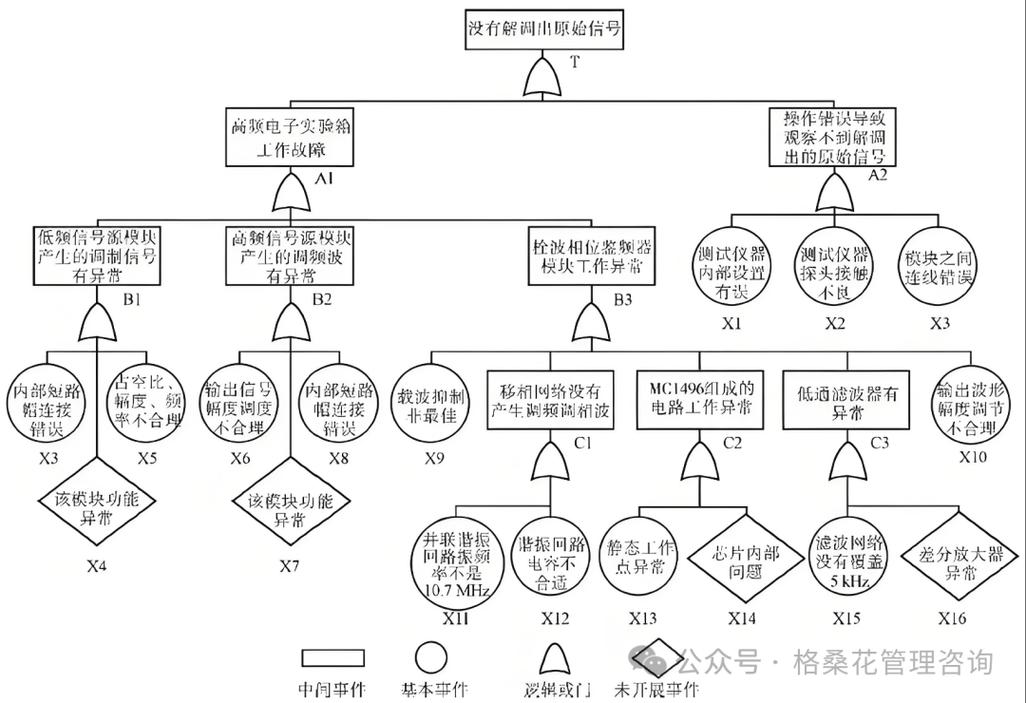 汽车电子功能安全故障树分析示意图
检查点与恢复:工程细节吃掉理论优雅
回滚恢复在论文里很干净:检查点、日志、重启。落到真实集群上,问题全在细节。检查点本身要不要多副本?日志写本地盘还是远端?写远端就引入网络故障,写本地就引入盘故障。检查点频率提高,稳态开销随之上涨;频率降低,回滚后要重算的窗口变长,恢复时间被拉长。
一个常被引用的量化关系是:最优检查点间隔大致与故障平均间隔的平方根成正比,与检查点开销的平方根成反比。结论来自经典的可靠性建模,前提是故障独立同分布、检查点开销恒定。真实的分布式系统两条都不满足,所以工程上更多是靠压测和调参,而不是靠公式直接算。
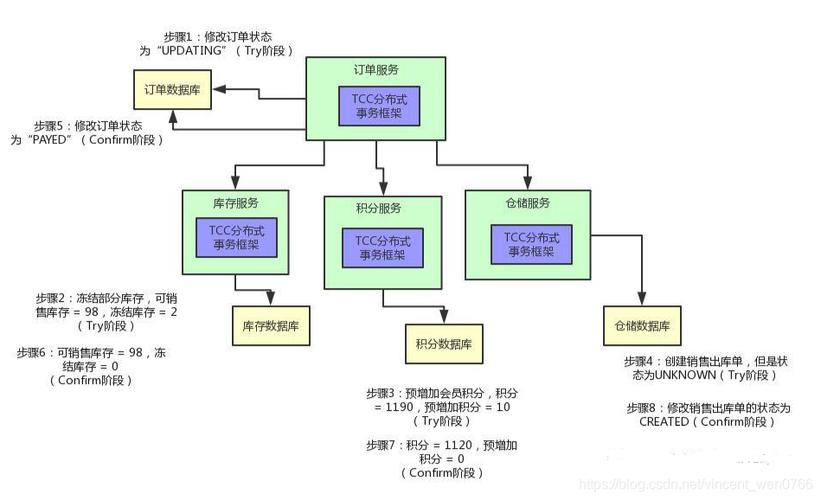 分布式系统检查点回滚恢复流程示意图
应用边界:航天、数据中心、车规各要各的
 应用边界:航天、数据中心、车规各要各的
航天讲的是辐射环境下的长期可用,容错预算可以给得很足。数据中心讲的是海量节点的年均停机时间,故障是常态,容错更多落在软件层——副本、调度、断路器、超时重试。车规处在中间:环境比数据中心恶劣,成本比航天苛刻,而且失效率直接关联人身安全。
这三类场景的目标函数并不同。航天优化任务成功率,数据中心优化可用性除以成本,车规优化的是危险失效的量化控制。用同一套技术栈去覆盖三者,通常会在某一端吃亏。把数据中心的副本机制直接搬上车,往往换来一堆无法通过认证的实时性数据。
趋势:从屏蔽故障转向与故障共处
屏蔽式容错隐含一个假设——故障可以被完全挡住。当工艺尺寸继续缩小、供电电压继续下探、器件的不确定性变成常态,这个假设越来越难维持。
正在发生的转向有两类。一类是把容错做进统计框架,允许错误存在,但让错误的影响落在可接受区间内,近似计算、误差感知调度都属于这个方向。另一类是让容错机制本身具备自适应能力,依据实时错误率调整冗余度,低错误率时省电,高错误率时加倍保护。后者有诱惑力,风险也明显:调整策略本身可能被故障影响,形成闭环失稳,这类事故在早期尝试里不是没有出现过。
还有一条路径值得留意。用模型去预测硬件失效前兆,在故障真正发生之前调度迁移。目前的做法大多停留在相关性层面,因果证据不足,误报的代价也不低。这更像是容错体系里的一块补丁,而不是替代品。
边界在哪
回到最初那个问题。冗余能买到的可靠性有上限,上限由共因失效和检测器自身的可靠性决定。越过这个上限,投入越多,边际回报越低,甚至因为引入了更多器件而抬高总故障率。
所以,真正需要回答的不是是否使用容错计算技术,而是故障模型的边界在哪、可接受的失效概率是多少、以及为剩下的那部分风险,是否还有更便宜的兜底方式。这些问题没有通用答案,但每一个都值得在写下第一行 RTL 之前想清楚。想不清楚,冗余就只是把不确定性换个地方藏着。