系统可靠性设计:从浴盆曲线到AI集群,别等炸了才想起它
先别聊架构,先问一句:它凭什么不坏?
一台设备坏了,原因可能很蠢。一个电容选型差半档,焊点虚了,风扇堵了,固件里一个越界写。可一旦它放在数据中心、卫星、自动驾驶车上,代价就不是换个零件那么简单。
系统可靠性设计,说白了就干三件事:让故障少发生,让故障发生时别扩散,让扩散后还能活。听起来像废话,对吧?真做起来,全是脏活。
可靠性不是售后指标。它是设计输入。科研里常用 R(t) 描述:规定条件、规定时间、完成规定功能的概率。注意,概率。不是“我觉得没问题”。
浴盆曲线老了,但还没死透
很多教材一上来画浴盆曲线。早期失效、偶然失效、耗损失效。经典。可你拿现在的芯片去看,未必这么乖。
有些器件早期失效率降得很快,然后长时间平坦。有些封装、焊点、连接器,磨损来得比你想的早。还有软件——它压根不磨损,它是一开始就带着 bug 出生。
所以做可靠性预计,不能只套 MIL-HDBK-217。那套东西有历史价值,但跟今天的制程、封装、工况差太远。科研上更常见的是退化建模。Wiener 过程、Gamma 过程、逆高斯过程,配合粒子滤波做剩余寿命预测。听着玄?其实就一句话:别等它坏,盯着它怎么慢慢变坏。
比如锂电池。容量衰减、内阻上升,都是退化轨迹。用加速寿命试验把温度、倍率、DOD 拉高,再外推到真实工况。Arrhenius 模型管温度,Eyring 管更多应力。模型不准怎么办?那就上贝叶斯,让现场数据修正先验。科研味很浓,但工程上救命。
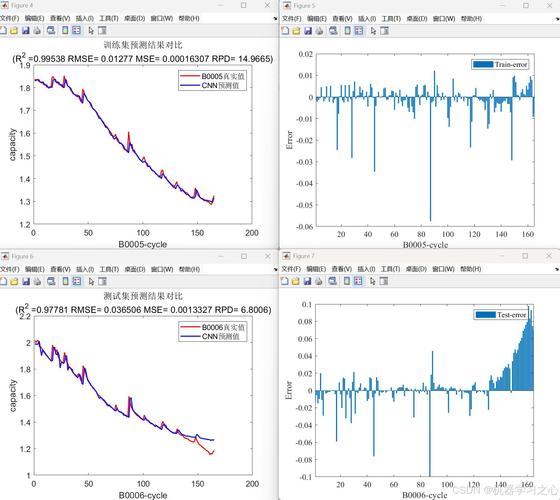 锂电池系统可靠性设计退化建模剩余寿命预测曲线图
不过别迷信模型。实验室里恒温恒湿,现场可能潮湿、盐雾、振动、电磁干扰一起上。这就是为什么 HALT 和 HASS 至今没被淘汰。HALT 往死里逼,找操作极限和破坏极限。HASS 筛早期缺陷。粗暴,有效。
冗余不是万能药,共因故障才是暗刀
一说可靠性,很多人第一反应:加冗余。双电源、双机热备、三取二表决。对,但只对了一半。
冗余的前提是故障独立性。如果两路电源接在同一段母线,共模故障一来,全没。如果两个传感器用同一批次的芯片,又装在同一个热源旁边,它们可能一起漂。这叫共因故障。
更阴的是共模故障。软件里一段错误逻辑,在两个节点上同时跑,冗余了个寂寞。所以高可靠系统要讲故障域隔离。物理隔离,电气隔离,软件分区,时间分区。航空电子里 ARINC 653 那套分区思路,就是防这个。
冗余也有代价。重量、功耗、成本、维护复杂度。冷备要切换时间,热备要同步开销。表决系统还得考虑故障检测覆盖率。覆盖率不够,冗余就是心理安慰。
 航天器系统可靠性设计冗余架构与故障隔离示意图
科研上常用故障树分析。顶事件是系统失效,往下拆与门、或门,找最小割集。最小割集告诉你:哪几个底事件一起发生,系统就完蛋。动态故障树还能处理顺序、备件切换、冷备。再复杂点,上马尔可夫链、贝叶斯网络。求解状态概率,算可用度。
但故障树建得再漂亮,底事件概率从哪来?现场数据、试验数据、专家判断。数据少的时候,专家判断权重很高。可专家也会偏。所以现在流行数据驱动加机理融合。数字孪生也是这个路子:在线数据喂模型,模型反哺维护决策。
热、振、电、磁:物理层才是地狱
软件可靠性当然重要,但很多硬件故障,根子在物理层。
温度每升高 10 摄氏度,某些电解电容寿命减半。这个老经验不一定准,但方向没错。热设计做不好,降额就是纸面文章。降额也不是随便降。电阻功率降一半,电容电压降 20%,半导体结温留裕量。降太多,体积成本上去;降太少,寿命下来。
振动和冲击更直接。焊点、引脚、连接器、PCB 安装点。随机振动用功率谱密度描述,正弦振动看共振点。模态分析找固有频率,避开激励频率。不然飞一次,焊点裂一片。
电磁兼容也是可靠性的一部分。浪涌、静电、群脉冲。工业现场一个接触器动作,可能让控制器复位。TVS、滤波、屏蔽、接地,一个都不能少。可现实里,接地往往最乱。地环路一出来,信号漂得亲妈都不认识。
环境应力筛选 ESS 就是拿温度循环、随机振动去筛。筛掉早期缺陷。但 ESS 不能过度,过度会把好产品筛伤。所以剖面要设计,要基于HALT结果。
AI 集群和汽车电子,把可靠性逼到新战场
现在最热闹的可靠性问题在哪?两个地方。一个是AI 训练集群,一个是智能汽车。
大模型训练动辄几千张 GPU。卡会坏,网会抖,NVLink 会出错,光模块会掉。Meta 训练 Llama 3 的时候公开说过,中断很频繁。怎么办?Checkpoint。定期存,坏了就重启续训。但 checkpoint 本身也有开销,存太勤,训练效率掉;存太稀,回滚损失大。这是典型的可靠性、可用性、成本三角。
还有 ECC 内存、静默数据损坏。SDC 很讨厌。算错了不报错,模型精度悄悄崩。所以要做周期性校验、端到端对账。数据中心里,液冷、冗余电源、UPS、故障域隔离,全是可靠性设计。可软件定义一切之后,一个配置推送错误,能干掉整个集群。这就是软件可靠性的恐怖之处。
 数据中心AI服务器集群系统可靠性设计故障树分析图
汽车这边,ISO 26262 讲功能安全,ASIL 等级。SOTIF 讲预期功能安全,专门收拾那些“没故障但场景搞不定”的问题。自动驾驶传感器融合,激光雷达、毫米波、摄像头。冗余不能只是多装一个同款传感器,因为雨雾天可能一起瞎。要异构冗余,要不同物理原理。
芯片也在变。Chiplet、异构集成,把大芯片拆小。好处是良率,坏处是接口、热、测试。UCIe 之类的互连标准火了,可靠性问题也跟着来。硅中介层、微凸点、热膨胀系数不匹配。科研上在搞内建自测试、容错路由、纠错码。3D 堆叠内存的纠错更复杂,因为层间故障模式不一样。
可靠性增长:烧钱,但比赔钱便宜
产品刚设计出来,可靠性通常很难看。怎么办?做可靠性增长试验。Duane 模型、Crow-AMSAA 模型,看累积故障率怎么随试验时间下降。每修一个故障,就长一点。听起来像打怪升级。
但这玩意儿烧钱。试验台、样机、时间、人力。可一旦量产召回,或者卫星上天失效,赔的是天文数字。航天领域尤其如此。NASA 和一些商业航天公司都在推基于模型的系统工程,把可靠性模型和数字孪生绑在一起。早期发现设计缺陷,比后期改便宜太多。
软件方面,SRE 和混沌工程在干类似的事。错误预算、SLO、SLI。故意关掉一个节点,看系统怎么反应。Netflix 的 Chaos Monkey 是经典。现在混沌工程进了云原生,有 Chaos Mesh、Litmus。但别乱来。生产环境搞爆炸半径控制,先小范围,有回滚。
科研前沿还在往预测性维护走。PHM,故障预测与健康管理。传感器数据、特征提取、剩余寿命预测、维护决策。风电、高铁、航空发动机都在用。问题是标注数据少,故障样本不平衡。所以迁移学习、半监督、数字孪生生成数据,都上了。
说回根本。系统可靠性设计不是某个专家的事。它是架构师、硬件、软件、测试、运维一起背的锅。你可以在 PPT 上写 99.999%,但现场一个风扇堵了,SLA 就掉。所以别把可靠性当口号。把它当约束。当每一个设计决策都要过一遍的问题:它坏了,系统会怎样?
如果答不上来,那就还没设计完。