光学计算技术:逼着光子做矩阵乘法,然后呢?
用光做矩阵乘法,这事比很多人想的要老。上世纪六十年代的范德鲁格特,拿相干光做傅里叶变换,用透镜实现卷积。那时候的设想很直接:既然光可以自由地在空间中并行传播,为什么不让它替电子干活?
结果被摩尔定律碾过去了。集成电路每十八个月翻一倍,光学处理器还在实验室里调干涉条纹。这一停,就是四十年。
不过话说回来,四十年不算白等。
 硅基集成光子芯片马赫曾德尔干涉仪阵列显微结构图
可惜,优雅的机制不等于好用的工程。
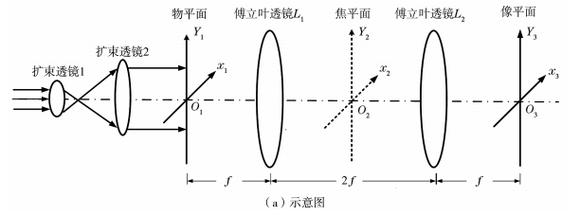 自由空间光学4f系统傅里叶变换光路示意图
 自由空间光学,绕了个弯又回来了
集成光子是工程化程度更高的一条路,但自由空间光学最近又热了起来。有研究者用多层衍射面来做光学神经网络——光穿过一层层相位掩模,每一层相当于一个固定的线性变换。带着这个思路,他们用3D打印或光刻做了多层衍射结构,光穿过就完成了前向传播。
不需要相位调制器,不需要电校准。听起来很美。
但固定就是它的软肋。训练好的网络被物理刻在材料里,模型一换,整块器件就得重做。可重编程性?零。跟电子芯片的灵活度完全没法比。
所以自由空间光学更适合特定任务:固定推理、光学加密、以及那些不需要频繁更新模型的场景。
 它能干什么,它不能干什么
光学计算技术短期内不会替代GPU。功耗、可编程性、精度、软件生态——短板太多。
但它有几个场景天然合适。光互连已经商用了,数据中心里的光模块就是典型例子。特定算子加速也在往前走,比如傅里叶变换、卷积、矩阵乘法——这些线性代数运算光学做起来很顺手。如果你有一个固定推理任务,光学协处理器能做到极低延迟。光学传感和雷达更不用说了,信号本身就是光,直接在光域处理,省掉光电转换。
还有一个方向值得关注:光学储备池计算。利用光学系统的瞬态响应做时序处理,不需要复杂的可编程性,系统本身的动力学就能做分类和预测。这个思路绕开了非线性、校准这些硬骨头,挺聪明。当然,能力边界也很窄。
 写在最后:边界正在变清晰
光学计算技术不是“下一代计算范式”这种话能概括的。它更像一把特定形状的刀,能切某些东西,切不了另一些。那些说“光将取代电”的人,忽略了电子在逻辑、存储、可编程性上的巨大惯性。反过来,说“光学计算就是学术玩具”的人,也低估了光在并行性、带宽、互连上的物理优势。
真正的问题不是“能不能”,而是“在什么边界内值得做”。
这个边界正在慢慢变清晰。硅光工艺在成熟,异质集成在推进,光学神经网络在小型化。也许将来某一天,你电脑里会多一块光子协处理器。也许不会。
我不知道。但我知道光已经在数据中心里跑了。让它再往前一步,去干点计算的老本行——这件事,值得盯着。
电子还撑得住,但互连快撑不住了
芯片制程走到几纳米,漏电流和发热是老生常谈。但真正让数据中心运维的人头疼的是另一件事:铜互连。芯片之间、板卡之间、机架之间,数据靠电信号搬。速率越高,铜线里的高频损耗越严重,功耗跟着涨。一个大型数据中心的互连功耗,能占到总功耗的两三成。这不是工程问题,是材料物理的边界。 光不一样。光子在光纤里跑,损耗低,带宽大,而且不同波长可以叠在一起传——波分复用。这些优势在通信领域已经被吃透了。 问题是,通信做的事是“搬运”,计算做的事是“变换”。光能搬运,但能变换吗? 能。干涉仪是怎么变成乘加器的
你要理解光学计算技术,绕不开一个器件:马赫-曾德尔干涉仪。 结构不复杂。光从波导进来,经过一个分束器,分成两路。两路各有一个相位调制器,改变光程。然后再用一个分束器合束。合束之后,两路光发生干涉。输出光强取决于两路光的相位差。 数学上,这个操作对应一个2×2的酉矩阵。改变相位,就改变了矩阵里的元素。把几十个、上百个这样的干涉仪连成网状结构,理论上可以实现任意维度的酉矩阵乘法。 说实话,这个机制挺优雅的。光在波导里传播速度接近光速,延迟几乎可以忽略。不同波长的光可以同时跑,天然支持并行。你甚至不需要时钟——计算随着光传播自然完成。硅基集成光子芯片马赫曾德尔干涉仪阵列显微结构图
可惜,优雅的机制不等于好用的工程。
三道坎,每一道都不好跨
非线性。 线性运算光学做得很好,但神经网络、信号处理、控制回路,几乎都需要非线性。光学里做非线性,靠的是克尔效应、半导体光放大器或者可饱和吸收体。克尔效应弱得可怜,需要很高的光功率密度。半导体光放大器有增益,但引入自发辐射噪声,而且功耗不低。可饱和吸收体响应快,但恢复时间有限,不适合连续运算。你前面在互连上省下来的能量,后面全填进非线性器件里了。 精度。 电子计算做浮点,可以有64位。光学是模拟计算,精度受限于相位噪声、热漂移、制造误差。集成光子平台的相位控制精度大概在毫弧度量级,折算下来有效位数大约4到6位。做推理,也许够。做训练,那点精度根本不够用。梯度累积几次,误差就淹没了信号。 校准。 这个问题很少被拿到台面上说,但它很致命。一个64×64的干涉仪阵列,包含几千个相位调制器。每个调制器的响应都不完全一样,有制造偏差。工作时还有热串扰——相邻波导的相位调制会互相影响。更麻烦的是,这些偏差会随时间漂移。有人在实验室里花好几个月调一块芯片,调好之后过几周又要重新校准。这哪能量产?自由空间光学4f系统傅里叶变换光路示意图
自由空间光学,绕了个弯又回来了
自由空间光学,绕了个弯又回来了
集成光子是工程化程度更高的一条路,但自由空间光学最近又热了起来。有研究者用多层衍射面来做光学神经网络——光穿过一层层相位掩模,每一层相当于一个固定的线性变换。带着这个思路,他们用3D打印或光刻做了多层衍射结构,光穿过就完成了前向传播。
不需要相位调制器,不需要电校准。听起来很美。
但固定就是它的软肋。训练好的网络被物理刻在材料里,模型一换,整块器件就得重做。可重编程性?零。跟电子芯片的灵活度完全没法比。
所以自由空间光学更适合特定任务:固定推理、光学加密、以及那些不需要频繁更新模型的场景。
它能干什么,它不能干什么
它能干什么,它不能干什么
光学计算技术短期内不会替代GPU。功耗、可编程性、精度、软件生态——短板太多。
但它有几个场景天然合适。光互连已经商用了,数据中心里的光模块就是典型例子。特定算子加速也在往前走,比如傅里叶变换、卷积、矩阵乘法——这些线性代数运算光学做起来很顺手。如果你有一个固定推理任务,光学协处理器能做到极低延迟。光学传感和雷达更不用说了,信号本身就是光,直接在光域处理,省掉光电转换。
还有一个方向值得关注:光学储备池计算。利用光学系统的瞬态响应做时序处理,不需要复杂的可编程性,系统本身的动力学就能做分类和预测。这个思路绕开了非线性、校准这些硬骨头,挺聪明。当然,能力边界也很窄。
写在最后:边界正在变清晰
写在最后:边界正在变清晰
光学计算技术不是“下一代计算范式”这种话能概括的。它更像一把特定形状的刀,能切某些东西,切不了另一些。那些说“光将取代电”的人,忽略了电子在逻辑、存储、可编程性上的巨大惯性。反过来,说“光学计算就是学术玩具”的人,也低估了光在并行性、带宽、互连上的物理优势。
真正的问题不是“能不能”,而是“在什么边界内值得做”。
这个边界正在慢慢变清晰。硅光工艺在成熟,异质集成在推进,光学神经网络在小型化。也许将来某一天,你电脑里会多一块光子协处理器。也许不会。
我不知道。但我知道光已经在数据中心里跑了。让它再往前一步,去干点计算的老本行——这件事,值得盯着。