数据不出门,模型还能变聪明?聊聊隐私计算技术落地时那些坑
去年冬天,我在南京一家三甲医院的信息科蹲了整整三天。干嘛呢?就为了说服他们把那堆脱敏后的影像数据拿出来,跟另外两家医院做个联合建模。结果你猜怎么着?信息科主任老周,端着保温杯,眼皮都没抬一下,甩给我一句:“小张啊,数据出这个门,我明天就得进去。”
这话听着像玩笑,但在医疗圈,它是铁律。患者的CT、病理切片、基因序列,那都是最高级别的敏感信息。别说拿出去了,科室之间调阅都得层层审批。可矛盾在哪儿呢?单个医院的数据量,根本喂不饱一个稍微像样点的深度学习模型。 胃癌的早筛模型,你没个几万例标注数据,准确率根本上不了台面。一边是数据孤岛,一边是模型饿得嗷嗷叫,这局怎么破?
这就是隐私计算技术要解决的核心问题。说实话,这词儿听起来挺唬人,拆开了看,就是一句话:让数据在加密状态下,或者干脆不出本地的情况下,完成计算和协作。
三个技术流派,别被名词绕晕了
你如果去搜隐私计算技术,会看到一堆缩写:MPC、TEE、FL、HE……头都大了。我拿金陵饭店后厨做个比喻,你马上就懂。
第一种,叫多方安全计算(MPC)。好比三个厨师,各有一份祖传秘方,谁也不想让对方看见。但他们想合起来做一道新菜。怎么办?他们给秘方里的每种调料都编个暗号,然后只交换暗号进行试菜。最后菜成了,谁也不知道对方到底放了啥。这套逻辑在密码学上叫“秘密分享”或者“混淆电路”。优点是理论安全极高,缺点是慢。慢到什么程度?我做过一个测试,用MPC算两个数的乘积,局域网里跑了0.5秒。你没看错,0.5秒。这要放在大规模神经网络训练里,基本等于死机。
第二种,叫可信执行环境(TEE)。这个更直接,相当于在CPU里划了一个“黑匣子”。数据扔进去,加密的,外面谁都看不见,连操作系统都偷不到。黑匣子算完了,吐出一个结果。英特尔SGX、ARM TrustZone都是干这个的。这东西速度飞快,几乎就是硬件原生速度。但问题也来了——你凭什么相信那个“黑匣子”真的黑?万一芯片厂商留了后门呢?所以TEE在金融风控里用得多,在医疗这种极度保守的场景,大家心里都打鼓。
第三种,也是目前落地最普遍的,叫联邦学习(FL)。这个最好理解。模型不动,数据不动,让模型去各家各户“串门”。每家医院本地训练自己的模型,只把“参数”或者“梯度”上传到中心服务器。中心服务器把大家上传的东西一平均,再发回去。如此反复。数据从来没离开过医院的内网,但模型却吃到了三家医院的“营养”。
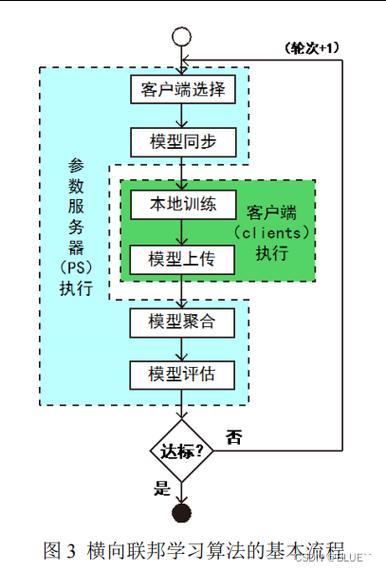 联邦学习 架构图 医院数据不出域 流程示意
我蹲点那三天,其实就是给老周解释这个。他听完问了我一个特关键的问题:“参数上传,你们能不能反推出我的原始数据?”这个问题,直接戳到了隐私计算技术的命门。
梯度也会“叛变”,别把隐私计算当万能药
 梯度也会“叛变”,别把隐私计算当万能药
老周的担忧,不是杞人忧天。几年前,就有学者提出过“梯度泄露”攻击。简单说,你上传的梯度里,包含了模型对训练数据的“记忆”。攻击者只要反复调整输入,对比梯度的变化,就能像玩拼图一样,把原始数据“拼”出来。比如一张人脸图片,通过梯度反演,能还原到七八成相似度。你说吓人不吓人?
所以,真实的联邦学习系统里,光上传梯度是远远不够的。必须叠加差分隐私或者安全聚合。 差分隐私就是在梯度里加噪声,像给照片打马赛克,让你拼不出来。安全聚合就是让服务器只能看到所有梯度的总和,看不到单个医院上传了什么。
但这俩东西一加,模型的准确率就会往下掉。噪声加得越多,隐私保护越好,模型越笨。这是一个痛苦的权衡曲线。我们当时做胃癌早筛模型,加了中等强度的差分隐私,AUC(衡量模型好坏的指标)从0.92掉到了0.87。别小看这0.05,在临床辅助诊断里,可能意味着几百个漏诊或误诊。老周看着那个数字,半天没说话。
这也是我想说的第一个误区:隐私计算技术不是免费的午餐,它用计算开销和模型性能来换取合规和安全。 如果你看到一个方案吹嘘“无损隐私保护”,基本可以判断,要么是骗子,要么是傻子。
落地里那些鸡飞狗跳的细节
技术原理聊完了,听着挺美是吧?真到部署的时候,那叫一个鸡飞狗跳。
首先,网络问题。三家医院,分别在鼓楼、江宁和江北。专线互联,延迟不一样,带宽不一样。联邦学习是同步更新参数,A医院算完了,得等B医院。B医院那边刚好赶上门诊高峰,内网带宽被挂号系统占满了,参数上传卡了十分钟。A医院这边就干等着。整个训练过程,比单机慢了几十倍不止。
其次,数据异构问题。同样是胃镜图像,鼓楼医院的设备是奥林巴斯,江宁医院是宾得,拍出来的色调、分辨率、甚至文件格式都不一样。这导致每家医院训练出来的模型,在本地表现很好,一聚合到全局,效果就往下掉。术语叫“Non-IID数据分布”,翻译成人话就是:各家吃的东西不一样,凑在一起吃饭,肠胃容易不合。
最要命的是激励问题。你凭什么让三家医院把自己的数据贡献出来训练一个模型?模型训好了,归谁?如果鼓楼医院贡献的数据最多,模型在它那里表现最好,它凭什么跟江宁医院分享?后来我们搞了个“贡献度评估”机制,用Shapley值去量化每家数据对模型的贡献,按贡献分配未来的收益。这东西理论很漂亮,实操起来又是一堆扯皮。
 多方安全计算 联邦学习 医院部署 网络拓扑图
边界在哪里?这玩意儿不解决所有问题
说了这么多,得泼盆冷水。隐私计算技术再厉害,它也有边界。
它能解决“数据不出域”的协作计算问题,但它解决不了“数据本身质量差”的问题。你医院的数据标注就是错的,隐私计算再牛,训出来的模型也是错的。它还能解决“合规审计”的问题,但解决不了“人性”的问题——如果内部人员想卖数据,他直接拍照带走,你什么计算技术都白搭。
还有一点,很多人以为隐私计算技术是“一劳永逸”的合规盾牌。错了。它只是技术手段,法律上是否合规,还得看具体场景。比如《个人信息保护法》里提到的“匿名化”,隐私计算处理后的数据算不算匿名化?目前法律界和产业界还在吵。你在技术上实现了“不可逆”,但法律上可能依然认定它是个人信息。
所以,回到老周那个问题。我最后给他的方案是:先做一个小范围试点,只纳入三家医院共有的、标注质量最高的五千例数据。不用大规模联邦学习,先用MPC跑一个逻辑回归模型试试水。算力成本能接受,数据量小,合规风险低。等跑通了,再逐步扩大。老周这才点了头。
这行干久了,我越来越觉得,隐私计算技术更像是一套“协调工具”,而不是“魔法棒”。它让原来不可能的合作变得可能,但合作中的扯皮、猜忌、利益分配,一点都没少。技术把路的坑填平了,但走不走得通,还得看开车的人。
如果你也在琢磨这块,我的建议就一条:别一上来就追求最先进的密码学协议,先看看你的业务场景里,最需要保护的是什么,最坏的结果是什么。 从简单的方案开始,让数据先合规地流动起来。流动起来,价值才会慢慢长出来。至于那些复杂的密码学,交给专业的团队去折腾吧。
行了,就聊到这儿。我得去改那个该死的差分隐私参数了,老周又催着看新一版的模型效果了。这活儿,真是一点都不让人省心。