给数据织一张会记路的网:知识图谱构建里的土办法、暗坑和边界
去年冬天,我在一个风电场待了三天。不是去旅游。风机在山上,风像刀子。老师傅指着齿轮箱说,轴承温度过了八十五,再撑二十分钟,基本就得拆。可他下个月退休。这些判断在微信语音里、在巡检本的边角上、在别人脑子里。你要把它塞进系统,靠一张 Excel?Excel 只会告诉你,备注栏写着“有异响”。这就是知识图谱构建很真实的起点。
别急着上大模型。也别急着画漂亮的本体图。先问自己,这张网要捞什么鱼。
它不像数据库,更像一张会记路的网
关系型数据库像一个个抽屉,按字段放东西。知识图谱更像一张地图。地图上有地点,有路。地点是实体,路是关系。风机是一个实体,风场是一个实体,“属于”是一条路。轴承是一个实体,“温度异常”是一个状态,它们之间也能连。连起来之后,你可以问:这个风场里,哪些设备出现过类似故障?谁修的?换了哪家供应商的件?
单表查询也能做,但多跳之后会写死人。图谱擅长的是多跳关系。比如 A 风机由 B 供应商供齿轮箱,B 供应商也给 C 风场供货,C 风场有台机器用了同一批轴承,而那批轴承在 D 维修记录里出过问题。你顺着边走,几步就到了。表格得 join 到天亮。
不过,图不是免费午餐。它把结构显式化了。显式化的代价是,你得先约定:什么是设备?什么是故障?子设备算不算独立实体?这些约定叫本体。本体不是学术摆设,它是抽屉上的标签。标签乱了,后面全乱。
 风电场设备知识图谱节点关系示意图
我见过一个内部图谱,节点叫“设备”,边叫“属于”,然后呢?然后就没了。因为建图的人只关心技术栈,没关心业务问题。图数据库装上了,查询跑得飞快,可没人用。冷启动不是技术冷,是问题冷。
脏数据进来,错误会沿着边散步
知识图谱构建的流水线,平时被讲成:抽取、融合、存储、推理。听着像高铁站广播。落到工位上,就是一堆麻烦。
实体抽取:从工单、手册、聊天记录里找出“齿轮箱”“王工”“SKF 轴承”。合规文本还好,聊天记录里全是黑话。“老地方那台又响了”,你抽谁?
关系抽取:判断“A 导致 B”“A 属于 B”“A 由 B 维修”。大模型能帮不少忙。但别全信。它会把“A 设备由 B 供应商供”抽反,变成“B 设备由 A 供应商供”。这种错误进图以后,下游追责、采购、排障全歪。图不会自己知道错,它只会把错的关系传得更远。
实体消歧:两个“王工”是不是同一个人?一个“SKF 轴承”和一个“斯凯孚轴承”要不要合并?合并错了,知识串门;不合并,知识孤岛。这里没有魔法,只有规则、嵌入相似度、人工审核。说实话,人工审核很土,但省不掉。
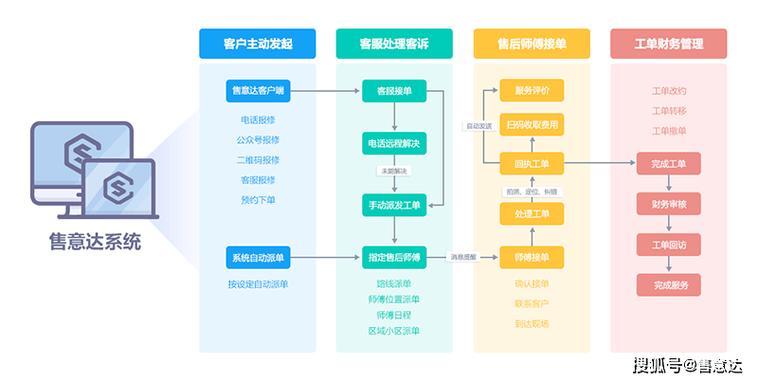 工业客服工单实体消歧对齐流程图
我参与过一个客服图谱。上线两周,发现“退款”被连到了“物流延迟”和“商品破损”两个原因上。看起来挺智能。实际上,因为一条模板话术里同时出现两个词,模型硬拉了一条边。后来加了一条规矩:每条关系必须带证据。证据就是原文片段、时间、来源。没有证据,边不进库。这一下,图谱瘦了一半,但能用了。
所以,质量评估别只看节点数、边数。那东西像体重,不代表健康。要看准确率、覆盖率、一致性,还要看业务方愿不愿意用。
真落地时,麻烦常常不在算法
 真落地时,麻烦常常不在算法
算法很显眼,工程很磨人。本体版本一多,旧图怎么办?迁移还是重建?权限怎么控?A 部门能看到 B 部门的维修记录吗?图查询和现有报表怎么打通?这些事不写论文,但决定图谱能不能活过三个月。
应用场景倒不少。设备维修里,图谱可以帮新人找相似故障;金融风控里,能顺着股权、担保、交易路径找团伙;医疗里,辅助梳理症状、药品、禁忌;客服里,把工单、产品、政策连起来。但别把图谱当锤子,看什么都像钉子。如果问题只是“查上个月销量”,用关系表更省事。
风险也真实。图谱会放大偏见。如果历史维修记录里,某类设备总被误判,图谱会学得理直气壮。隐私更麻烦。把人和关系连起来,可能连出不该连的东西。还有大模型加图谱,听起来很美:模型负责问,图谱负责给依据。但如果图谱本身脏,模型只会用更流畅的口气说错话。
如果让我重新搭一次
 如果让我重新搭一次
我会先找一个小问题,小到能在一周内看到反馈。比如:同型号设备过去半年在哪些工况下出过故障?然后只建这一小块本体。设备、部件、故障、工况、维修动作。关系不要多,够用就行。
抽取时,规则先上。正则、词典、模板,能覆盖六成先覆盖六成。剩下交给模型,但模型输出必须带置信度和证据。低于阈值,进人工队列。人工审核别做成一次性运动,做成日常流程。谁用,谁审,谁负责。
存储可以用图数据库,也可以先用关系表模拟。别为了图而图。等真的出现多跳查询、路径分析、关系推理,再上图数据库。查询语言比如 Cypher、SPARQL,学起来不难,难的是知道该问什么。
还要留一条退路。图谱不是真理,它只是当前证据下的一个视图。要能标注冲突,能回滚,能追溯到原文。这样出错时,你知道是抽取错了,还是源头就错了。
那张网不会自己长好。它需要有人修剪,有人喂料,有人承认自己不知道。把老师傅嘴里的“八成是轴承”变成可查询的关系,比调参难多了。可一旦跑通,它就不只是数据。它是组织的记忆。
对了,别忽略老师傅。图谱构建到了后期,往往不是模型缺数据,是人缺信任。让他愿意把经验说出来,比多买几张 GPU 更值钱。