模型在实验室里封神,上线就发疯:深度学习技术里那道没人愿意讲的坎
见过一个挺魔幻的场面。
某个推荐模型,离线评测拿下零点八九的AUC,团队里谁看了都点头。上线三天,点击率纹丝不动,甚至还掉了零点几个点。复盘会上翻日志、查部署、重跑训练,折腾两天两夜,最后查出来的原因朴素得让人想骂人——训练用的那批数据里,有一条特征在线上压根取不到值。
就这么简单。也这么要命。
它到底在干一件什么活
很多人把神经网络想象成一台会思考的机器。不是。它更像个特别勤奋的背题选手。
你喂它一堆「输入 x、输出 y」的样本——用户点了没点、图片是猫是狗、这句话是夸还是骂。它要干的事只有一件:找一组参数,让这些样本上的答案尽量对得上。为什么是「尽量」?因为真实数据里噪声太多,硬背下来反而坏事,这就是所谓的泛化。
训练的过程,说白了就是爬山。损失函数是那座山的高度,梯度告诉你哪边是下坡,学习率决定你一步迈多大。迈小了,一晚上走不到山脚;迈大了,一脚跨过谷底翻到对面坡上,来回震荡。所以才有动量、有自适应步长、有一堆花哨的优化器——本质都在解决「怎么走得更稳」这一件事。
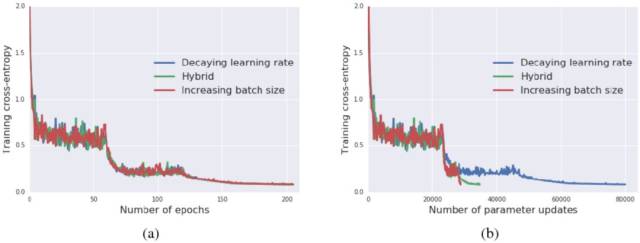 深度学习模型训练集与验证集损失曲线对比图
问题出在哪呢。它学的是你给它的那批数据里的规律,不是这个世界的规律。这两者之间那道缝,就是所有落地事故的源头。
缝隙有好几条,一条比一条阴
头一条叫分布漂移,好理解。你拿去年双十一的数据训练,今年双十一的玩法换了、投放渠道换了、用户结构也换了,模型的输入分布整个挪了位,它原来记住的那套对应关系自然就失效了。
更难缠的是第二条,数据泄漏。业内管它叫「特征穿越」,我觉得这词儿起得挺传神。举个我亲眼见过的例子:有人做下单预测,特征表里塞进了一个「订单创建时间」。离线跑出来效果惊人,因为下单的用户和没下单的用户,在这条特征上的分布完全不一样——一边有值,一边是空。模型乐坏了,直接学会看这条特征下判断。
可上线那一刻呢?预测发生在用户下单之前。这条特征在服务端根本还不存在。模型等于是在考试前就看到了答案,考场上当然抓瞎。
 机器学习特征穿越导致数据泄漏流程示意图
还有一种更隐蔽的。做特征归一化的时候,图省事拿全量数据的均值方差去算。这一算,验证集的信息就顺着统计量渗进训练里去了。离线指标虚高一大截,你还以为是模型变强了。
第三条,反馈回路。这个在推荐和搜索里特别常见。系统上线之后,只有它推出去的东西才可能被点击,模型只能看到自己制造出来的那部分数据。时间一长,它越来越确信自己那套判断,推荐面越收越窄。用户抱怨内容单调,你还以为是召回策略的问题。
为什么修起来这么费劲
 为什么修起来这么费劲
传统软件里,你改一行 if,行为立刻确定。深度学习不是这样。模型的「逻辑」摊在几千万个浮点数上,没有任何一个是你能指着说「就是它坏了」的。它是一整片地形,动一个角落,别处跟着晃。
还有评估这件事。离线指标涨了,线上不一定涨。为什么——离线那份测试集是历史的、冻结的,而线上是活的、每分每秒都在变。你拿一张旧地图去找一条新修的路,找不到太正常了。
我后来养成一个习惯:任何模型上线前,先问一句——这条特征在预测发生的那一瞬间,服务端真的能拿到吗?就这一句话,帮我拦下过好几次事故。听起来像常识,但人在赶进度的时候,常识往往是最先被牺牲的东西。
那它不该干什么
 那它不该干什么
有些场景,真别硬上。
小样本、强规则、可解释性要求高——比如信贷审批里要给用户一个明确的拒绝理由,你总不能跟监管说「模型觉得你不像好人」。这种地方,一个逻辑回归加几张规则表,反而更让人踏实。
还有一种误区,觉得算力堆上去,理解就自动来了。那个流行的说法是规模越大损失越低,对,没错。可它没说清楚,降下去的那部分到底是不是你要的东西。模型能把「巴黎是法国的首都」背得滚瓜烂熟,跟它真的知道巴黎在哪儿、法国有多大都扯不上关系。
所以啊,别指望它理解世界。它只是在那一小片你给它的数据上,找到了一条走得通的曲线。而你要做的,是保证那条曲线描述的那条路,在真实世界里也确实存在。这件事,模型帮不了你。