优化算法应用:从实验室黑盒到加速器调束,科研里它到底怎么落地
上周和一位做催化剂的朋友吃饭。我问,你们组现在发论文,参数还靠手调吗?
他愣了两秒。
“早就不是了。”
行吧。那今天就聊聊优化算法在科研里到底怎么用——不是教科书上那种,是真刀真枪跑在实验室和超算上的那种。
先掰扯清楚:优化算法到底在解什么问题
说白了,大部分科研场景可以抽象成一句话:有一个函数 f(x),你给它一个输入 x,它吐一个数出来。你想要那个数尽量小,或者尽量大。麻烦在于——这个 f 你写不出解析式,而且每算一次都得花你半天、半个月,或者三万块钱。
这就是所谓的黑盒优化。x 是实验条件:温度、配比、pH、退火时间、激光功率。f 是产率、强度、选择性、能量密度。计算一次,可能是一轮 DFT,也可能是一次真实的合成。
优化的全部意义,就是用尽量少的评估次数,找到尽量好的 x。
注意“尽量少”这三个字。它才是关键。如果 f 便宜得像查表,你直接穷举就完了,根本轮不到什么高级算法登场。
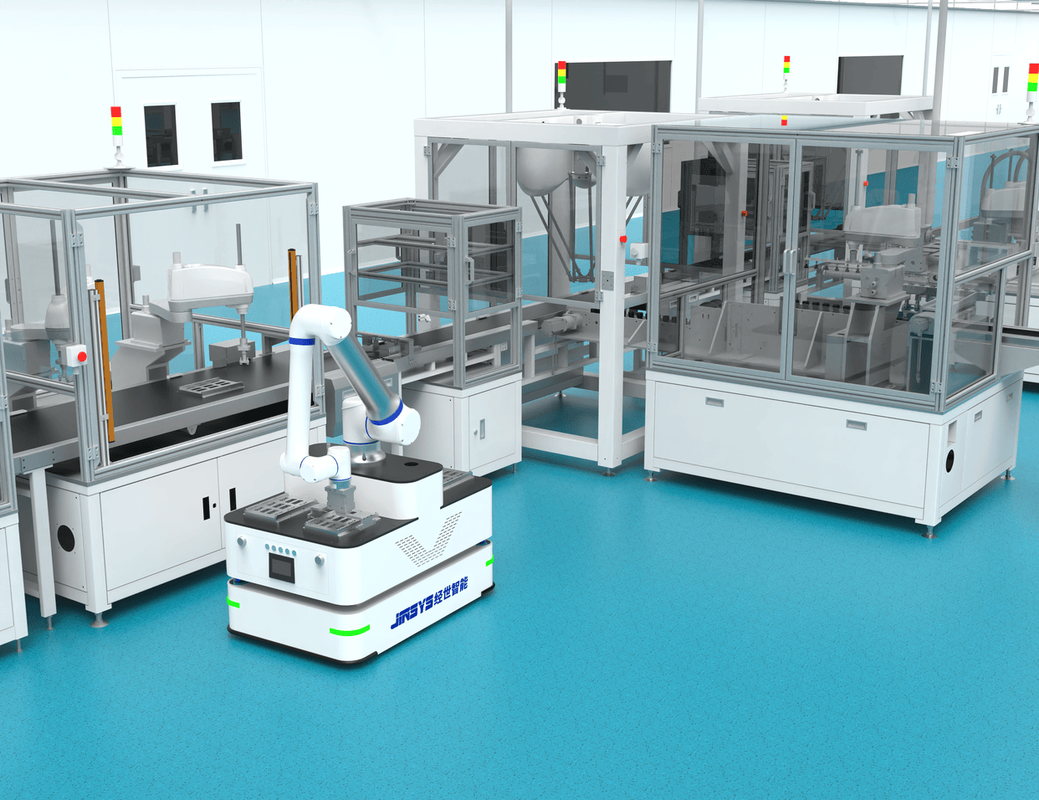 自动化材料实验室机器人高通量合成实验平台
实验室里的黑盒,是被贝叶斯优化一口一口啃下来的
贝叶斯优化这几年在科研圈火得离谱,不是没道理的。
思路其实特别朴素:既然每次实验都很贵,那我先用已有的实验点,拟合一个“大概长什么样”的代理模型——一般用高斯过程。然后别急着做实验。先让模型自己“幻想”哪里可能出好结果,哪里是它自己最没把握的地方。这两个愿望合起来,就是采集函数。经典的叫 EI(期望改进),还有 UCB、PI 这些版本。
挑采集函数最大的那个点,去做实验,拿到结果,更新模型。循环。
就这么点东西。
但它真的管用。伯克利那个 A-Lab 就是典型。机械臂加主动学习,17 天连续自主运行,跑了几百次实验,从几十个候选里成功合成出四十多种新材料。人类研究员干嘛去了?睡觉去了。
不过我得说句公道的——高斯过程这东西,维度一高就露怯。
x 只有五六维,它好使得很。到了二三十维,GP 就开始吃力,核函数选得不对还会给你演一出“过拟合噪声”。这时候换 TPE(树状 Parzen 估计),或者拿随机森林当代理,往往更稳。Optuna 里默认就是 TPE,这不是随便定的。
 贝叶斯优化代理模型采集函数迭代采样示意图
加速器和芯片:控制室被悄悄接管了
 加速器和芯片:控制室被悄悄接管了
有意思的是,另一条技术路线在完全不同的场景里跑得更猛——强化学习。
它的逻辑和贝叶斯优化不太一样。贝叶斯是“我挑最值得试的那个点”,强化学习是“我学一个策略,看到当前状态就知道下一步该动哪个旋钮”。前者像谨慎的实验员,后者像练出来的老师傅。
粒子加速器调束是个绝佳例子。几百个磁铁参数,彼此耦合,人调起来要几个小时甚至几天。SLAC、CERN 都做过用强化学习或者贝叶斯方法自动调束的工作,目标是把束流损失、发射度这些指标压下去。效果?调出来的束流品质,有时候比人调的还稳,而且快得多。
还有芯片布局。Google 2021 年那篇 Nature,把宏单元摆放当成一个带约束的优化问题,用强化学习去摆,顺手把布局过程本身做成了“边”的图结构——这招很聪明,因为电路的拓扑关系本来就在连线上,不在节点上。
说实话,这类工作最打动我的不是算法多玄乎,而是它们把人的经验编码进了搜索空间。人还是重要的。只是从“我来调”变成了“我来规定哪些能调”。
翻车现场:这些坑我见过太多次
好了,泼冷水时间。
第一,目标函数写错,算法只会更勤快地把你想沟里带。 优化器是个没有常识的执行者。你告诉它产率越高越好,它就真敢给你找出一堆产率 99% 但全是杂质的条件。纯度不加约束?它不管。
第二,噪声。 生物实验、催化实验的方差大得吓人。同一批条件重做,结果差 20% 很常见。高斯过程默认观测带噪声,但你得把噪声水平估对,不然它会把随机波动当成真实信号,越优化越离谱。这种情况要做重复实验,或者换对噪声更鲁棒的方法。
第三,维度。 超过二十维就别硬上 GP 了。真到了几百维,学不动就是学不动,别跟它较劲。
第四,很多人忘了设 baseline。 2012 年 Bergstra 和 Bengio 那篇论文早就讲过,随机搜索在很多场景下能打赢网格搜索,成本还低得多。可直到今天,仍有人一上来就贝叶斯、遗传、粒子群轮着上一遍,结果连随机搜索那条线都没画。这就很尴尬了。
第五,可复现性。 随机种子、初始点、早停策略,都得写进论文。优化算法本身也是实验,也要报告配置。不然别人复现不出来,前面那些努力就白搭。
如果你正准备动手
几句实在话。
先跑随机搜索。真的,先跑。花不了多少成本,还能给你一条参照线。之后的每一次算法改进,都拿它来比。
再就是,把每一次实验都记下来,失败的也算。优化算法吃的是数据。你那些“没成功”的点,对代理模型来说全是信息,扔掉太可惜。
还有一点我想强调:别把先验当作弊。划定搜索边界、排除掉明显不合理的区域、告诉算法某些参数必须成对变化——这些都是科研人员该做的事。纯黑盒、零先验的优化,在真实实验里往往又慢又蠢。
最后。
我见过最漂亮的一个用法,是在一个做电解质的组里。他们没把优化器当成“帮我们找最优配方”的机器,而是把它当成一个爱挑刺的合作者:每次它推荐的条件,都跟人的直觉对着干,然后逼着人去想“为什么它选了这个”。
结果有几次,真被问出了新东西。
这个价值,比省下来的那几十次实验,大得多。