技术风险识别:那行没人看的 warning,是怎么长成一次线上雪崩的
周五晚上十一点四十。我正准备关电脑,手机在桌上震了一下。不是告警。是同事在群里发了一句:用户反馈下单页转圈。
三分钟后,整个订单服务超时率飙到 60%。
诡异的地方在于——监控大盘干干净净。CPU 不高,内存不高,QPS 平稳,所有告警阈值一个都没碰。就像一个人血压心率体温全正常,忽然倒了。
第二天复盘,翻日志翻到下午三点十七分,有一行 WARN:连接池 active 连接数达到 180,pool size 200。就这一行。然后就没了,因为后面几小时的采样都掉回了 40 左右。
有人截图发群里了。真的。一个实习生发的。群里没人回。
我要说的技术风险识别,不是列个清单打钩那种。是这件事——为什么一条要命的信号,明明被捕捉到了,却还是从所有人眼皮底下溜过去了。
信号不是没出现,是被过滤掉了
我们总以为风险识别的难点在"发现"。其实大部分时候,信号早就在系统里飘着了,问题出在它被一层一层削减成了背景噪音。
哪几层?
第一层是日志级别。开发为了排查另一个问题,把某个包的日志调成了 ERROR,顺手把 WARN 也吞了。没人记得改回来。
第二层是阈值。我们习惯把告警设成"连续五分钟超过 80%"。听着挺合理对吧?可连接池这种东西,它涨上去、掉下来、再涨上去,中间只要有一秒回落,计数器就归零了。你等的是一个永远不会出现的"持续"。
第三层最阴——人的脑内过滤。
一个每天响二十次的告警,人会自动学会忽略它。这不是态度问题,是生理问题。你的大脑在保护你。所以真正危险的不是信号弱,是信号和一堆垃圾信号长得一模一样。狼来了这个故事,本质上讲的不是狼,是信噪比。
 运维监控告警大盘深夜线上故障截图
那天下午那条 WARN,长得就很像噪音。它没有说"我快满了",它说的是"我看到 180 了"。这两句话在工程师眼里差别巨大,但在一个刷到第 47 条群消息的人眼里,一样。
风险怎么长大的:慢变量、耦合、和平均值撒谎
 风险怎么长大的:慢变量、耦合、和平均值撒谎
你去看真正把系统搞挂的,很少是那种"咔嚓"一下断掉的东西。它们多数是慢的。
连接池泄漏,一天漏三个连接。按这个速度,二百的连接池要两个月才满。没人会为两个月后的事紧张,尤其当这两个月里它一直没事。这就是慢变量的坏处:它的危险性随时间的推移在增加,但你的紧迫感在下降。
还有一种是耦合。你升级了一个不起眼的依赖,小版本号。你的代码没动。但你调的那只是你自己的代码,别人库里的线程池策略变了。这种事在测试环境永远测不出来,因为测试环境的并发量小到根本触发不了那套线程池。
但我想重点聊平均值,因为它是骗人骗得最狠的那个。
那个报表接口上线前,我们做过压测。平均响应 80 毫秒,漂亮。但它占连接 3 秒。平均 QPS 也没变。所有指标都好看。
问题就在这。一个系统里,平均值是最没有信息量的统计量。
一条河平均水深一米。你走过去,照样淹死。
你要看的是 P99、是长尾、是那一小撮把连接占着不撒手的请求。可我们做技术风险识别的时候,第一反应永远是去看大盘的那个均值曲线。它平稳,它就让人安心——哪怕它平稳的原因,是坏消息和好消息正好互相抵消了。
最容易被漏掉的那类风险,藏在不属于任何人的地方
这句话我想了很久。
系统里有些模块,谁都碰过,谁都不熟。它的 owner 去年离职了,代码还在跑,文档是两年前的,注释里写着 TODO。平时没事。你识别风险的时候会跳过它,因为你不知道该看什么,也因为看它没有回报——看它一小时,什么都发现不了,这是很自然的。
但风险往往就爱待在这种地方。没有主人,就没有人定期去问一句:你还正常吗?
还有一种更隐蔽的——依赖的依赖。
你用的那个库,好几年没更新了。你知道这件事,但你判断"稳定"。可稳定的另一种说法是:没有人在修它了。哪天爆出一个漏洞,没有补丁,你要么自己 fork,要么整个换掉,要么硬扛。
第三方的接口也是。某天对方悄悄把限流从每秒一百改成了五十。没有任何通知。你的重试逻辑开始发疯,重试又加重了对方的限流,几分钟内自己把自己打死了。这种事,你光看自己的监控,永远看不出因果。
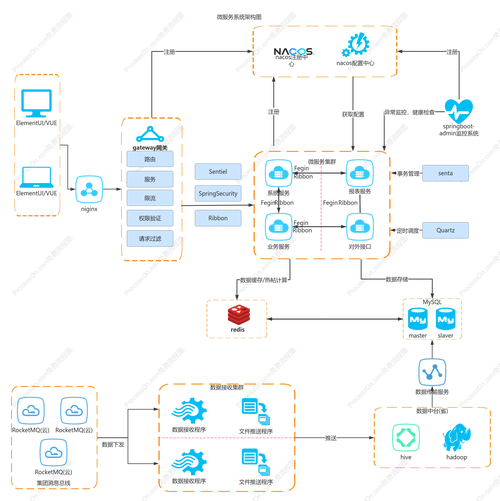 微服务依赖调用链路拓扑关系可视化图
别指望全覆盖,那只会让人麻木
 别指望全覆盖,那只会让人麻木
这里得说个反直觉的。
很多团队做技术风险识别,第一件事是列一张大表,几十上百行,每行一个风险项,打分、排优先级、定期评审。做了一年,表还在,系统该挂还是挂。
为什么?因为那张表的作用是让人安心,不是让人清醒。清单越长,每一项的注意力就越薄。到最后,评审会变成念表格。
我个人的做法很土:只盯关键路径,问三个问题。
这条路上,什么东西一旦坏了,用户立刻有感觉?
这个东西最近有没有被动过?
坏了之后,我能不能在十分钟内退回去?
第三个问题最值钱。能快速回滚的系统,风险等级天然低一档。不能回滚的,哪怕它今天稳如老狗,也得天天看着。
说白了,技术风险识别的边界不在于"找出所有风险"——那不可能,也不必要。它在于把关键路径上的未知压缩到最少。别的都可以先放着。真的。
回到那个周五晚上。
后来我们做了改动,不多。把连接池的告警从"达到 180"改成了"近一小时内有三次超过 120",并且把它单独拉到一个频道,和那两百条日常噪音分开。就这么点事。
再往后半年,它响过两次。两次都真有事,两次都提前四十分钟。
所以我现在越来越觉得,技术风险识别这件事,大部分功夫不在加监控、不在写文档、不在画那张漂亮的矩阵图。它在于——让真正重要的东西,长出一副能被一眼认出来的样子。
信号一直都在。缺的是让它别混在人群里。