实验室里99.2%,上线第三天就翻车:计算机视觉技术里那个不讲道理的东西
前年冬天,我们给一家做紧固件的厂子装视觉质检。样机阶段跑出来的数字漂亮得让人心虚——F1 0.99,误检率低到可以忽略。老板当场拍板。三周后,产线主管打来电话,语气不太客气:你们那台机器,现在把良品全判成废品了。
我第一反应是不可能。模型没动过,权重文件还是那个哈希值。跑回现场一看,我闭嘴了。
他们把车间顶上那批老卤素灯换成了LED白光。亮度上去了,色温变了,金属表面的高光位置整体挪了几毫米。就这几毫米。
它看到的根本不是“螺栓”
很多人脑子里,计算机视觉技术大概是这么运作的:摄像头拍一张,机器认出来“哦,这是螺栓,这道划痕不合格”。不是的。差得远。
图像进到网络里,先被拆成一堆数字。每个像素不过是0到255之间的三个数,红绿蓝。然后卷积层上场——名字听着唬人,干的事其实很朴素:拿一个小窗口(比如3×3)在图上滑来滑去,把窗口里九个数字加权求和,写成一个新的数。所谓卷积,就是不停地做加权求和。滑完一层,再滑下一层。层数堆上去,网络能表达的东西越来越抽象:前几层可能只认得边缘和色块,中间层开始对纹理、角点敏感,深层的特征图里,才隐约有了“这个区域像螺纹”的味道。
 工业产线相机LED光源打光检测金属螺栓表面缺陷实拍
问题就在这儿。网络学到的不是“螺栓”这个概念,它学到的是一组统计规律:在这个光照下、这个镜头下、这个距离下,合格品的那一堆像素长什么样,不合格品的那一堆又长什么样。你把灯换了,那组规律就作废了。它照样输出一个置信度0.98的答案——只不过答案是错的。
这个现象有个名字,叫域偏移,英文domain shift。学术界写了无数论文,工程上栽了无数跟头。说白了就一句话:训练时看到的那个世界,和部署时面对的那个世界,不是同一个世界。
我常拿方言打比方。你在南京待了二十年,南京话听得门儿清。突然把你空投到温州某个菜市场,耳朵里全是音,你一个字抓不住。不是你耳朵坏了,是你脑子里的统计模型对不上号了。模型也一样,它没有“人话”这个底座,只有“我见过的那批数据”。
数据这座冰山,露出来的那一角全是假象
接着聊数据。这是我最不愿意聊、又不得不聊的部分。
做算法的人容易犯一个毛病:拿到一个标注好的数据集,看一眼类别分布,觉得挺均衡,开训。可真实产线上的分布长什么样?合格品占99.7%,缺陷品里,划痕一大把,气孔偶尔有,而那类真要命的裂纹——三个月才出三件。
三件。你用三张图训出来的模型,指望它在现场抓住裂纹?它抓不到,它连裂纹长什么样都没概念。更糟的是,它会在训练集上“学会”一个捷径:反正绝大多数样本都是合格品,那我无脑判合格好了——准确率照样99.7%。这种模型在离线指标上看着无懈可击,一上线就原形毕露。
所以后来我养成一个习惯:拿到数据集,先不看整体准确率,先按类别把样本数从少到多排一遍,盯着尾部看。尾部有几十张的,能用;个位数的,一律当作没数据。
再说标注。标注这活儿,是良心活。同一道划痕,张三标了,李四觉得不算,王五标了个更大的框。三个人标出来的三版数据,训出来的模型脾气完全不一样。我见过一个项目,只改标注、重训一遍,指标涨了七个点——一行代码没动。很多时候你缺的不是更强的网络,是更干净的标签。
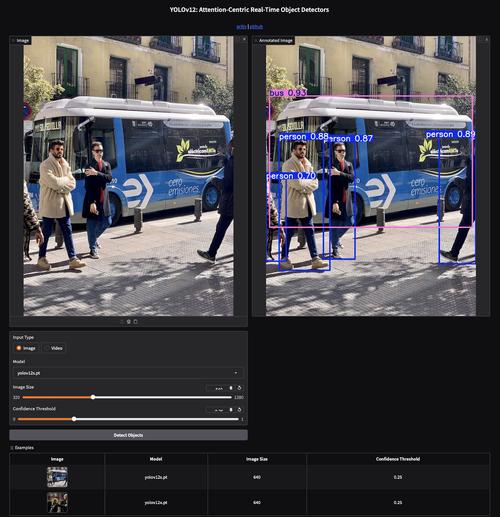 计算机视觉目标检测模型标注框漏检误检对比截图
跑得动,才是真本事
 跑得动,才是真本事
学术圈看mAP,产线上看节拍。
一条线一分钟出六十个件,留给你的时间窗口不到一秒——还得扣掉相机曝光、图像传输、PLC通信的时间。真正能拿来推理的,可能就两百毫秒。这时候你会发现,那些在公开数据集上刷得飞起的重模型,一个都用不了。
于是就得做取舍。剪枝、蒸馏、量化,把FP32压成INT8。量化这事儿特别有意思:模型体积砍掉四分之三,速度快上两三倍,代价是精度掉一两个点——但偶尔会在某个特定样本上掉得莫名其妙,你得一个个case去捞。这个过程一点也不优雅,纯粹是体力活。
硬件也讲脾气。相机曝光的触发信号和产线编码器之间差半毫秒,图像就是糊的;镜头上一层油雾,对比度就塌了;夏天车间四十度,工控机降频,帧率跟着掉。这些事,没有一样写在论文里。
几个流传挺广的误会
 几个流传挺广的误会
误会一:数据越多越好。不一定。一万张八月下午拍的图,干不过三百张覆盖了早中晚、阴晴雨、不同班次、不同来料的图。分布比数量重要得多。数据采集这件事,得当成排班表来设计,而不是当成囤货。
误会二:模型越大越准。在服务器上成立,在产线边缘盒子上不成立。你缺的往往不是参数量,是算力和内存带宽。
误会三:视觉能替人眼。人眼看一眼就知道“这个零件放歪了”,因为你有物理常识。模型没有。它只看像素,你得把“歪”这件事翻译成它能算的东西——坐标、角度、像素距离。凡是需要常识判断的场景,模型都在裸奔。
误会四:上线就完事了。这才是噩梦的开始。换一批来料,供应商的镀层配方改了,季节变了,镜头老化了……性能会一点点漂,漂得悄无声息。没有一套线上抽检加定期回流再训练的办法,模型撑不过半年。
它到底理解了什么
 它到底理解了什么
说点冷思考。
今天这些模型,本质上是在高维空间里画分界线。给它一张图,它算出落在线的哪一侧。它没有“螺栓”这个概念,它不知道螺栓是用来拧的,不知道它掉在地上会响。它做的是相关性,不是因果。
这带来的麻烦不止精度。往图上叠几个精心构造的像素噪点,人眼看着毫无变化,模型能给你判成完全另一个类。所以现在做医疗影像、自动驾驶这类场景,没有人敢让模型单独拍板,都要留一个“人兜底”的环节——不是因为不信任技术,是因为知道它的失败模式太诡异了。
还有合规。人脸相关的应用,这几年被反复讨论,边界在收窄。这不是坏事。一个能干活的工具,和一个随时随地能被调用的工具,中间隔着的不是技术,是制度。
所以我现在接项目,开场问的头几个问题不是“你们想要什么功能”,而是——你们的灯会不会换?镜头多久擦一次?来料有几个供应商?缺陷里头,哪种是绝对不能漏的?
问完这几个问题,方案基本上就定了一半。
模型那部分,反而是后面的事。