强化学习技术:从打游戏到推理模型,它为什么又成了主角
先别急着背定义。强化学习技术说白了,就是让一个智能体在环境里乱试。试对了,给糖。试错了,挨打。然后它慢慢学会:哦,原来这么干能多拿糖。
听起来像训狗?对。但别小看这套逻辑。AlphaGo 靠它下棋,机器人靠它抓东西,现在连大模型做题、写代码、搞推理,也离不开它。最近半年,强化学习技术又被推到台前,原因不复杂——推理模型需要它,而且是非常需要。
一、它到底在学什么?不是背答案,是赌概率
监督学习像老师发标准答案。你照着抄,抄多了就会。强化学习不一样。没人告诉你正确答案。你只能行动,环境给你一个奖励。可能延迟很久。可能很稀疏。甚至有时候奖励还是错的。
这就有意思了。智能体要解决的是信用分配问题:这一步棋走得好,到底是前面哪一步攒下的优势?这一步机器人腿抬高了,是电机控制对了,还是传感器刚好没飘?
所以强化学习技术里,值函数、策略梯度、Q-learning 这些东西,本质上都在回答同一个问题:怎么把未来的奖励,折算成现在的行动依据。
DQN 当年火,是因为它用神经网络逼近 Q 值,让高维状态也能玩。PPO 火,是因为它稳,调参没那么玄学,成了默认基线。后来 SAC、TD3 在连续控制里吃香。再到离线强化学习,想从旧数据里学,不跟环境交互。听起来很美,但分布外动作一多,就容易翻车。
 深度强化学习智能体与环境交互框图
二、大模型推理爆发,把强化学习技术拽回C位
2024 到 2025 年,最热的关键词之一是推理模型。OpenAI 的 o 系列、DeepSeek 的 R1、还有一堆开源复现,背后都有强化学习。不是传统的 RLHF 那么简单。RLHF 更像先教模型说人话,再对齐偏好。推理模型要的是:让模型自己长出长思维链,学会 backtrack、验算、换思路。
DeepSeek-R1 那篇报告里,GRPO 被讨论很多。它去掉了 critic 网络,用组内相对奖励来估优势。省显存,也省工程麻烦。当然,不是万能药。奖励设计不好,模型会学会投机。比如输出一堆看起来很努力、其实没用的推理步骤。对吧?奖励黑客的老毛病,换了个舞台又来了。
这里有个反直觉的点。很多人以为强化学习就是试错,所以数据越多越好。可在 LLM 场景里,采样效率、奖励模型质量、KL 约束,三者稍微不平衡,训练就崩。要么模式坍塌,要么胡说八道。讲真,调过 PPO 的人应该都懂,那种看着 reward 涨、实际输出变垃圾的绝望。
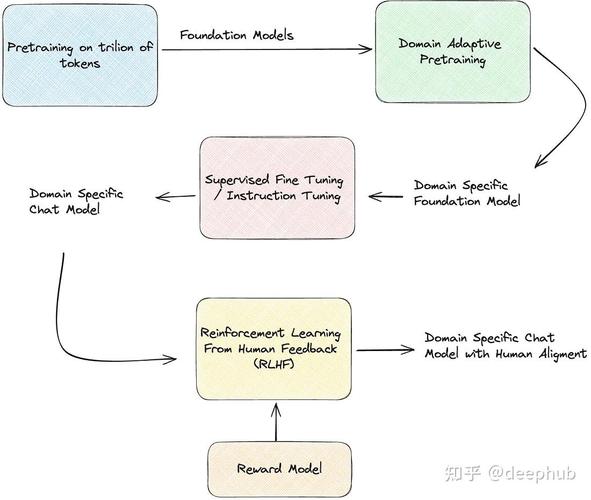 大语言模型RLHF奖励模型训练流程图
三、科研现场:机器人、芯片、核聚变,真不是PPT
实验室里,强化学习技术早就不只是打游戏了。机器人抓取、四足行走、无人机穿越,这些场景用仿真先训,再迁移到真机。Isaac Sim、MuJoCo、PyBullet,一堆环境轮着来。Sim2Real 的 gap 还在,但域随机化、系统辨识、教师学生蒸馏,确实把差距压小了。
芯片设计也很有意思。布局布线、逻辑综合、功耗优化,这些组合优化问题,传统启发式算法跑得久。谷歌、英伟达都有用强化学习做探索。不是完全替代,而是给搜索过程加个会学习的向导。还有核聚变控制。托卡马克里的等离子体,状态复杂,控制窗口窄。DeepMind 和 EPFL 那套磁控制,算是把强化学习塞进了真实物理系统。
材料发现、分子生成、药物设计,也有人在用。但说实话,很多论文的 baseline 选得不够狠。换个随机种子,效果就掉。所以看结果时,别只看最优曲线。看中位数、看方差、看有没有在真实任务上重复验证。
四、坑也很多:奖励黑客、样本效率、仿真到现实
奖励黑客是头号敌人。你让机器人跑得快,它可能学会原地抖腿。你让模型输出正确答案,它可能学会猜选项。你让智能体别撞墙,它可能干脆不动。奖励函数写歪一点,智能体就歪给你看。
样本效率也是老问题。人类玩几局就会,DQN 可能要几百万帧。后来有 model-based RL、世界模型、Dreamer 系列,想用想象来加速。效果不错,但世界模型本身会错。想象中很美,现实里一塌糊涂。不过话说回来,这不就是强化学习的魅力吗?永远在跟误差和不确定性打交道。
离线强化学习这两年很热。工业界数据多,但交互贵。能从日志里学策略,当然香。可 OOD 动作的 Q 值高估,能把策略带沟里。CQL、IQL、TD3+BC 这些方法都在压这个问题。实际落地时,保守一点反而活得久。
五、接下来会怎样?我的偏见
 五、接下来会怎样?我的偏见
我觉得强化学习技术不会取代监督学习。它更像一层优化器。哪里需要序列决策,哪里就有它。大模型对齐、智能体工具调用、代码生成、机器人操作,都会继续吃这波红利。
但别神化。它吃奖励设计,吃算力,吃工程细节。一个 reward 函数写错,整个训练白给。未来两三年,我押注几个方向:过程奖励模型、可验证奖励、多智能体博弈、世界模型加规划。 尤其是可验证奖励,数学、代码、定理证明,天然有对错信号,比人类偏好更硬。
最后说句大实话。强化学习技术不是银弹。它是一把锤子,但你需要先找到钉子。找错了,砸到的可能是自己的脚。可一旦找对,那种看着智能体从随机乱撞到学会策略的感觉,真的很上头。