拣货员多走的那四百米,和一群看不见的蚂蚁:生物启发算法在仓库里的样子
凌晨两点,南京江宁一个电商仓。拣货员老周推着车从 A 区走到 C 区,抓了两个箱子,又折回 A 区隔壁那排货架。
单子上十二件货,散在十四个货位里。他多走了大概四百米。
这四百米,就是我那阵子天天盯着的东西。
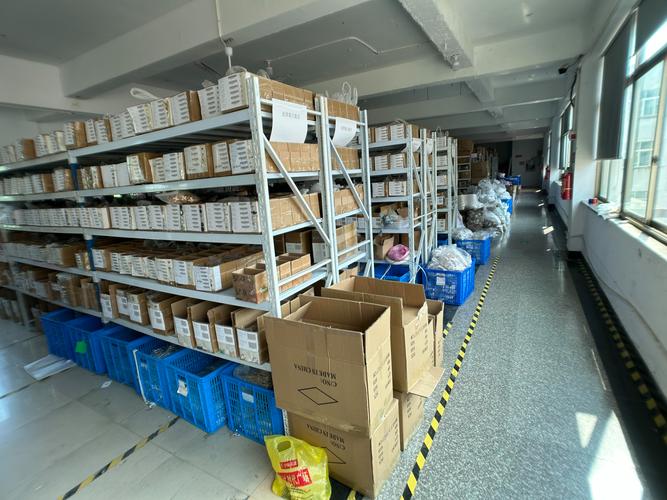 电商仓库拣货员推车行走路径实拍图
蚂蚁没学过运筹学,可它天生会抄近路
上世纪九十年代,意大利人 Dorigo 蹲在路边看蚂蚁搬家。他注意到一件事:蚂蚁一开始是乱走的,可过一会儿,越来越多的蚂蚁挤在一条相对短的通道上。没人指挥。
秘密在信息素。蚂蚁走过的地方会留下这种化学痕迹,短路径上蚂蚁来回一趟花的时间少,同样时间里能踩出更多痕迹,浓度就更高。后面的蚂蚁呢,是按概率挑路的——哪边味道重,往哪边走的可能性就大一点。
这叫正反馈。但光有正反馈会死锁,所有蚂蚁都堵在一条道上,别的路再近也没人试。所以还有第二个机制:挥发。气味随着时间变淡,老路慢慢被忘掉,蚂蚁就有了重新探索的机会。
把这事翻译成公式,其实就一行味道:某条边被选中的概率,正比于信息素浓度的 α 次方,乘上启发式信息的 β 次方。前者是“祖宗走过的路”,后者是“眼前看着近的路”。α 调大,蚂蚁保守;β 调大,蚂蚁短视。
再把它挪到仓库:货位是节点,通道是边,一趟拣货就是串起若干个节点再回到起点。这不就是旅行商问题(TSP)的亲戚吗?只不过现实版本还带着容量、时间窗、重货压底这些附加条件。
写进代码里,它其实很小,但参数能要命
蚁群算法的骨架特别朴素。三块状态:一张信息素矩阵、每只蚂蚁当前走过的行程、还有一张“禁忌表”——不让同一只蚂蚁回头啃同一个货位。每轮迭代,所有蚂蚁各自造一条完整路线,然后按路线长短往回补信息素。
真正折磨人的是参数。
我们头回上线那版,挥发率 ρ 设成了 0.9。结果呢?蚂蚁集体失忆,每轮都从零开始摸,跑了五百代还在原地打转。改成 0.01,另一个极端,全仓的蚂蚁挤在一条道上,那场面,像早高峰的应天大街。
后来稳定下来的做法是:ρ 控制在 0.1 到 0.3 之间,蚂蚁数量大概取货位数的三分之一,再加上局部信息素更新——蚂蚁每走一步就让那条边掉一点味道,主动抑制早熟。这些小动作论文里都有,但只有自己踩过坑,才知道哪条不是废话。
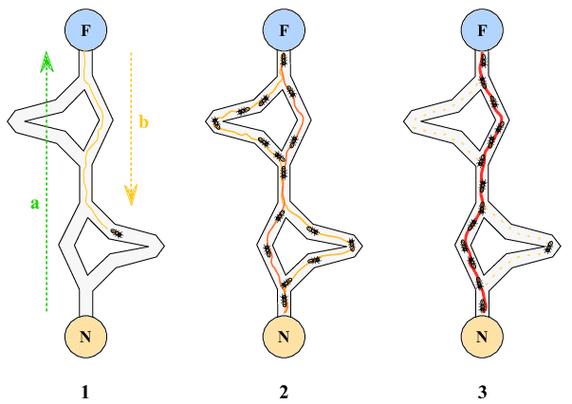 蚁群算法信息素正反馈路径选择示意图
业务现场不讲情面:约束比算法难十倍
算法能跑通,跟系统能上线,中间隔着一条长江。
订单有承诺时间,货架有承重,拣货车就那么大格子,冷冻区的东西不能压在常温货上面。更麻烦的是人——同一个拣货员对自己片区的熟悉度,是影响实际耗时的隐性变量,而它压根不在模型里。
所以纯蚁群在我们这儿很少单独出现。常见的组合是:蚁群负责出“顺序”,规则引擎负责“分配”。先让蚂蚁排出一趟该走哪些货位的次序,再由另一套逻辑决定这些货塞进几辆车、谁去跑。或者反过来,蚁群给一个粗糙的初始解,后面交给 2-opt、or-opt 这类局部搜索去打磨边角,效果往往比纯蚁群好一大截。
规模上来之后,还得先做分块。三千个货位的仓,一次性丢给蚂蚁,迭代到天亮也出不来。我们的做法是按通道聚类,切成十几块,每块单独跑,再拼回去做跨区修正。
说个实际数字。某仓八个拣货员,日均一千六百单,路径里程降了大约百分之十八。代价呢?求解时间从原来的两百毫秒涨到三点五秒。所以它是离线批次跑的,凌晨排好第二天的波次,不是每来一单就现算。实时场景下,那三秒半足够客户把页面刷三遍了。
别被“仿生”两个字骗了
误区挺多的,捡几个说。
误区一:仿生就等于更强。不是。节点数少、约束简单的时候,动态规划或者分支定界能给出精确解,蚁群在边上看着就行。它的价值恰恰在“精确解算不动”的地方——约束多到装不进求解器,或者规模大到算不完。
误区二:跑一次就完事了。这是随机算法,同一批订单跑两遍,结果不一样。客户会问:你们系统怎么每次给的路线都不同?这个质疑很合理。我们的应对是固定随机种子、多次重启取稳定的那条、把决策依据写进日志,至少让人能追问下去。
误区三:参数照着论文抄。抄不来。货位分布一改、通道宽窄一变、订单结构一换,参数就得重调。我们内部留了一张场景和参数的对照表,靠的是拿历史订单回放跑出来的,不是从表格里抠的。
至于局限,也挺实在:收敛慢、容易早熟停滞、缺少漂亮的收敛性证明,而且对动态变化反应迟钝。中途插进来一张加急单,你要么重跑,要么做局部修复,两种都有代价。
 粒子群算法粒子速度位置迭代更新原理图
横向看一眼,虫子不止蚂蚁
 横向看一眼,虫子不止蚂蚁
粒子群(PSO):模拟鸟群找食,靠速度和位置迭代。连续空间里它挺好用,参数寻优、PID 整定经常见;可放到离散的路径排序上,就有点别扭,得做各种编码转换。
遗传算法(GA):编码、交叉、变异三件套。交叉算子是命门。路径问题里直接拿顺序交叉,很容易把一条本来不错的路线切得稀碎。
模拟退火:其实来自冶金,跟生物没半毛钱关系,但经常跟蚁群搭伙——先蚁群铺个底,再退火慢慢磨。
还有蜂群、萤火虫、布谷鸟、菌群……名字越来越文艺。说句不客气的话,不少新名字只是老方法的换皮,换个比喻,公式还是那个公式。
这两年有新玩法冒出来:用神经网络学一个启发式,先预测个粗略顺序,再交给蚁群或者局部搜索去修;也有拿强化学习去挑算子的。思路挺好,但别急着上,先问自己一句:我的问题,值不值得为它养一个模型。
老周现在一天少走三公里左右。他不知道什么叫信息素,也不需要知道。他只知道系统给的顺序,好像比以前顺一点了。
这就是生物启发算法在我眼里的样子。它不神秘,也不算聪明,本质上是在没路的山上摸黑探路——靠一堆笨蚂蚁反复试错,把走不通的方向慢慢忘掉。它能干的事,是当你既写不出精确解、又等不起的时候,给一个“还不错”的答案。
但前提是你得先知道山在哪。约束长什么样、成本怎么算、哪条规则其实可以松一松。这些想不清楚,再多的蚂蚁也只是在仓库里绕圈。