可信AI技术:实验室很热,产线很冷,问题出在哪?
前几天翻一份评测报告。某大模型在公开榜单上分数漂亮。换到一家三甲医院的脱敏数据,性能掉得亲妈不认。这还不算最糟。最糟的是,没人能说清为什么。你跟临床医生讲“分布偏移”,他只会回你一句:那这机器到底靠不靠谱?可信AI技术,绕不开这个问题。
 可信AI医疗影像可解释性热力图临床场景
但依据也分等级。特征重要性是一级,反事实是一级,因果图又是另一级。别拿一级当三级用。最近有团队把可解释性写进模型卡,要求每个版本记录数据切片、失败案例、置信区间。这招土,可管用。因为审计员不关心你用了多新的注意力机制。他只关心:出了问题,能不能复现。
 可信AI大模型红队测试提示注入流程
行业里现在流行“对齐”。RLHF、DPO、宪法 AI,名字换得快。可对齐不是一锤子买卖。上线之后,用户会教你做人。今天问医疗建议,明天让它写钓鱼邮件。模型得能拒,还得拒得不过度。这个度,很难。太松,危险。太紧,废物。你说怎么办?只能持续评、持续调。
 可信AI联邦学习差分隐私架构图
合规也在收紧。欧盟 AI 法案按风险分级,高风险系统要有人工监督、日志、数据治理。国内生成式 AI 服务管理办法,强调内容标识、数据来源、安全评估。很多团队一开始觉得是法务的事。错了。这些要求会直接改架构。比如内容溯源,你得在水印、元数据、日志里留痕。再比如用户投诉,你得能定位到具体版本、具体数据切片。
说实话,我现在看到“完全可信”四个字就头皮发麻。哪有完全可信的系统?只有把失败模式写清楚、把责任边界划明白的系统。
 评测:没有场景的基准,就是自嗨
评测是可信 AI 技术的照妖镜。可惜很多评测在自嗨。公开基准刷到 90 分,换个领域掉到 60。为什么?数据泄漏、标注偏差、提示词过拟合。榜单不告诉你这些。
更靠谱的做法是动态对抗评测。用红队持续生成新攻击,用领域专家设计真实任务,用不确定性量化给每个预测配置信度。校准曲线、选择性预测、拒答机制,这些比单纯准确率有用。至少能让系统知道“我不知道”。
可信AI技术的终点不是论文,是责任分配。
举个例子。自动驾驶出了事故,是感知模型错,还是规划规则错,还是地图过期?如果日志和版本管理一塌糊涂,连责任都分不清。那信任从哪来?从流程里来。从可审计、可回滚、可追责里来。
所以别指望一个算法包治百病。可解释性、鲁棒性、隐私、评测,得一起上。工程师、法务、产品、领域专家,也得坐一张桌子。吵架很正常。不吵才可怕。
最后说句掏心窝的。可信 AI 技术不是给 AI 戴高帽。它是给 AI 上缰绳。缰绳勒得紧,马跑不快。可没有缰绳,迟早摔进沟里。你选哪个?
可解释性:热力图好看,医生要的是因果
可解释性被说烂了。SHAP、LIME、注意力图,demo 一跑,红红蓝蓝,很热闹。可到了真实场景,医生问:你标这片肺结节,是因为形状,还是因为旁边那根导管?如果模型答不上来,信任就崩。对吧,这不是 UI 问题。 科研圈在推概念瓶颈模型、因果表示学习、反事实解释。思路不复杂:别让模型只学相关性,要逼它学可干预的因果结构。比如“如果这个病灶再大 2 毫米,模型判断会变吗?”这种问题,比一张热力图更接近临床决策。 不过说实话,很多论文里的可解释性,到了工程里就变成日志和规则。没法子,算力、延迟、监管口径,全是约束。 可信AI技术的第一层,不是让模型说话,而是让它说清楚依据。可信AI医疗影像可解释性热力图临床场景
但依据也分等级。特征重要性是一级,反事实是一级,因果图又是另一级。别拿一级当三级用。最近有团队把可解释性写进模型卡,要求每个版本记录数据切片、失败案例、置信区间。这招土,可管用。因为审计员不关心你用了多新的注意力机制。他只关心:出了问题,能不能复现。
鲁棒性:红队测试不是找几个 prompt 就完事
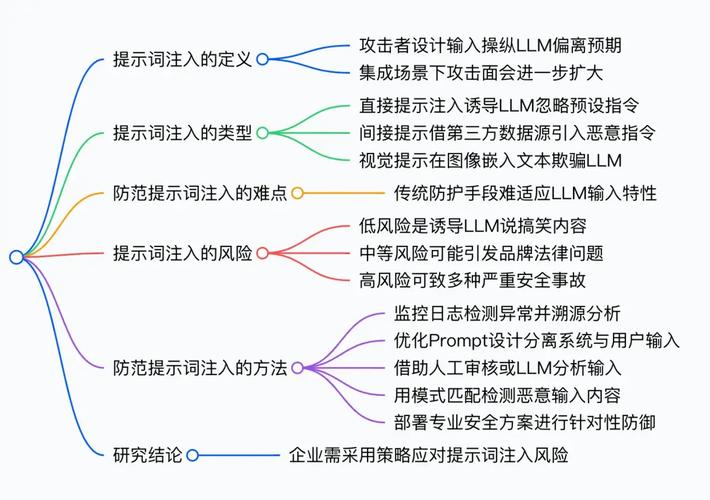
大模型火了以后,红队测试成了热词。很多团队怎么做?找几个人,写一堆越狱 prompt,跑一遍,没崩,发个报告。完事。老实说,这跟没测差不多。 真实攻击面广得多。数据供应链、RAG 检索库、插件调用、输出解析器,哪个环节都能被喂毒。提示注入只是开胃菜。对抗样本更老,但依然有效。一张贴纸能让视觉模型把停止牌认成限速牌,这不是段子。 科研成果也有进展。随机平滑能给分类器提供可证明的鲁棒半径。对抗训练能提升某些扰动下的稳定性。形式化验证在中小网络里开始落地。但代价呢?训练慢,精度掉,工程复杂度飙升。没有免费午餐。 鲁棒性不是跑分,是持续对抗。可信AI大模型红队测试提示注入流程
行业里现在流行“对齐”。RLHF、DPO、宪法 AI,名字换得快。可对齐不是一锤子买卖。上线之后,用户会教你做人。今天问医疗建议,明天让它写钓鱼邮件。模型得能拒,还得拒得不过度。这个度,很难。太松,危险。太紧,废物。你说怎么办?只能持续评、持续调。
隐私与合规:别把差分隐私当万能膏药
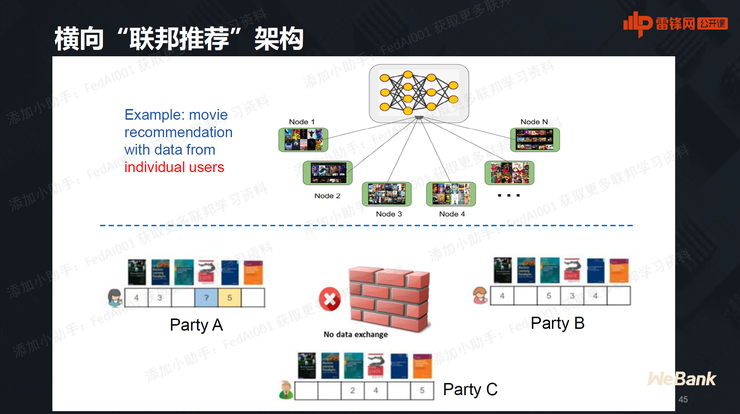
隐私这块,坑更深。联邦学习听起来很美:数据不出域,只传梯度。可梯度也会泄露信息。已有研究从梯度里重建训练样本,图像和文本都中过招。差分隐私能加噪声,但隐私预算 epsilon 一收紧,模型效果就往下掉。业务方一看曲线,脸就绿了。 还有机密计算、同态加密。概念很硬。落地很贵。同态加密做推理,延迟可能高到没法接受。机密计算依赖硬件信任根,供应链安全又成新问题。 隐私不是开关,是预算和威胁模型。可信AI联邦学习差分隐私架构图
合规也在收紧。欧盟 AI 法案按风险分级,高风险系统要有人工监督、日志、数据治理。国内生成式 AI 服务管理办法,强调内容标识、数据来源、安全评估。很多团队一开始觉得是法务的事。错了。这些要求会直接改架构。比如内容溯源,你得在水印、元数据、日志里留痕。再比如用户投诉,你得能定位到具体版本、具体数据切片。
说实话,我现在看到“完全可信”四个字就头皮发麻。哪有完全可信的系统?只有把失败模式写清楚、把责任边界划明白的系统。
评测:没有场景的基准,就是自嗨
评测:没有场景的基准,就是自嗨
评测是可信 AI 技术的照妖镜。可惜很多评测在自嗨。公开基准刷到 90 分,换个领域掉到 60。为什么?数据泄漏、标注偏差、提示词过拟合。榜单不告诉你这些。
更靠谱的做法是动态对抗评测。用红队持续生成新攻击,用领域专家设计真实任务,用不确定性量化给每个预测配置信度。校准曲线、选择性预测、拒答机制,这些比单纯准确率有用。至少能让系统知道“我不知道”。
可信AI技术的终点不是论文,是责任分配。
举个例子。自动驾驶出了事故,是感知模型错,还是规划规则错,还是地图过期?如果日志和版本管理一塌糊涂,连责任都分不清。那信任从哪来?从流程里来。从可审计、可回滚、可追责里来。
所以别指望一个算法包治百病。可解释性、鲁棒性、隐私、评测,得一起上。工程师、法务、产品、领域专家,也得坐一张桌子。吵架很正常。不吵才可怕。
最后说句掏心窝的。可信 AI 技术不是给 AI 戴高帽。它是给 AI 上缰绳。缰绳勒得紧,马跑不快。可没有缰绳,迟早摔进沟里。你选哪个?