存算一体架构:把计算塞进存储阵列之后,麻烦才刚开始
搞芯片的人这几年大概都听过一句话:算力的瓶颈,早就不在算,而在搬。
这话乍一听有点反直觉。芯片不就是拿来算的吗?拆开看其实很直白——传统冯·诺依曼架构里,计算单元和存储单元是分开的两栋楼。CPU 要算个数,得先把数据从内存搬过来,算完再搬回去。搬这一趟,数据没动多少,电先烧掉一大半。
有个被引用到烂的数据:7nm 下一次 32 位浮点加法能耗大概 0.1 皮焦,但要从 DRAM 里读同样一批数据过来,能耗得翻上两三个数量级。芯片的力气,大部分花在了路上。
大模型一起来,这事就更没法忍。矩阵乘加把内存带宽按在地上摩擦,“存储墙”这词都不够用了,那简直是悬崖。
存算一体架构:让存储器自己动手算
存算一体架构的核心思路不复杂:既然搬数据这么贵,那干脆别搬,直接在存储器阵列里算。
最典型的玩法是忆阻器交叉阵列,也就是 crossbar array。每个交叉点放一个可变电阻器件——RRAM、PCM、MRAM 都有人在做。输入电压按行加,输出电流沿列读,根据基尔霍夫定律,列线上的电流天然就是输入电压和电导的乘积累加。整个矩阵向量乘法,物理层面直接完成,一个时钟周期出结果。
这就是为什么神经网络特别吃这一套。推理里百分之八九十的计算量都是矩阵乘法,而 crossbar 干的恰好就是这件事。它不是“模拟”神经网络,是物理规律本身就是那个算法。
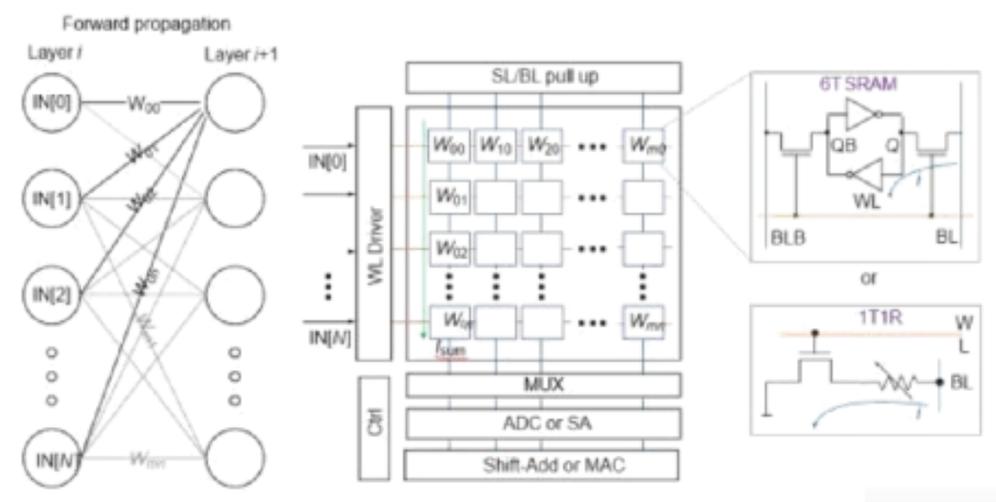 忆阻器交叉阵列存算一体芯片结构示意图
不过话说回来,理想很丰满。第一次听到“一个周期算完整个矩阵”的时候我也挺兴奋,后来跟做器件的人聊了几次,才知道坑有多深。
模拟计算的甜蜜陷阱
存算一体的路子大致分两派:模拟派和数字派。
模拟派靠器件电导直接做乘加,能效理论上高得离谱,几百 TOPS/W 不是梦。可现实是——器件有噪声,电导会漂移,写进去的权重过一段时间自己就变了。还有 IR drop,阵列一大,边上的单元和中心单元拿到的电压根本不一样。再加上工艺偏差,同一片 wafer 上同一个位置,电导能差出百分之几十。
更麻烦的是 ADC。模拟电流出来之后得转成数字,而高精度 ADC 又贵又耗电,阵列越大这个问题越突出。有时候你费半天劲省下来的能耗,最后全被 ADC 吃回去了。这也是为什么现在很多方案干脆做小阵列、做混合精度,或者认怂走数字路线。
数字派呢,就是用 SRAM 加逻辑,在存储阵列旁边塞进乘加电路。能效提升没那么夸张,但胜在成熟、可控、良率高。国内几家做存算一体的公司,早期产品大多走的这条路。
场景不一样,选择就不一样。给 TWS 耳机做语音唤醒,小算力低功耗,模拟方案很香。要跑大模型推理,那又是另一回事了。
产业这两年,确实在动
前几年存算一体基本待在实验室里,论文发得挺热闹,产品见不着。这两年不太一样。
一是工艺。存算一体最怕良率,而它偏偏是典型的“面积换能效”,阵列越大越划算。以前只能在 180nm、130nm 上玩,现在 28nm、22nm 已经能跑通,有些团队在做 12nm 的验证。工艺一进步,单片算力立刻上一个台阶。
二是场景。边缘 AI 起来了,摄像头、耳机、传感器这些地方功耗卡得死死的,传统架构真的不够用。存算一体不需要外挂 DRAM,几 MB 片上存储就能干活,成本和功耗上都有优势。已经有产品出货了,就不点名了,业内都清楚。
三是大模型。这个反而把情况搞复杂了。大模型参数动不动上百亿,忆阻器阵列那点容量根本装不下,也不会有谁真把 GPT 塞进一个 crossbar 里跑。所以业界更现实的做法是近存计算加存内计算的混合架构,热数据放片上,冷数据还走 HBM。
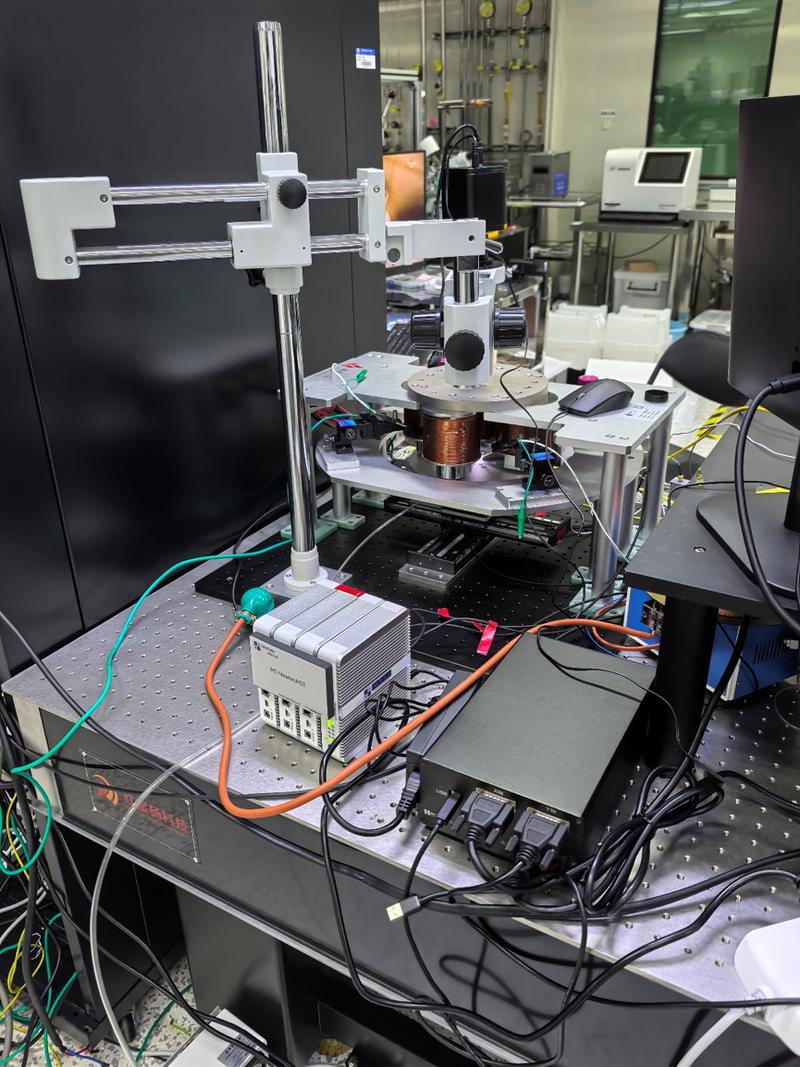 存算一体芯片晶圆级测试探针台实拍图
说实话,我接触过的一些项目,宣传材料写得很漂亮,一看实测数据就……嗯。能效提升十倍二十倍是有的,但那种几百倍上千倍的,基本都是拿特定场景、理想条件下的峰值数字比出来的。真装到系统里跑一圈,能有三到五倍的实际提升,就已经值得开香槟了。
还没解决的问题,比解决的还多
 还没解决的问题,比解决的还多
器件一致性和寿命。RRAM 的写次数、保持特性、温度漂移,每一项都够写好几篇博士论文。实验室里跑得挺好,上车规温度之后是什么样,很多时候没人敢打包票。
编程精度。模拟器件想精确写到一个电导值,比想象中难得多,写—校验—再写的循环很耗时。推理还行,训练基本别想。
编译工具链。这个被讨论得最少,但可能最要命。算法怎么映射到阵列上?权重怎么切分?精度掉了谁来兜?没有一套成熟的工具链,硬件再强也没人愿意用。
生态。CUDA 之所以是 CUDA,不只是一套 API。存算一体现在缺的就是这个东西,而且短期内看不到谁能补上。
不吹不黑,存算一体架构肯定不是万能药,但它确实在解决一个真实存在的问题。冯·诺依曼架构用了七十多年,总得有人去戳一戳。
至于最后谁能跑出来——是在器件上死磕的那批人,还是一开始就走数字路线的务实派,现在真看不出来。我倒是觉得,最后赢的八成是那个先把工具链做明白的。