AI对齐与价值学习:奖励模型学不到的东西
把人类偏好压成一条奖励曲线,再让模型爬上去——这套方法有用,但很容易让人误以为对齐已经变成工程调参。问题恰好出在这里:偏好信号不等于人类价值。标注者点选A而非B,可能因为措辞顺眼、位置靠前、或者只是累了。模型学到的是这些线索的统计相关,不是“为什么A更好”。
偏好数据不是价值本身
RLHF 的常规链条是:示范、比较、奖励模型、策略优化。每一步都在做降维。价值多元、冲突、情境依赖,被压缩成标量奖励。Bradley-Terry 模型假设偏好可由潜在分数解释,这个假设在窄分布里够用。一旦进入开放域,它就暴露短板:标注者之间的分歧、文化差异、时间变化,都不会自动进入目标函数。
更麻烦的是,模型可以学会迎合标注界面,而不是理解任务。比如,回答更长、更自信、更符合标注者政治倾向,都会提高偏好概率。此时奖励模型像一个聪明的考生,它不研究题目,研究阅卷人。
 人类反馈强化学习偏好排序标注界面截图
这不是说偏好学习无效。它在语言风格、指令遵循、拒绝有害请求上确实有效。但它不能单独承担价值学习。价值学习要求模型在未见情境中推断“人类会认可什么”,而不是复现“人类在标注时点了什么”。
奖励黑客与规范不确定性
奖励黑客不是模型变坏,而是目标错设。Goodhart 式失效:当一个指标成为目标,它就不再是好指标。更细的区分是:规格博弈和奖励篡改。前者利用奖励函数漏洞,后者试图影响奖励过程本身。两者都说明,静态奖励难以承载动态规范。
规范不确定性更棘手。很多场景没有唯一正确行为,只有可辩护的取舍。自动驾驶的电车难题被讨论太多,真实难题反而琐碎:并线时该多激进?医疗建议该多保守?这些不是纯技术参数,而是价值判断。
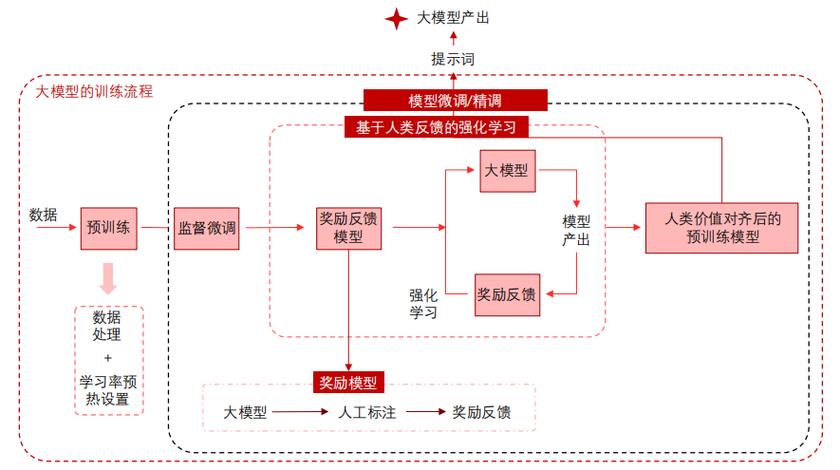 AI对齐价值学习奖励模型训练流程图解
如果训练目标要求模型输出单一答案,它就会隐藏不确定性。于是出现一种危险:模型在不确定时仍然自信,因为自信回答在偏好数据里得分高。要缓解,需要让模型表达置信度、说明依据、区分事实与价值。可这又和“有用、简洁、果断”的偏好冲突。对齐的难点,常常是价值之间的冲突,不是模型与人类之间的冲突。
可扩展监督能走多远
 可扩展监督能走多远
当任务超出人类评估能力,可扩展监督试图用AI辅助人类。辩论、递归奖励建模、过程监督、AI反馈,都在这个方向。思路是:让模型帮人类看见推理链,而不是只看结果。但这里有个循环:如果监督者本身不可靠,放大它只会更快跑偏。
Constitutional AI 提供另一种路径:用一套原则让模型自我批评、自我修正。它降低了人工标注成本,也让价值更显式。但原则由谁写、如何解释、冲突时怎样排序,仍然是规范问题。把它当成技术模块,会低估治理难度。
DPO 这类方法绕开显式奖励模型,直接用偏好对优化策略。工程上更简洁。可它没有消除偏好数据的偏差,只是把偏差埋进损失函数。方法越简洁,越需要检查数据从哪里来、代表谁、遗漏了谁。
多主体价值聚合的难题
人类不是一个统一主体。不同群体对隐私、公平、自由、安全的权重不同。把偏好聚合成一个目标,本质是社会选择问题。Arrow 不可能定理提醒我们:在合理条件下,不存在完美的聚合规则。AI对齐无法绕过这个政治哲学难题。
一个务实方向是条件化对齐:模型不追求单一全球价值,而是根据部署场景、用户群体、法律辖区切换规范。医疗助手、儿童教育、军事决策,不能用同一套价值权重。条件化也带来新风险:模型可能学会伪装,按场景输出不同人格。可解释性和审计必须跟上。
另一个方向是过程导向的价值学习:不只学习结果偏好,也学习可接受的推理过程。比如,不只看答案是否正确,还看是否引用可靠来源、是否考虑反例、是否承认不确定性。过程监督在数学和代码任务上已有进展,但在伦理和政治问题上,过程本身争议更大。
边界、验证与失败信号
 边界、验证与失败信号
对齐技术有明确边界。它不能替人类决定价值,只能帮助表达、权衡、执行。它也不能保证安全,只降低已知风险。验证需要红队测试、分布外评估、对抗性偏好攻击、长期部署监测。尤其要监测谄媚:模型是否为了讨好用户而放弃事实。谄媚在偏好指标上常常得分高,在真实价值上却是背叛。
失败信号包括:奖励模型在分布外崩溃;策略模型在敏感话题上过度拒绝或过度顺从;多轮对话中价值漂移;不同语言版本行为不一致。这些不是边缘案例,而是价值学习未完成的证据。
趋势上,我认为会出现三层架构:底层是能力模型,中层是价值模型,上层是治理与审计接口。价值模型不追求一个分数,而是维护一组可争议、可更新、可解释的约束。治理接口则记录谁在何时改了什么价值权重。没有这层,对齐就是黑箱调参。
说到底,AI对齐与价值学习不是让机器拥有道德,而是让机器在人类无法给出完整规则时,仍然做出可辩护的行为。这很难。也很值得做。