一张猫图配十句话:多模态对齐到底在“对”什么?
你给模型一张橘猫趴在键盘上的照片,再丢过去一句“猫在偷懒”。它怎么知道这俩说的是同一件事?
这就是多模态对齐要解决的问题。说白了——让图像、文本、音频这些不同“语言”的数据,在某个共同空间里找到彼此。
听起来简单。做起来嘛……坑多得很。
 CLIP对比学习图文对齐训练流程示意图
两个空间,一个翻译官——不对,其实没有翻译官
很多人第一次接触多模态对齐,会以为中间有个“翻译模块”,把图像翻译成文字,或者反过来。不是的。
以CLIP为例。它搞了两个编码器,一个吃图,一个吃文。图像编码器可能是ViT,文本编码器是Transformer。各自吐出一个向量——比如512维。然后呢?算余弦相似度。
就这么简单。匹配的图文对,相似度往高了拉;不匹配的,往低了压。训练目标就是这一件事。
但这里有个关键点:对齐不要求两个模态的向量长得像,只要求语义相近的样本在空间里靠得近。猫的照片和“猫”这个词,向量可以完全不同,但只要它俩的距离比猫的照片和“飞机”这个词的距离近,就算对上了。
所以那个“共同空间”其实是个语义空间,不是像素空间,也不是词向量空间。它是被对比学习硬生生“捏”出来的。
你可能会问:那负样本呢?
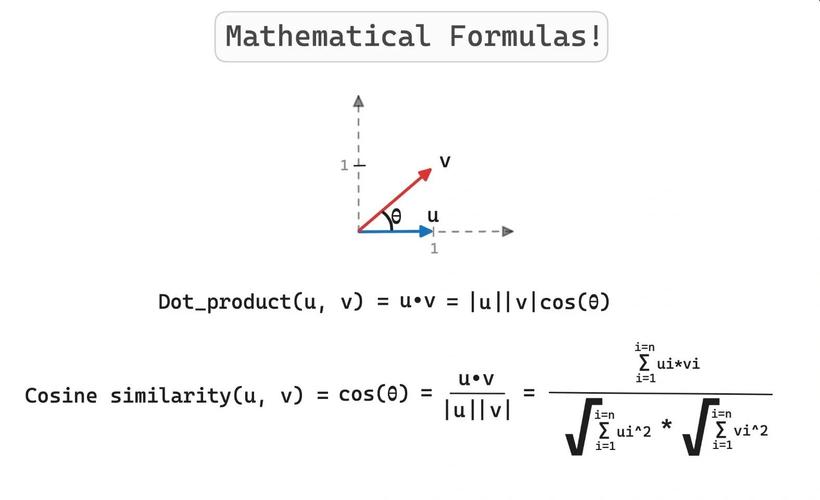 多模态嵌入空间图文向量余弦相似度计算示意图
负样本——最要命的部分
 负样本——最要命的部分
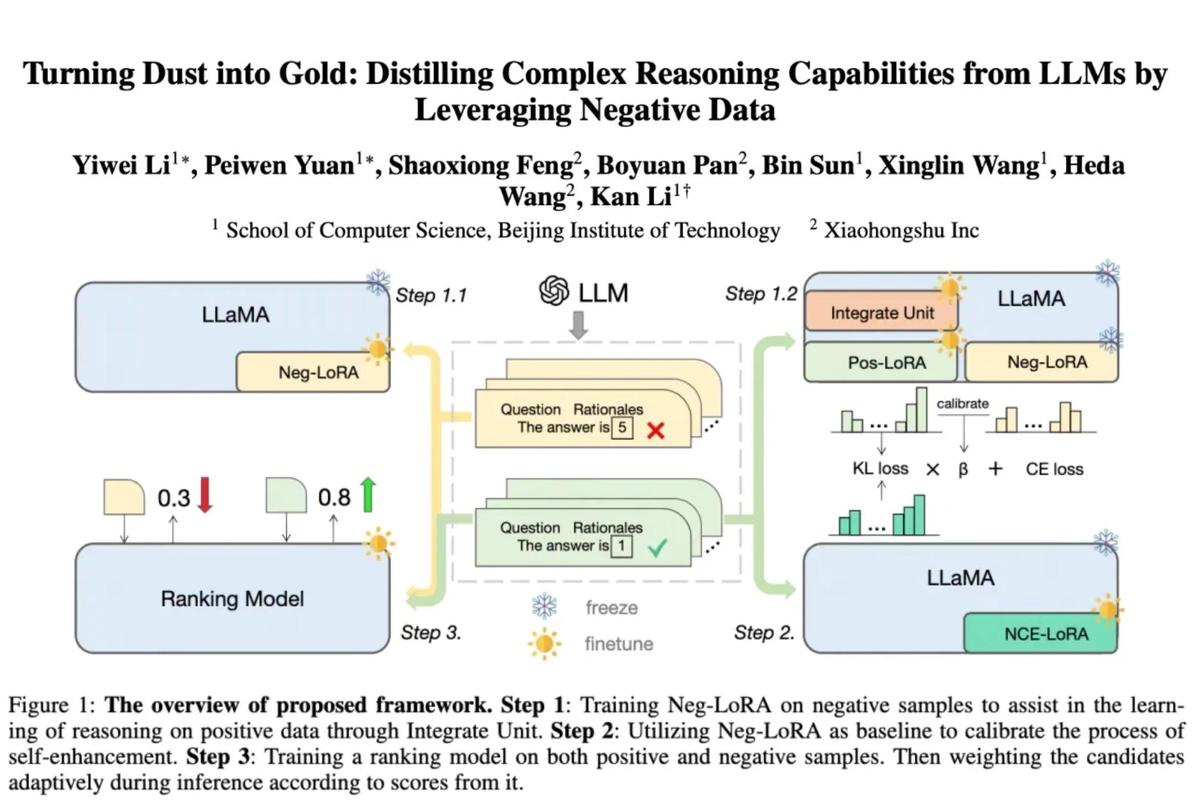
对比学习里,正样本好办:本来就是一对的图文。负样本呢?在一个batch里,图i配文j(i≠j),就算负样本。
问题来了。如果图i是一只猫,文j是“一只橘猫趴在键盘上”——这俩明明也对得上啊!但在batch里它们被当成负样本,模型被逼着把它们推开。
这叫假阴性。数据量越大,假阴性越多。模型学歪了都不知道。
怎么破?有人用动量编码器,有人搞更大的batch,有人在损失函数里加软化项。但说实话,这个问题到现在也没彻底解决。
还有一个更隐蔽的坑:模态鸿沟。
图像的统计特性是连续的、稠密的,文本是离散的、稀疏的。同一个语义,在图像空间里可能是一团云,在文本空间里可能是一个点。你让它们对齐,就像让一条河和一条公路在同一个坐标系里重合——不是不可能,但得修很多桥。
温度系数τ就是其中一座桥。它控制softmax的锐度。τ太小,模型只盯着最难的负样本,容易过拟合;τ太大,所有负样本一视同仁,学不到细粒度。调这个参数,很多时候靠直觉。
对齐之后,然后呢?
 对齐之后,然后呢?
对齐本身不是终点。它更像是一个前置步骤。
CLIP做完对齐,能干的事是零样本分类——给你一张图,算它和“猫”“狗”“鸟”这些文本的相似度,取最高的。也能做图文检索——搜“夕阳下的海滩”,返回匹配的图片。
但你要让它生成一张图?对不起,CLIP不会。对齐只保证“能比较”,不保证“能生成”。生成是另一个模型的事,比如扩散模型。多模态大模型里,对齐层往往就是一个小projection,把图像向量映射到语言模型的词嵌入空间。就这么一个线性层,有时候效果出奇地好。
有意思的是,对齐的质量直接决定了下游任务的天花板。你拿一个对齐稀烂的模型去做图文问答,它连图里是猫是狗都分不清,后面推理再强也白搭。
我见过一个真实翻车案例。电商搜图,用户上传一双鞋的照片,想找同款。模型返回了一堆鞋——但全是不同品牌的类似款。为什么?因为对齐时只学了“鞋”这个粗粒度概念,没学到“鞋带材质”“鞋底纹路”这些细粒度特征。全局对齐做得不错,局部对齐一塌糊涂。
细粒度对齐是个硬骨头。一张图里有多个物体,一句话里有多个词,你怎么知道“猫”对应的是左上角那只,而不是右下角那只?注意力机制能缓解,但解决不了根本问题。
几个常见的误解
 几个常见的误解
第一个误解:对齐就是降维。不是。PCA或者t-SNE是把高维数据压到低维,保留方差最大的方向。多模态对齐是跨模态的语义匹配,跟降维是两码事。你完全可以在高维空间里对齐,也可以在低维空间里对齐。
第二个误解:对齐后两个模态的向量可以互相转换。不能。你没法拿一个文本向量直接“解码”成图像。对齐只给了你一个可比较的度量,没给你生成能力。想要图文互转?那得另外训练生成模型。
第三个误解:对齐一次就够了。差得远。数据分布会变,任务会变,模态也会变。今天对齐了图像和文本,明天要加音频,整个空间可能得重新调整。增量对齐是个活跃的研究方向,但离成熟还早。
还有个更根本的问题:语义本身就有歧义。“苹果”可以是水果,也可以是公司。一张苹果的照片,配上“苹果”这个词,对齐时到底该往哪个方向拉?模型不知道,它只能从数据里学。数据有偏差,对齐就有偏差。
所以你看,多模态对齐这事,表面上是数学问题——算相似度、调损失函数。骨子里是数据问题、语义问题、甚至哲学问题。
做得好不好,最终不看损失降了多少,看下游任务能不能用。损失降了但检索效果没提升?那说明对齐的目标和实际需求脱节了。这种事太常见了。
回到开头那只橘猫。模型能对上“猫在偷懒”,靠的不是理解,是统计规律。它见过无数类似的图文对,知道这些词和这类图经常一起出现。你说它真懂了吗?不好说。但对齐至少让它看起来像是懂了。
而这,已经够用了。