十个客户端,十种世界观:联邦学习中的非独立同分布为什么这么难缠
上个月跟一个做手机输入法联想的朋友吃饭,他吐槽说他们那套联邦学习框架在测试环境里准得离谱,推上线就稀碎。我问了一句,你们测试集怎么造的。他说,从一台机器的语料里随机切呗。
哦。那没事了。
随机切,意味着每个“客户端”看到的数据分布几乎一模一样。可真实世界里,用折叠屏的大叔和用旧安卓机的大学生,打字习惯能差出十万八千里。你在办公室里模拟出来的那个“联邦”,本质上是个自己跟自己玩的单机游戏。这就是联邦学习中的非独立同分布问题最朴素的表现形式——你以为你在训练一堆分布式模型,其实你在训练一个装了十副面具的模型。
数据不打架,才是小概率事件
先说清楚这东西到底指什么。独立同分布(IID)这个词,翻译成人话就是:每个客户端手里的数据,都是从同一个大池子里随机捞的,谁也别说谁特殊。非独立同分布(Non-IID)就是——各捞各的,各有各的口味。
细拆下来,它至少有五种形态,而很多人一开口就说“Non-IID”,其实脑子里只有一个形态。
标签偏移:你手里全是猫的图片,我手里全是狗的。这是最常见、也最好理解的一种。特征偏移:同样是猫,你拍的是室内暗光,我拍的是户外阳光下,pixel级别的分布完全不同。概念偏移:同一个人,在你那儿标签是“客户”,在我这儿标签是“骗子”——同一个输入,输出定义就不一样,这种最要命,因为平均之后得到的标签几乎是无意义的。数量不平衡:我这边一万条样本,你那边三条,加权平均时你那点信息基本被吞掉。时间漂移:更隐蔽,同一个客户端上周和这周的数据分布都在变,你以为的静态问题其实是动态的。
现实里这五种往往叠在一起。医院场景最典型:一家三甲和一家社区医院,病种分布不同(标签偏移),拍片设备不同(特征偏移),样本量差两个数量级(数量不平衡),诊断标准还可能不一样(概念偏移)。
 联邦学习Non-IID客户端标签分布偏移示意图
平均值这件事,在非独立同分布下会翻车
联邦学习里最经典的聚合方式是 FedAvg:每个客户端本地跑几轮梯度下降,然后把模型参数发回来,服务器按样本量加权平均。
这个操作背后藏着一个假设。论文里叫 β-近似——随便挑一个客户端,它本地优化方向跟全局最优方向之间,夹角最多差 β 这么大。IID 的时候,β 趋近于零,本地梯度就是全局梯度的无偏估计,平均一下皆大欢喜。数据一异质,β 就大得没边了。
结果是什么?每家客户端在本地跑几十步 SGD,越跑越往自己那个方向偏。等参数传回来做平均,得到的是一个谁都不认的模型。业内管这叫 client drift,客户端漂移。
打个比方。十个人蒙着眼,各自被直升机扔到一片山区的不同山头,约定“各自往下走一百步,然后报坐标取平均”。你在东边的山谷,我在西边的悬崖,他还在半山腰。平均出来的那个点,很可能挂在某个峭壁上——它不是任何一个人的最优位置,也不是全局的最优位置。
更糟的是量化的那个细节:每轮平均之后,下一轮本地训练又会从那个“峭壁点”出发,继续往各自方向跑。多轮下来,模型要么震荡,要么干脆发散。你会看到 loss 曲线上下横跳,像心电图。
 FedAvg客户端漂移梯度轨迹对比图
解法大体分三条路:约束、纠正、放权
第一条路,加约束。FedProx 的思路很直接:本地更新的目标函数里加一项近端项,惩罚本地模型偏离全局模型太远。μ/2 乘以参数差的平方。意思就是“你可以往自己方向跑,但别跑太野”。简单、便宜、改动小,缺点也明显——μ 调大了学不动,调小了不管用,而且它只是缓解,没从根上治。
第二条路,做纠正。SCAFFOLD 是这里头的代表。它给每个客户端维护一个“控制变量”,记录这个客户端历史上偏离全局方向多少,本地训练时把这份偏差减掉,相当于给每个人的罗盘做了校准。收敛速度明显好转,尤其是数据异质严重的时候。代价是每个客户端要多存一份和模型同尺寸的变量,通信和内存开销都上去了。移动端部署时会很肉疼。
同一条路上还有 FedNova,专治“本地步数不一致”带来的加权失真;MOON 则用对比学习,把本地模型往全局模型那边拽一把,让两者的表征尽量对齐。这些方法思路不同,本质上都在回答同一个问题:怎么让本地更新携带的信息更接近全局视角。
第三条路我个人最看好——放权,也就是个性化联邦学习。既然大家的分布本来就不同,为什么非要训一个所有人共用的模型?Ditto、pFedMe、Per-FedAvg 这一脉的思路是:全局模型作为底座,每个客户端在自己那侧再微调出一份属于自己的个性化模型。医疗场景里这几乎是必然选择,共享的模型学通用特征,本地的模型学本院特色。
还有一条支线是聚类。不等于要把所有客户端揉成一个,而是先想办法把它们分成几簇,簇内聚合、簇间隔离。IFCA 就是这类思路。问题在于:聚类数怎么定?分布式环境下怎么高效地估?这又变成新难题。
数据侧的办法也别忽略。共享一小撮公共数据集、用知识蒸馏传递软标签、甚至让客户端生成合成样本上传——这些手段跟算法层面的改造是互补的,工程上往往比改聚合公式更见效。
几个我见过的误解
“数据不均衡就是 Non-IID。”——不完全。数量不平衡只是其中一种,且往往是最容易处理的一种。真正难缠的是概念偏移和特征偏移叠加的情况。
“加权平均一下就好了。”——加权能缓解数量不平衡,但对方向上的偏移毫无办法。你给一个小客户端加权,它本来就在往错误方向跑,加得越狠偏得越远。
“数据搞成 IID 就没问题了。”——也不是。真实系统里还存在系统异质性:设备算力不同、网络带宽不同、有的客户端每轮都在有的根本连不上。这些因素造成的更新不对称,跟在数据层面制造异质,效果上有时候是一回事。
还有个更常见的坑:仿真环境里用 Dirichlet 分布切数据,α 调小一点就宣称自己解决了 Non-IID。可 Dirichlet 造出来的异质结构,和真实场景里那种“同科室样本扎堆、跨科室完全断层”的形态差得远。用一个玩具分布去证明方法有效,是这领域里心照不宣的水分。
还有一层很少被摆上台面:异质和隐私的纠缠
梯度反演攻击(从上传的梯度里还原出原始训练样本)这件事,跟数据分布其实是耦合的。客户端本地数据越同质,一个 batch 里的样本越“像”,梯度里携带的方向性信息就越集中,反演反而可能更容易。换句话说,Non-IID 不只是性能问题,它还在悄悄改变隐私攻击的难度曲面。这一点在方案设计里经常被放到最后一页 PPT 才提。
另一层是公平性。聚合出来的全局模型,本质是各方分布的一个加权折中。谁数据多、谁话语权就大。结果就是模型在少数群体上表现明显更差。这在医疗和金融场景里不是技术瑕疵,是合规风险。
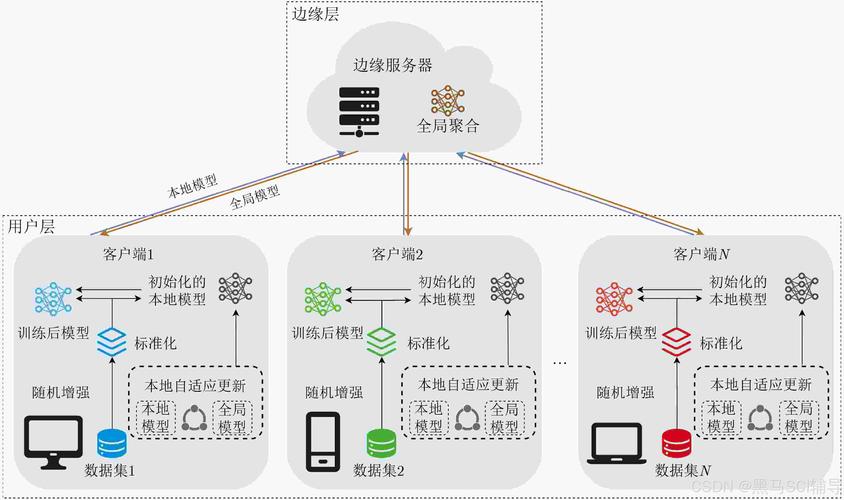 联邦学习客户端数据异质性对隐私梯度反演影响示意图
所以回到开头那个朋友的问题。他在测试集上把数据随机切,测出来的数字漂亮是必然的,因为那个环境里根本就不存在漂移这件事。真正上线之后,每个用户都是一个独立的小世界,模型要面对的是源源不断的、彼此矛盾的更新。这不是调参能解决的,这是分布式优化本身的结构性代价。
我的经验是:别一上来就追新算法。先把客户端的分布画像画出来,搞清楚异质到底体现在哪一维;再评估通信预算和端侧算力能承受什么量级的方案;最后才是选方法。顺序错了,再花哨的聚合策略也是往沙子上盖楼。
联邦学习的浪漫之处在于数据不出门,麻烦之处也恰恰在这里——你看不见门里面的世界长什么样。非独立同分布,就是这个盲盒里最难猜的一件东西。