自然语言处理:从实验室论文到你手机里的输入法,藏着多少坑
你每天打字,输入法自动补全你要说的词。刷短视频,一秒出字幕。跟APP里的客服机器人扯半小时,写稿子卡壳了喊AI帮你接下半段。这些天天用的功能,背后全是自然语言处理在干活。
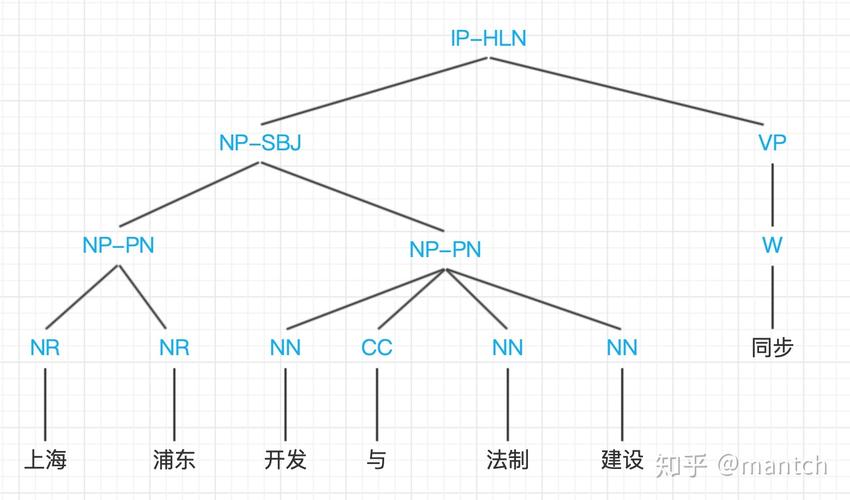 早期自然语言处理规则语法树示意图
写着写着大家就疯了。活人说的话哪有那么多规矩?网络热词三天出一个,不同地方的方言口语有上百种表达,规则写得再多,永远赶不上语言变的速度。九十年代那批蹲实验室做NLP的,多半都在规则堆里熬掉了头发,最后承认这条路走不通。
说实话,直到统计机器学习起来,NLP才真正活过来。大家发现不用死磕规则,喂够语料让模型自己找规律就行。一下子打开了新局面,机器翻译、分词、词性标注这些任务的精度蹭蹭往上涨。我认识一个老研究员,那时候为了攒够中文语料,带着学生逐字逐句标了一年人民日报,现在说起来还连连叹气。
不过那时候的模型还是碎的。分词是分词,句法是句法,翻译是翻译,各个模块各干各的,前面错一步,后面全错。比如遇到“南京市长江大桥”,分成“南京 市 长江 大桥”是对的,要是分成“南京市长 江大桥”,后面的分析全乱了。这种歧义问题,那时候根本没法彻底解决。
 大模型自然语言处理上下文歧义案例对比图
上个月帮一个创业朋友看智能客服的项目,用户问“你们这款骑行头盔能挡小雨吗?”,机器人套着大模型,答出来的是“我们这款头盔符合国家安全标准,采用硬质PC外壳,缓冲性能达标”,你说答得错吗?没错,全是正确的废话。用户要的就是一句“能”或者“不能”,你绕这么大弯,用户转头就走了。
不过话说回来,大模型带来的改变真的是颠覆性的。之前做一个垂直领域的NLP项目,要标几千几万条数据,工程师和标注员熬好几个月,现在给大模型丢五六个示例,prompt写清楚,半天就能跑通可用的demo。原来要半年的活,现在一个实习生两个礼拜搞定,这放在十年前,想都不敢想。
 未来的自然语言处理,我看要往小了做,往实了走
现在整个行业都在卷参数,千亿不够要万亿,好像参数越大,NLP就做得越好。说实话,绝大多数落地场景,根本不需要这么大的模型。你手机里的输入法,要万亿参数干嘛?占十几个G内存,开着就掉电,谁用啊?
最近两年我看越来越多的研究开始往小模型走,做端侧NLP。把大模型的知识蒸馏到小模型里,精度掉不到一个点,速度快五六倍,还不用把你输入的隐私内容上传到云端,一举好几得。
自然语言处理的终极目标,从来不是做一个能陪人聊天吹牛的通用大模型,而是让机器听懂人话,帮人解决具体的问题。
给三甲医院做NLP工具,能从几十页的门诊病历里自动提取出过敏史、既往病史、用药记录,帮医生写病历省一半时间,这个比能写一百首情诗的大模型有用一万倍。给古籍研究所做NLP,能把扫描版的线装书自动识别、断句、标标点,帮历史学者省掉好几年整理文献的时间,这就是实实在在的价值。给做外贸的小企业做NLP,能自动把海外客户的邮件翻译成中文,还能提炼出客户的核心需求,帮小老板不用找翻译也能跟客户谈生意,这就是能落地的好技术。
前阵子听一个做了四十年NLP的老教授讲座,他说早年入行做NLP,就是想让机器帮人干那些咬文嚼字的脏活累活,现在好多人跑偏了,就比谁的参数大,谁的模型能聊天,忘了本来要干什么。我听完特别认同。
技术再炫,概念再热,最后要落到解决问题上。自然语言处理走了六十多年,从手写规则到统计学习再到今天的大模型,兜兜转转,核心其实从来没变:就是让机器能懂人类说的话,把人从繁琐的文字工作里解放出来。
这条路还远着呢,还有好多坑要踩,好多问题没解决。但这不就是这行最吸引人的地方吗?
别被大模型吓住,自然语言处理的根其实碎得很
很多人现在一提NLP,张嘴就是GPT,闭口就是千亿参数大模型,好像这玩意是最近五六年才凭空变出来的。其实不然。往前倒六十多年,学界就开始琢磨怎么让机器懂人话了。 早年哪有什么大模型,全靠语言学家手写规则。一个词一个义项,一句话一套语法逻辑,一条一条往机器里码。就说中文里的“打”字,“打水”“打车”“打电话”“打游戏”“打酱油”,同一个字不同用法,每个都要单独写规则。早期自然语言处理规则语法树示意图
写着写着大家就疯了。活人说的话哪有那么多规矩?网络热词三天出一个,不同地方的方言口语有上百种表达,规则写得再多,永远赶不上语言变的速度。九十年代那批蹲实验室做NLP的,多半都在规则堆里熬掉了头发,最后承认这条路走不通。
说实话,直到统计机器学习起来,NLP才真正活过来。大家发现不用死磕规则,喂够语料让模型自己找规律就行。一下子打开了新局面,机器翻译、分词、词性标注这些任务的精度蹭蹭往上涨。我认识一个老研究员,那时候为了攒够中文语料,带着学生逐字逐句标了一年人民日报,现在说起来还连连叹气。
不过那时候的模型还是碎的。分词是分词,句法是句法,翻译是翻译,各个模块各干各的,前面错一步,后面全错。比如遇到“南京市长江大桥”,分成“南京 市 长江 大桥”是对的,要是分成“南京市长 江大桥”,后面的分析全乱了。这种歧义问题,那时候根本没法彻底解决。
大模型一统天下后,自然语言处理留了一堆烂摊子
BERT出来那一天,整个NLP圈都炸了。原来预训练+微调这么好用,一个底座能搞定几乎所有任务。到GPT把生成式这条路走通,直接把所有任务都揉成了“下一个词预测”,原来分模块的玩法直接被干没了。 现在发顶会论文,不搭个大模型底座,都不好意思给审稿人看。整个圈子都在围着大模型转,这没错吧?但是问题也真的不少。 大模型到现在都没解决NLP的本质问题:语言是传意图的,意图永远藏在语境里。你跟朋友逛店说“这杯子有点贵”,朋友知道你要么想找个便宜的,要么就是吐槽一句,大模型能接你的话,但是它真能get到你说这句话到底想干嘛吗?大模型自然语言处理上下文歧义案例对比图
上个月帮一个创业朋友看智能客服的项目,用户问“你们这款骑行头盔能挡小雨吗?”,机器人套着大模型,答出来的是“我们这款头盔符合国家安全标准,采用硬质PC外壳,缓冲性能达标”,你说答得错吗?没错,全是正确的废话。用户要的就是一句“能”或者“不能”,你绕这么大弯,用户转头就走了。
不过话说回来,大模型带来的改变真的是颠覆性的。之前做一个垂直领域的NLP项目,要标几千几万条数据,工程师和标注员熬好几个月,现在给大模型丢五六个示例,prompt写清楚,半天就能跑通可用的demo。原来要半年的活,现在一个实习生两个礼拜搞定,这放在十年前,想都不敢想。
未来的自然语言处理,我看要往小了做,往实了走
未来的自然语言处理,我看要往小了做,往实了走
现在整个行业都在卷参数,千亿不够要万亿,好像参数越大,NLP就做得越好。说实话,绝大多数落地场景,根本不需要这么大的模型。你手机里的输入法,要万亿参数干嘛?占十几个G内存,开着就掉电,谁用啊?
最近两年我看越来越多的研究开始往小模型走,做端侧NLP。把大模型的知识蒸馏到小模型里,精度掉不到一个点,速度快五六倍,还不用把你输入的隐私内容上传到云端,一举好几得。
自然语言处理的终极目标,从来不是做一个能陪人聊天吹牛的通用大模型,而是让机器听懂人话,帮人解决具体的问题。
给三甲医院做NLP工具,能从几十页的门诊病历里自动提取出过敏史、既往病史、用药记录,帮医生写病历省一半时间,这个比能写一百首情诗的大模型有用一万倍。给古籍研究所做NLP,能把扫描版的线装书自动识别、断句、标标点,帮历史学者省掉好几年整理文献的时间,这就是实实在在的价值。给做外贸的小企业做NLP,能自动把海外客户的邮件翻译成中文,还能提炼出客户的核心需求,帮小老板不用找翻译也能跟客户谈生意,这就是能落地的好技术。
前阵子听一个做了四十年NLP的老教授讲座,他说早年入行做NLP,就是想让机器帮人干那些咬文嚼字的脏活累活,现在好多人跑偏了,就比谁的参数大,谁的模型能聊天,忘了本来要干什么。我听完特别认同。
技术再炫,概念再热,最后要落到解决问题上。自然语言处理走了六十多年,从手写规则到统计学习再到今天的大模型,兜兜转转,核心其实从来没变:就是让机器能懂人类说的话,把人从繁琐的文字工作里解放出来。
这条路还远着呢,还有好多坑要踩,好多问题没解决。但这不就是这行最吸引人的地方吗?