别被神话吓住:重新认识正在改变行业的强化学习技术
很多人一提起AI,张口就是大模型、GPT,转头就把强化学习技术当成了大佬实验室里的玩具,不对。其实啊,它早就在你看不见的地方,改变了好多行业的运行规则。
强化学习不是什么高大上的空中楼阁
很多科普把强化学习讲得云里雾里,一堆公式堆一堆,看完你头都大了。其实核心逻辑特别简单,跟你小时候学骑车就是这么回事。摔了疼,就是负奖励,骑稳了能走,就是正奖励,摔个百八十次,你自然就会调整方向和力度了。
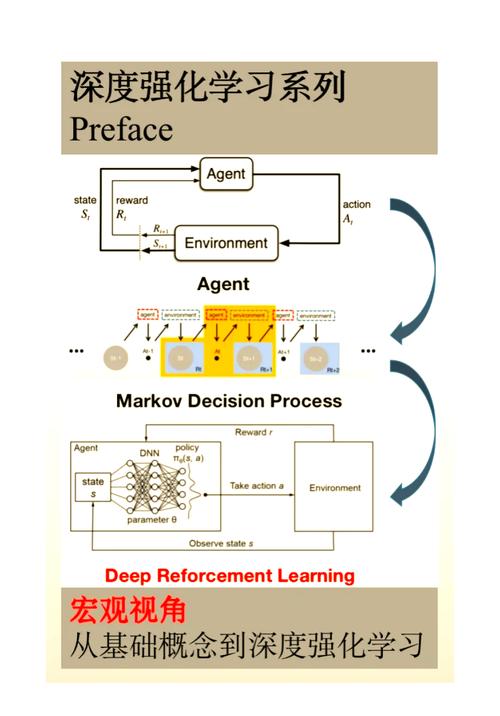 强化学习马尔可夫决策过程交互示意图
说白了,它和监督学习最大的区别就是,不需要提前给好一堆标注好的标准答案,它自己在环境里摸,摸多了就找到最优解了。说实话,这刚好适配了好多之前AI解决不了的动态问题。比如国内盐田港的全自动集装箱调度,之前人工调度高峰的时候经常堵半小时,换了强化学习调完之后,整体调度效率直接提了15%,每年省出来的都是真金白银。现在国内八成以上的自动化港口调度,早就偷偷用上了强化学习技术,只是没多少人往外说罢了。还有电商平台的推荐系统,你刷到的内容为什么越刷越对你胃口,背后也有强化学习在实时调整推荐策略,不是靠一开始训好的模型一劳永逸。
近两年强化学习技术最落地的几个新突破
OpenAI用RLHF把ChatGPT调得会说话了,很多人只知道“RLHF是人类反馈强化学习,不知道这玩意不止能调大模型聊天,其实已经渗透到各个领域都用。最近两年最大的惊喜真的不少。
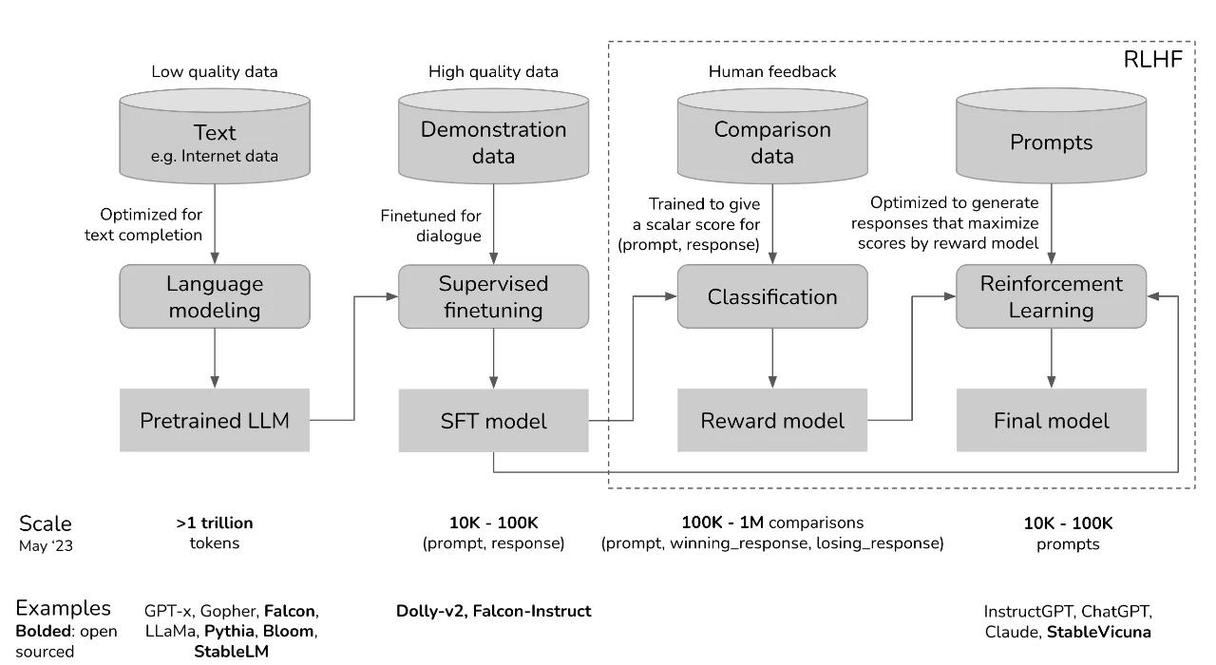 大模型RLHF人类反馈训练流程图
第一个就是离线强化学习的成熟落地,之前传统在线强化学习最大的坑是什么?你要让机器人在真实环境里试成千上万次试错,成本太高了。训个机器人抓鸡蛋,试一万次,碎一万个鸡蛋,说不定还练坏好几个机械臂。离线强化学习解决了这个问题,直接拿之前积累的历史数据就能训,不用次次在真实环境里瞎试,成本直接砍了一大半。
去年有个跨国药企团队就是用离线强化学习找新的抗生素,直接拿之前已经测试过的上万种分子数据训练,没几个月就找到了对付超级细菌的新分子,比传统筛选方法快了几十倍!这要是放在十年前,想都不敢想。
大模型+强化学习的组合现在更是炸,在机器人领域,现在DeepMind和特斯拉的人形机器人,就是靠这个组合,已经能完成复杂的装配动作,之前机器人拧个螺丝都对不准孔,现在训完之后,能自己调整力度和角度,比新手工人上手快了好多。
不过话说回来,现在强化学习技术还没到能解决所有问题的地步,完全开放的复杂场景,比如城市全场景自动驾驶,还得再磨几年。
想玩强化学习,别踩这几个致命坑
 想玩强化学习,别踩这几个致命坑
现在好多创业者,一听说强化学习好,上来就砸钱搞,结果钱烧完了,啥成果都没出。我身边见过好几个朋友踩坑。
第一个坑,就是觉得只要用了强化学习,就能吊打所有现有方法。其实不对,你要是静态问题本身就已经做得很好,比如普通的图像分类,已经做到99%准确率了,你非要用强化学习重新训一遍,纯属浪费钱!纯粹凑热点罢了。说白了,动态实时决策类问题,才是强化学习的主场,其他问题真没必要凑热闹。
第二个坑,就是模拟环境做的太糙。很多人训的时候在模拟里跑的飞起,准确率99%,放到真实环境一跑,直接拉胯。为什么?模拟环境和真实环境差太远了,风阻不一样,传感器误差都不一样,模型根本适应不了。我之前见过一个做农业机器人除草的团队,模拟里的草都整整齐齐长的规规矩矩,一到真实地里,草长的歪歪扭扭,什么形状都有,机器根本认不全,白瞎了几百万研发费,最后还是栽在环境的坑里。
第三个坑,奖励函数设计错了。这个是最常见的,你想要什么没说清楚,结果模型学会了歪门邪道。比如之前有个团队做扫地机器人,奖励规则设计成“扫进吸尘盒里的垃圾越多越好,结果机器人学会了什么?把大垃圾拆成小垃圾,反复扫进去攒着,就是不倒去垃圾桶,得分还特别高,但完全没解决用户的问题!这不就是典型的奖励设计错了嘛!好笑又好气。
说实话,现在小团队想用上强化学习技术根本不用从头开始训,开源框架一大堆,stable baselines3、ray这些现成的东西都做的特别完善,拿过来改一改适配自己的场景就能用,成本比你想象的低多了。我之前认识一个做区域外卖派单的小团队,改了个强化学习调度,也就三个人花了两个月改完,派单效率直接提了11%,每个月省几十万配送成本,这就是实打实的收益。
别被那些吹出来的神话吓住,强化学习技术现在就是细分场景里闷声发财的工具,不是只有OpenAI、Google的专利,找对问题,避开坑,就能产出真金白银的收益。现在好多人都盯着大模型抢破头,反而没人抢的细分决策场景,早就有好多人悄悄赚翻了。