量子机器学习:当叠加态撞上梯度下降
2019年,谷歌把53个量子比特堆在一起做了件事——用200秒完成经典超算要跑一万年的采样任务。新闻标题很热闹。但如果你真去翻那篇发表在《自然》上的论文,会发现一个被淹没的细节:他们原本计划验证的是量子机器学习在特定任务上的加速潜力,结果采样跑通了,训练反而卡住了。这个卡住的瞬间,比那200秒更值得琢磨。
数据编码:第一道过不去的坎
经典机器学习的数据是现成的。一个32×32的手写数字图片,784个像素值,直接扔进784维的向量空间就行。量子机器学习没这么便宜的事。
量子态是复数向量空间里的单位向量。你想把一个经典数据集编码进去,路径有两条:要么用角度编码,把每个特征映射成绕布洛赫球旋转的角度;要么用振幅编码,把2^n个数值塞进n个量子比特的振幅里。前者省事但深度受限,后者理论上指数级压缩但制备开销极大。
问题来了。振幅编码构建一个n比特的任意态,需要的门数量是指数级的。换句话说,你想省下经典内存,就得付出量子电路深度的代价。这还没算上误差校正的开销——当前含噪中等规模量子(NISQ)设备的门保真度撑死99.9%,几百个门串下来,信号早被噪声吃了。
 量子比特布洛赫球角度编码示意图
更尴尬的是重复加载。经典ML一个epoch可以反复扫同一批数据,量子电路里你没法复制未知量子态——不可克隆定理在那儿摆着。想把数据读进去一次然后反复用?行,但那意味着整个算法得设计成一次加载、多次调用,灵活性大打折扣。
贫瘠高原:不是梯度消失,是梯度压根儿不出来
经典深度学习有个老毛病叫梯度消失。深层网络里反向传播的梯度越往回传越小,最后层几乎收不到有效信号。解决办法换来换去,ReLU、残差连接、BatchNorm,总算压住了。
量子变分电路里的问题更彻底。2018年McClean等人给了一个名字:贫瘠高原(barren plateau)。当量子比特数增加、电路深度拉到一定阈值,参数化量子电路的目标函数梯度以指数速度趋近于零。不是太小,是指数级趋零。经典优化器再猛也没辙——梯度是零,往哪儿走?
这个现象的原因得分开看。随机参数化电路在希尔伯特空间里探索时,代价函数的方差随比特数指数衰减。直觉上理解:n个比特的态空间是2^n维的,你拿一个局部可观测量的期望值去衡量,不同方向的梯度互相抵消,平均下来就是零。
对策有几条。一是电路结构上做文章,用问题启发的哈密顿量变分拟设替代硬件高效拟设,让参数初始化落在有梯度的区域。二是局部代价函数——只看少数几个比特的观测量。三是逐层训练:先训浅层,冻结参数再加层。但这些策略目前都还是经验性的,没有统一的理论保障。
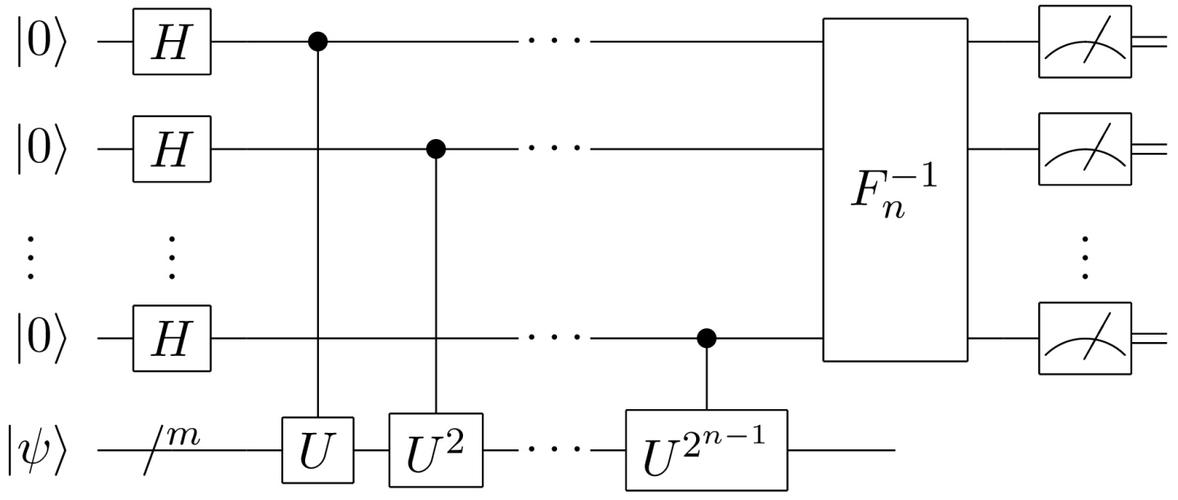 量子变分电路参数化门序列结构图
那个绕不过去的“量子优势”
 那个绕不过去的“量子优势”
量子机器学习最尴尬的地方在于:很多声称有量子加速的算法,加速来源其实和机器学习本身没关系。
比如HHL算法解线性方程组,指数加速。机器学习里的最小二乘、岭回归都能归结为解线性方程组。所以量子机器学习能指数加速——听起来很顺。但细看:HHL要求矩阵是稀疏的、良态的,还得有高效的量子态制备和读出。读出一个n维经典向量需要至少n次测量,这一项就把指数加速吃回去了。更别说稀疏性和条件数在实际ML数据集上经常不成立。
还有一类是核方法。量子核估计能在特征空间里算内积,理论上比经典核多一个指数级大的特征空间。问题是那个特征空间里的核矩阵,经典计算机也能估算到差不多的精度——只要数据维度不太高。量子核的实用优势区间窄得可怜。
真正踏实的加速路线可能只有一条:用量子计算机模拟量子系统,然后从模拟结果里做机器学习。比如量子化学里预测分子基态能量,经典方法算不动的大分子,量子处理器有天然优势。这属于本征量子优势,不是偷换概念。
NISQ时代的现实边界
 NISQ时代的现实边界
当前所有能跑的实验都在NISQ框架下。量子比特数几十到几百,相干时间微秒级,门操作误差千分之一量级。这个硬件档次上,能做的量子机器学习实验其实很有限。
变分量子分类器是研究最多的方向。拿一个参数化电路当分类模型,经典优化器在外循环调参数,量子处理器在内循环算期望值。这种混合架构对硬件要求最低,但效果嘛……在标准数据集上超过经典SVM的案例,我还没看到令人信服的。
量子生成模型是另一个热点。量子电路Born机、量子GAN,思路是用量子态的概率分布当生成分布。问题在于训练不稳定——量子电路的输出分布随参数变化剧烈,梯度信息又难获取,收敛性比经典GAN还飘。
最现实的场景可能是量子增强的经典机器学习。比如用量子处理器采样困难分布,为经典模型提供训练数据;或者用量子核方法做低维特征映射,然后交给经典分类器。这种杂交路线不追求端到端的量子优势,只要在某个子模块上有实际加速或精度提升就算成功。
说实话,量子机器学习现在的位置有点像2006年的深度学习。概念热、实验少、理论框架不完整。但要说它全是泡沫也不对——贫瘠高原的发现本身就是理论贡献,它划定了参数化量子电路的可训练边界。这个边界在哪里、能不能推远,是未来五年最值得盯的问题。
硬件那边如果容错量子计算机真能落地,shor算法和grover算法带来的加速会重构整个机器学习栈的底层假设。但在那之前,量子机器学习的论文里最好多写几句“在特定条件下”和“已知局限性”。毕竟,叠加态再美,也得先过梯度下降这一关。