混沌工程不是碰运气:从 Netflix 猴子到 AI 推理集群的故障实验
先泼盆冷水:如果你以为混沌工程就是找个低峰期把服务器拔了,看看报警响不响,那你大概率会收获一次 P0 事故和一份复盘报告。
真正的混沌工程,更像受控的纵火实验。消防员在空地上点燃一间模型屋,记录火势、风速、逃生路径。工程师在系统里注入延迟、错误、网络分区,观察业务指标是否守住稳态。区别只有一个:模型屋烧了没事,线上系统烧了,老板会找你。
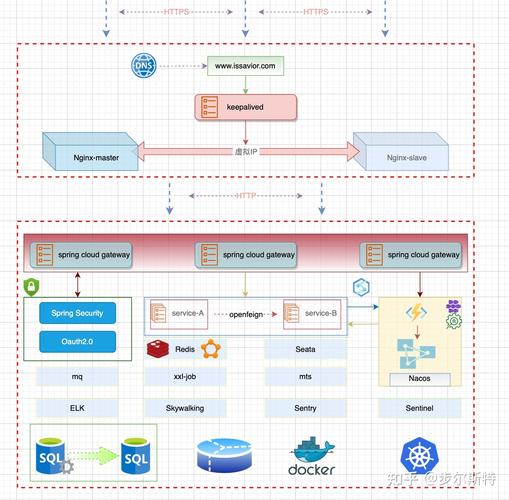 云原生混沌工程故障注入架构图
从 Netflix 那只猴子说起,混沌工程不是新瓶装旧酒
2011 年,Netflix 把 Chaos Monkey 丢进生产环境。这猴子不讲武德,随机干掉虚拟机。当时很多人觉得疯了。可 Netflix 的逻辑很硬:系统早晚会坏,与其等它自己坏,不如主动让它坏。
后来 Simian Army 扩编,Chaos Gorilla 干掉整个可用区,Chaos Kong 干掉整个区域。再后来,Principles of Chaos Engineering 把这事写成方法论:定义稳态、假设、真实流量、生产环境、最小爆炸半径、持续运行。你看,关键词全在。混沌工程不是测试,是实验。测试问“这个功能对不对”,实验问“系统在故障下还能不能守住业务”。
科研成果这块,早年论文更多在讲案例。近五年不一样了。ICSE、FSE、SREcon 上,混沌工程相关研究从零星几篇涨到每年几十篇。有人做自动实验生成,有人做故障传播图,有人拿强化学习挑最可能崩的链路。说实话,有些论文离生产还很远。但方向很明确:从人肉写脚本,走向系统自动找弱点。
工具也卷。Chaos Mesh、LitmusChaos、ChaosBlade、AWS FIS、Gremlin、Azure Chaos Studio。开源和商业一起上。CNCF 把混沌工程塞进云原生韧性版图,平台工程团队开始把它当基础设施,不是一次性活动。
最贵的不是工具,是爆炸半径
我见过最离谱的混沌实验:有人直接在生产集群里注入 100% 的 Redis 超时。结果呢?订单服务雪崩,客服电话被打爆。这不是混沌工程,这是混沌。
实验设计里,稳态假设是第一步。别说“系统不挂”。太粗。要落到 SLI:订单成功率大于 99.9%,支付 P99 小于 200ms,推荐流可用性大于 99.95%。然后提出假设:如果支付网关延迟增加 300ms,订单成功率仍能保持 99.9% 以上。接着注入故障。最后看数据,不是看感觉。
 微服务混沌实验爆炸半径控制示意图
爆炸半径怎么控?按比例、按用户、按区域、按时间。先 shadow 流量,再 1% 生产流量,再 5%,再全量。每一步都要有中止条件。比如错误率超过 1% 自动回滚,P99 超过阈值自动停止。别靠人盯。人会在关键时刻手抖。
可观测性是命门。没有 Trace、Metrics、Logs,混沌工程就是盲人摸象。OpenTelemetry 把链路串起来,Prometheus 盯指标,eBPF 做无侵入注入。现在不少团队把混沌实验和可观测性平台打通:实验一跑,Dashboard 自动切到故障视图。爽。
还有文化。混沌工程最怕 KPI 化。什么“每月必须发现 10 个故障”,这就变味了。实验失败也是结果。没发现问题,说明稳态守住了。发现问题,恭喜,你提前把雷排了。复盘要对着系统,不是对着人。
2025 年,混沌工程已经卷到 AI 和数据库了
以前混沌工程主要折腾微服务、Kubernetes、数据库。现在多了新战场:AI 推理集群。
GPU 会坏,NCCL 会超时,KV Cache 会抖,模型版本会回滚失败。LLM 服务一挂,可不只是 404。可能是整条 Agent 工作流卡死,可能是内容安全策略失效。所以现在有团队在做AI 混沌工程:注入 GPU 掉卡、推理延迟、Token 限流、向量数据库超时。看业务能不能降级到小模型,看缓存能不能兜住。很新,但很刚需。
数据库这边更成熟。TiDB、OceanBase、PolarDB 这类分布式数据库,早就把混沌测试写进研发流程。网络分区、磁盘 IO hang、时钟漂移、副本滞后。金融行业尤其狠,因为一次数据不一致,可能就是监管事件。现在混沌工程和灾备演练、红蓝对抗开始合流。安全团队也来掺一脚:注入 IAM 错误配置、证书过期、密钥轮换失败。这叫安全混沌工程。
 Kubernetes Pod故障演练混沌工程场景图
还有个趋势:平台化。Backstage 插件一点,自动生成实验;GitOps 里声明混沌实验;CI/CD 流水线里跑轻量级混沌测试。开发提交代码,流水线先注入网络延迟,跑一遍集成测试。不过话说回来,生产环境才是终极考场。预发环境太干净,干净得不像真实世界。
别急着在生产放火,先跨过这四道坎
第一道坎,监控覆盖度。你连业务指标都说不清,就别谈稳态假设。第二道坎,回滚速度。故障注入容易,一键恢复难。第三道坎,权限和审批。谁有资格按下这个按钮?必须有审计。第四道坎,组织信任。开发觉得运维在甩锅,运维觉得开发玻璃心。那实验做不下去。
我的建议很土:从小开始。选一个非核心服务,选一个低峰期,选一个可回滚的故障。跑通一次完整闭环。记录假设、指标、结果、改进项。然后每季度搞一次 GameDay。别贪大。混沌工程的价值,不是搞垮系统,是让团队对故障不再恐惧。
系统会老,网络会抖,磁盘会满,云厂商会发故障通告。与其半夜被电话叫醒,不如白天主动把系统弄坏。真的。大概就这样。