大屏全绿的那晚:云原生可观测性为什么没兜住那个Bug
凌晨两点十七分。手机在床头柜上震了三下,我一般来说是不接的——除非是P1告警。那晚是P1。
爬起来打开电脑,跳进监控大屏,一片绿。CPU正常,内存正常,QPS正常,连P99延迟都在SLO范围内。所有仪表盘都在说:没事,睡吧。但告警内容写得很清楚——订单创建接口大面积超时,持续十五分钟了。
大屏全绿,故障依旧。这种场景你肯定见过,或者迟早会见到。
这就是我今天想聊的事——不是聊“什么是可观测性”那种百科定义,而是聊一个我们踩过很多次的坑:当你把所有该采的数据都采了,为什么还是定位不了问题。
先别急着埋点,想想你在回答什么问题
刚做云原生的时候,我对可观测性的理解特别朴素:多埋点,多采集,多建几个Dashboard。Metrics不够?上Prometheus。日志不够?堆ELK。链路看不到?接Jaeger。三件套齐活,还能出什么问题?
后来发现,问题恰恰出在这个“齐活”上。
Metrics、Logs、Traces这三样东西,解决的是完全不同的问题。把它们混在一起叫“可观测性”,就像把体温计、B超和CT统称为“看病”——对,都能帮助诊断,但它们回答的是不同维度的问题。体温计告诉你发烧了,但发烧的原因,它说不出来。
回到那晚的故障。我们的CPU、内存、QPS全绿,因为这些是资源维度的指标。但你说的“超时”是个请求维度的问题——某个下游依赖变慢了,线程池被占满了,然后像多米诺骨牌一样传上来。
资源指标看不到这个过程。它只告诉你机器累不累,不告诉你请求在路上经历了什么。
 云原生微服务链路追踪火焰图示例
那Traces呢?我们有啊。但你去翻的时候发现,采样率设的是1%。一万个请求里抓一百个,出问题的那一批恰好不在里面。你说气不气人。
所以第一个反直觉的点:可观测性不是“数据够多”,而是“在需要的时候能回答你没想到的问题”。这两件事的差距,比想象大得多。
高基数:那个让账单失控的隐形杀手
 高基数:那个让账单失控的隐形杀手
说到采样,绕不开一个词——高基数(High Cardinality)。这个词听起来很抽象,但理解它你只需要知道一件事:它指的是你给指标打的标签里,取值的种类特别多。
比如你给HTTP请求时长打了标签 path=/api/orders/{id}。如果{id}是几百个还好,如果是几百万个,你的时序数据库就废了。每条时间线都要单独存储、单独索引,内存蹭蹭涨,查询慢得像蜗牛,账单直接起飞。
我自己第一次被高基数搞崩溃是在三年前。一个同事很热心,说“咱们把所有用户ID都打上标签吧,这样排查问题方便”。上线第二天,Prometheus就OOM了。老板看着云账单的眼神,我到现在还记得。
说实话,高基数是可观测性里最容易被低估的成本项。大家都在聊“采什么数据”,很少有人聊“采了之后存储和查询的代价是什么”。
但这东西又不能不碰。因为真正有价值的排查线索,往往就藏在那些高基数的维度里。用户ID、订单号、会话ID——这些才是把“系统有问题”变成“这个用户的这一笔请求有问题”的关键。
矛盾吧?一边是成本,一边是精度。这就是可观测性领域最核心的张力之一。
解法呢?采样策略。但不是随便采。头部采样(Head Sampling)在请求一开始就决定要不要采,简单但盲目;尾部采样(Tail Sampling)等请求走完了再判断——慢的、报错的,统统留下,快的正常放走。这在链路追踪里特别有用。不过话说回来,尾部采样对Collector的内存要求很高,你得把所有Span先攒着,等判断完了再决定丢弃哪些。又是一个资源换精度的博弈。
告警疲劳:当你的系统喊狼来了太多次
大屏全绿那晚,还有一个细节。我们其实是有告警的——下游服务的连接池使用率到了85%,触发了一条Warning。但没人理它。因为这条告警每天要响几十次,阈值定得太敏感,动不动就跳。久而久之,大家条件反射地关掉它。
这叫告警疲劳。是个心理问题,也是技术问题。
你可能会说:那把阈值调高一点不就好了?问题是,阈值调高了,真出事的时候又来不及了。85%不报,95%报,但从85%涨到95%可能只需要三秒。
静态阈值的根本问题在于,它假设系统行为是稳定的。但云原生环境下的流量、拓扑、依赖关系随时在变,昨天正常的基线,今天可能就是异常。你用一条固定的线去切动态的数据,切出来的结果能靠谱吗?
这也是为什么越来越多团队在聊动态基线和异常检测——用过去一段时间的实际行为来预测“现在应该是什么样”,偏离得太远才告警。听起来很美好,但落地起来又是一堆坑:季节性波动怎么处理?大促流量怎么区分?模型误报怎么调?
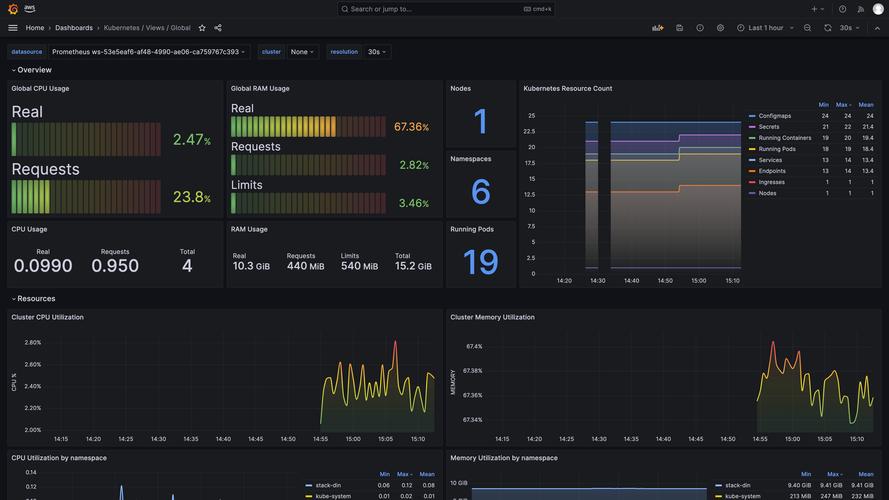 Kubernetes Pod 资源监控告警面板截图
我自己的态度比较务实:动态基线可以在核心链路上用,但别全量铺开。先把那些真正影响用户的指标——错误率、核心接口延迟——用上,其余的保持简单可解释的静态阈值,至少出问题的时候你知道为什么报警。
说到底,可观测性是一场认知升级
 说到底,可观测性是一场认知升级
聊了这么多技术细节,其实背后是一个挺朴素的道理。
监控(Monitoring)问的是“系统正常吗”;可观测性(Observability)问的是“系统为什么不正常”。前者是判断题,后者是问答题。你没法用判断题的思路去解问答题。
所以工具很重要,但更重要的是思路——先想清楚你要回答什么问题,再去决定采什么数据、用什么采样、建什么看板。反过来做,就是被工具牵着走,最后堆了一堆数据,排查故障的时候依然抓瞎。
那晚的Bug最后定位到了吗?定位到了。一个下游服务的连接池配置在滚动更新后没生效,慢查询积压把线程池打满了。从Traces里一根异常的Span找到根因,花了四十分钟——前提是那根Span恰好被采到了。运气好。
但下次呢?
我不想再靠运气了。这就是为什么我开始认真对待采样策略、高基数控制和告警质量——不是为了多采集数据,而是为了在需要答案的时候,数据能开口说话。