算力网络:卡在机柜之间的那十五毫秒
凌晨两点多,苏州一个智算中心的运维群里飘出一句话:“A区三号池,128卡的任务,allreduce 卡住了。”
下面没人接话。过了三分钟,有人甩了张 nvidia-smi 截图——GPU 利用率 12%。又过两分钟,另一张交换机的端口计数器截图来了:几个 400G 口跑到百分之九十几,PFC 计数在往上蹦。
卡没坏。网也没“断”。可任务就是不动。
这就是算力网络最真实的一面。它不在白皮书里,不在发布会的大屏上。它在凌晨两点这个群里。
先把话说明白:算力网络不是把全国的显卡接成一根线
不少人一听“算力网络”,脑子里浮出的是国家电网那套画面——西边的电送到东边,插上就能用。方向没错,差得挺远。
电是标准的,220V 就是 220V。算力不是。这台机器插的是 A 家的卡,隔壁机柜是 H 家的,再远一点是国产某款 NPU,编译器都不一样,算子库对不上。你把这堆东西接起来,它们不会自动变成一台大电脑。
所以业内讲的算力网络,其实是三件事叠在一起。
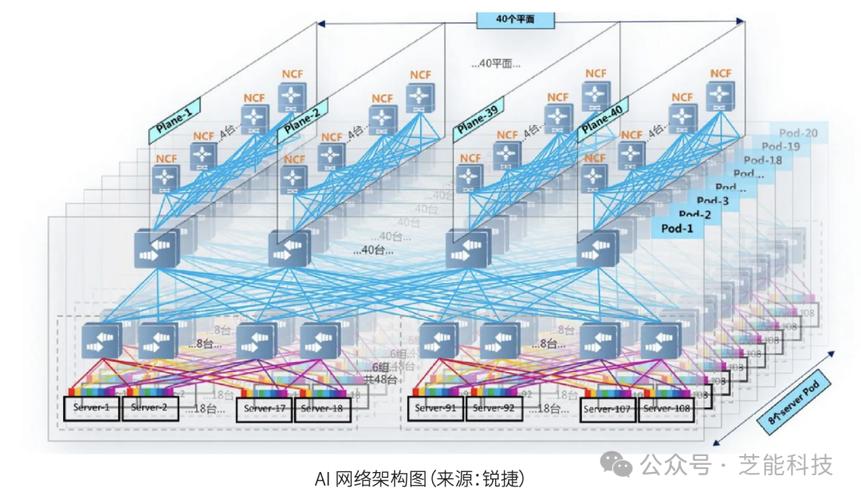
底下是异构算力资源——各种型号的加速卡、CPU 集群、存储;中间是那张网——机柜内的高速互联、园区里的 Spine-Leaf、跨城市的长途光缆;上面是调度——决定哪个任务放到哪张卡上,走哪条路。
三层缺一层都不成立。缺了底下,没东西可调;缺了中间,算力搬不动;缺了上面,就是一堆各自为政的机房。
 智算中心GPU服务器机柜集群高速互联布线实景
光在玻璃里跑多快?这是绕不过去的账
算个账吧。
光在光纤里的速度大概是每秒二十万公里,比真空慢三分之一。换算下来,每公里大约五微秒。五微秒是什么概念?你家宽带 ping 一下网关差不多一毫秒,是它的两百倍。
南京到贵阳,直线一千二百公里上下。光缆不可能拉直线,实际走线通常要乘个一点三到一点五。算下来单程七八毫秒,一来一回十五六毫秒。
十五毫秒,人感觉不到。你打游戏延迟十五毫秒还挺流畅。
可对一个训练任务来说,这是灾难。分布式训练里 GPU 之间的通信是同步的——一批梯度算完,所有卡得先把结果换来换去,再算下一批。这个动作叫 AllReduce,一秒钟可能发生几百次。
机柜内走 NVLink 或者 InfiniBand 的时候,这个交换是微秒级的。跨到一千公里外,每次都得等十几毫秒。你算一下那个乘数。
这就是为什么“东数西算”里,训练任务大部分还留在东部,西部接的多是对时延不敏感的活儿——离线推理、数据清洗、渲染、备份。不是不想放,是物理不允许。
 长距离数据中心光纤互联传输时延分布示意
真正难缠的不是带宽,是抖动
 真正难缠的不是带宽,是抖动
外行看带宽,内行看抖动。这句话在算力网络里体现得特别明显。
现在机柜内跑 RDMA,也就是让网卡直接读写对端内存,绕开 CPU。听着很美好,代价是——RDMA 对丢包几乎零容忍。传统 TCP 丢个包重传一下,慢一点而已;RDMA 丢一个包,整条队列可能就堵死了。
于是有了“无损网络”这套东西。PFC 负责在快溢出的时候发暂停帧,ECN 负责提前打标记让发送端降速。听起来是个闭环,很稳。
实际上呢?PFC 触发不当,会出现暂停帧风暴——A 让 B 停,B 让 C 停,最后全网都停。业内管这叫死锁。你查半天,最后发现是某台交换机上一个 ECN 门限配错了。
我碰见过一次。一个 128 卡的任务,跑十几个小时崩一次,崩的时候报通信超时。查了三天,最后是某台交换机的 buffer 配置和旁边那台不匹配,长尾流被丢了。
你说这算网络问题还是算力问题?都算。这正是算力网络让人头疼的地方——它的故障经常横跨两个团队的边界。网工说卡有问题,算力运维说网络有问题,最后谁都不背锅。
调度器调的不是显卡,是作业
很多人以为算力调度就像虚拟机迁移,把一张卡上的活儿挪到另一张卡上。真做不到。
一个训练任务的进程、显存里的状态、通信组的成员关系,全都绑死了。你没法把一个跑了六小时的活儿优雅地搬到另一台机器上接着跑——除非从 checkpoint 重启,那等于白跑。
所以在算力网络里,调度发生在任务开始之前。调度器做的事是:看这个作业需要多大的通信域,要几张卡,卡之间要不要走 NVLink,然后去找一块拓扑上合适的地方把它放下去。
这里有个词叫拓扑感知。同一个 AllReduce 组里的卡,尽量放在同一台机器、同一个 leaf 交换机下面。放错了,性能能差出好几倍。
再往上,跨数据中心那一层更微妙。你不能简单说“西部便宜,都往西边塞”。一旦跨域,通信模式就得换——从高频同步的 AllReduce,换成流水线并行、参数服务器这种低频交互的玩法。换的是算法,不光是网络。
所以一个真能用的算力网络调度器,得同时懂三件事:卡的拓扑、网的时延、作业的通信模式。这三样凑齐的人,说实话不多。
那些听起来很美、落地很疼的地方
“算力并网”这个词这两年很热。各家的算力平台把这边的卡、那边的卡登记上来,对外提供统一入口,按卡时计费。
商业上挺美好。技术上呢,有几个坎一直没迈过去。
一是异构兼容。客户写好的模型基于某个生态的算子库,换到另一种卡上,性能可能掉一半,甚至跑不起来。你要客户改代码,客户扭头就走。
二是SLA 说不清。你承诺“给 128 张卡跑 24 小时”,可中间网络抖一下、邻居的作业抢一下带宽,实际交付的算力就不是你承诺的那个。算力不像电,没法用一个瓦特数标死。
三是数据搬运的成本。算力可以调,数据呢?几百 TB 的训练集放在东边,你把任务调到西边,数据怎么过去?走网络得几天,走硬盘得寄快递。这笔账一算,有时候还不如本地跑。
四是利用率的水分。有些平台对外说的利用率,是按卡时卖出去的时长算的,不是按 GPU 真正在算的时间算的。这两者能差出三四成。一台机器挂着任务在跑,可 GPU 只有两成时间在干活,这事儿太常见了。
我的判断:这事儿的核心是收敛不确定性
写到这里说点个人看法。
算力网络这个词,被包装得有点太大了。听着像是要把全国的算力做成一个池子,随便舀。短期做不到,长期也未必是那个形态。
它真正在解决什么?我的答案是:把不确定性收敛掉。
用户买算力,怕的不是贵,是不知道会出什么幺蛾子。任务跑一半通信超时,卡时照收;说好的 128 卡,实际拿到的是不同代的混卡;今天能跑,明天邻居一上量就慢一半。这些不确定性,才是真正的成本。
所以算力网络的价值不在“把卡连起来”,而在“让业务敢把作业放过来”。这需要的是可预测的时延、可解释的计费、可复现的性能。听着不性感,但这是所有花哨概念的地基。
至于发布会上说的那些东西……嗯,等它先熬过一个凌晨两点再说吧。