异构算力调度:任务为什么总卡在拓扑的缝隙里
一台八卡服务器,监控面板上 GPU 利用率停在 43%。排队中的任务却在报显存不足。这两件事同时为真,说明问题不在算力总量,而在算力怎么被切分。
异构算力调度要处理的从来不是把任务放到某台机器上那么简单。它面对的是一个带约束的匹配问题:设备能力不可通约,任务需求难以量化,可用资源随时在变。
设备能力无法通约,这才是麻烦的起点
CPU 讲浮点峰值和缓存命中率,GPU 讲流多处理器占用率和显存带宽,NPU 讲算子覆盖率和片上缓冲复用率,FPGA 讲布线资源和时序收敛。这些指标之间没有换算关系。你没法说一张卡的某个 TOPS 等于多少张 CPU 的多少核——因为真实吞吐取决于数据布局、批大小和算子组合。
有人试图用统一的算力度量把它们拉到同一根坐标轴上。方向可以理解,代价是丢掉关键信息:一块加速卡能塞下多少并发请求,取决于序列长度分布,而不是它的峰值算力。
于是调度器看到的,往往是一张被削平的资源图。它以为自己知道每台机器还剩多少能力,其实只知道一个延迟极高的近似值。
还有一个常被跳过的约束:功耗和供电。机柜的配电上限、散热余量、乃至单卡的热设计功耗,都会在任务密集排布时变成硬墙。算力够、电不够,这个场景在真实机房里出现的频率比想象中高。
抽象层每加一层,延迟就多一层
CUDA、ROCm、CANN、oneAPI,再套上某个推理运行时或者图编译器。写代码的人舒服了,做调度的人头疼了。
内核启动延迟、算子融合失败导致的回退、动态形状触发的重新编译——这些在抽象的上层全部不可见。调度器只知道这台机器上还有空闲设备,不知道它下一次核函数发射要等 20 微秒还是 2 毫秒。
举个具体的例子。一个算子因为形状不匹配没被融合,中间张量被完整写回显存,访存模式瞬间恶化,显存占用翻倍。任务因此失败。而调度记录里写的仍然是设备资源充足。
说实话,很多跨设备调度效果不理想,不是算法差,是信息在中间层被吃掉了。
 异构算力集群GPU与NPU拓扑互联结构示意图
静态划分、动态抢占、拓扑感知
静态划分的好处是稳定。把卡固定分给各个团队,谁也不抢谁,出问题好回溯。坏处更明显:夜里那批训练跑完了,空出来的卡没人用,而隔壁团队在队列里等着。
动态抢占把利用率抬上去,代价是任务换出换入的开销,以及检查点写得够不够快。一个较大规模模型的检查点写入如果占掉三分钟,抢占频率就得压到很低。否则大部分时间都花在搬家上。
拓扑感知这一项常被低估。同一台机器上,高速互联域内的通信带宽和跨 NUMA 节点的 PCIe 路径能差一个数量级。把一组需要频繁做集合通信的进程切开放到两台机器上,训练速度可能直接掉三成,而调度器以为自己做了一次漂亮的均衡分配。
反过来说,拓扑感知也不是越细越好。对通信量很小的任务,按拓扑打分只会增加决策复杂度,收益接近于零。
还有硬件切分本身。多实例 GPU 能把一张卡切成若干固定实例,隔离干净,但切分比例在运行时改不了,灵活性差。若采用时间片方式共享,隔离又不够强,邻居的长核函数会拖慢旁边的小请求。
在容器编排系统上落地时遇到的具体障碍
以 Kubernetes 为例。设备插件机制把加速卡暴露成一种扩展资源,而扩展资源只支持整数计数。一张卡要么被整块占用,要么不被占用。
但现实是,一个小模型的推理只用到一小部分显存,剩下的空间闲着。共享方案——时间片轮转、多进程服务、显存切分——各有各的隔离缺陷。显存被切开了,算力没被切开;算力被隔离了,缓存又互相干扰。
NUMA 亲和、PCIe 拓扑、设备直通模式,这些信息在标准资源模型里没有位置。要么扩展调度器,要么在上层做二次编排,两条路都有维护成本。前者要求你跟进上游版本的变更,后者要求你在业务侧承担额外的状态管理。
优先级和抢占的交互也很麻烦。高优先级任务发起抢占后,被抢占的任务需要时间释放资源,而这个窗口里新的分配请求可能已经进来了,导致同一块设备被重复记账。日志上看是资源冲突,根子上是状态同步的延迟。
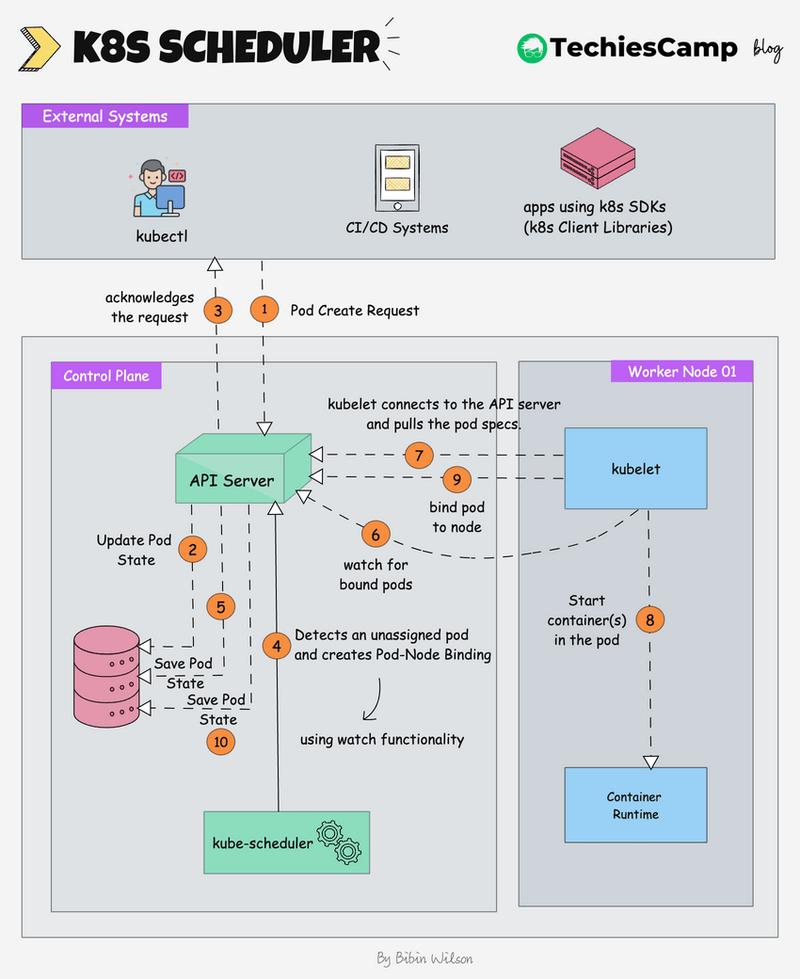 Kubernetes设备插件异构加速卡资源调度流程图
什么时候不该调度
单机单卡、任务独占一整块设备的场景,引入调度框架纯属给自己找活干。
离线批处理如果任务粒度粗、运行时间长,采用成组调度的等待反而制造碎片:一个小任务凑不齐配置,卡在那儿等,而资源其实够它单独跑。调度器的严格反而成了约束。
还有一种情况常被忽略——任务的算力需求本身不稳定。推理服务的请求量波动大,动态调度器反复迁移实例,冷启动成本累积起来比节省的资源更多。这不是调度器算错了,是它优化的是一个错误目标。
调度不是越多越好。它的收益上限,由任务的迁移成本和资源碎片的时间尺度共同决定。这两个量都测不准的时候,宁可保守。
回到那台机器
利用率 43% 和显存告警同时出现,说明调度决策的粒度停在了设备级别,而任务需要的粒度在显存、访存带宽和互联带宽上。
要做的事其实很朴素:把真实约束暴露给调度器,让它知道自己分配的是什么。剩下的,才是算法要解决的问题。多数时候困难不在于写不出调度策略,而在于没有人愿意把底层那些不体面的细节,一层层递到决策的位置上。