抗风险技术设计:别把“高可用”挂嘴上,先把故障当常态
凌晨两点,告警群又炸了。先是支付接口超时,接着订单服务雪崩,最后连后台报表都打不开。值班同学在群里发了一句:机房是不是又抖了?没人笑。因为这句话太熟了。
抗风险技术设计,说穿了就一句话:别把故障当意外,把它当常态。但真做起来,远比买几台服务器、挂个负载均衡复杂。复杂在哪?往下聊。
先承认吧,系统一定会坏
很多团队做架构评审,最爱问“峰值能扛多少QPS”。这问题当然重要,但它只覆盖了性能维度。真实世界里的故障,往往不是流量慢慢涨上来的。光纤被挖断、云厂商可用区抖动、证书过期、K8s控制面升级卡住、数据库主从切换时那个诡异的主键冲突……这些事,你没法靠“多加机器”解决。
科研圈这几年有个明显变化:韧性(resilience)正在被拆成可观测、可度量、可验证的工程指标。以前讲高可用,像讲玄学;现在讲抗风险技术设计,得拿数据说话。比如平均恢复时间MTTR、故障注入后的成功率跌落曲线、降级策略触发后的业务损失估算。没有这些,所谓“高可用”就是一句口号。
 云原生抗风险技术设计多可用区容灾架构示意图
我见过一个挺典型的反面案例。某业务做了双机房,平时演练只拔网线。结果真出事,是数据库连接池耗尽。双机房倒是活着,可连接池配置没做隔离,一个慢查询把整个池子拖死。你看,冗余堆了不少,故障域没切开,等于白搭。
冗余不是买保险,是设计交易结构
这话有点拗口?换个说法。冗余不是“多买一份”,而是“想清楚出故障时牺牲什么、保住什么”。
比如支付链路。真到了极端情况,你是保下单还是保查询?是让用户看到“支付结果确认中”,还是直接报错?这背后不是技术选型,是业务交易结构。抗风险技术设计最怕的,就是技术团队自己拍脑袋做降级,业务方事后才知道。那场面,啧,能吵到天亮。
现在不少团队开始用故障树分析(FTA)加贝叶斯网络做风险建模。听着学术,其实道理朴素:把“用户支付失败”当成顶事件,往下拆网络、数据库、第三方通道、配置变更,标出概率和影响。科研上这叫概率风险评估,工程上就是让你别拍脑袋。哪条链路最容易炸?哪个依赖没有替代方案?图上看得清清楚楚。
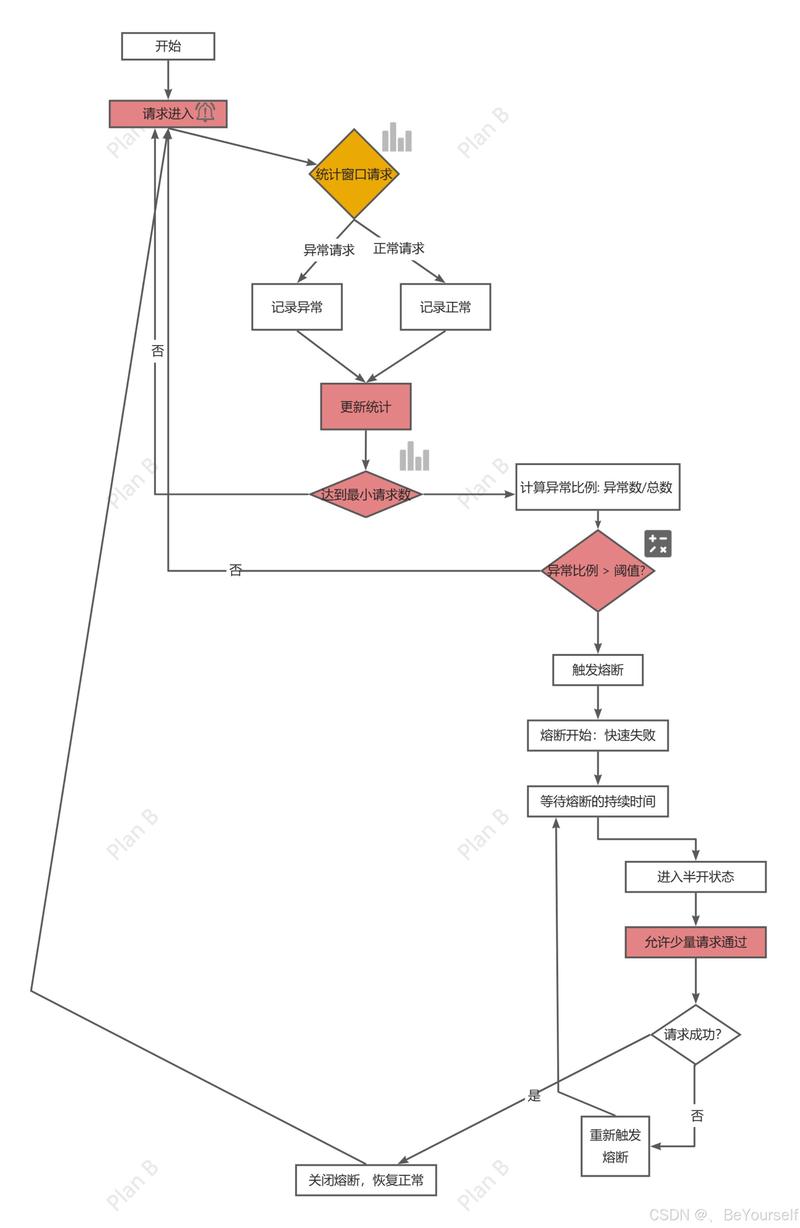 微服务抗风险技术设计熔断降级与故障隔离链路图
还有个词,叫爆炸半径。我特别喜欢。做抗风险技术设计,别老想着“系统不能挂”,先想“挂了能影响多大”。舱壁隔离、限流、熔断、单元化,本质上都在切爆炸半径。一个推荐服务挂了,别把整个首页拖死。一个租户被打爆,别让其他租户跟着遭殃。这话说起来简单,做起来全是细节:线程池隔离还是信号量隔离?超时设多少?重试几次?重试会不会把下游打得更惨?
对了,重试这事得单独吐槽。很多故障不是第一波打垮的,是重试风暴。下游已经喘不过气了,上游还在拼命重试。那感觉,像什么?像电梯超载了,后面的人还拼命往里挤。所以抗风险技术设计里,重试必须有退避、有上限、有熔断配合。不然就是好心办坏事。
混沌工程别搞成表演赛
混沌工程这两年很火。火到什么程度?有些团队一上来就搞“随机杀Pod”,杀完发个新闻稿,说我们做了韧性演练。说实话,这跟健身房里只拍照不练动作差不多。
真正的故障注入,得从科研成果里借点严谨性。实验假设是什么?稳态指标是什么?爆炸半径怎么控制?中止条件是什么?实验结束后的改进项谁跟进?没有假设和度量的混沌实验,就是捣乱。
我比较认同一套做法:先在预发环境跑小流量,再在生产环境选低峰期、小比例用户;实验前盯紧SLO误差预算,实验中自动中止,实验后把故障场景沉淀成回归用例。别嫌麻烦。抗风险技术设计本来就是麻烦事。你不在这里麻烦,故障就会在凌晨两点麻烦你。
行业里还有个动向挺有意思:形式化验证开始从论文走进关键系统。不是所有业务都需要,但支付、账务、分布式锁这类地方,用TLA+或者轻量级模型检查,提前把并发场景里的坑挖出来,比线上修Bug便宜太多。科研价值也在这:把“我觉得应该没问题”变成“我在模型里验证过没发现问题”。
降级和可观测性,才是真救命
我有个偏见:看一个团队抗风险技术设计做得好不好,别只看架构图,看两样东西——降级开关和监控面板。
降级开关不是摆设。它得有明确的触发条件、影响范围、回滚路径,还得有人敢按。很多团队开关做了一堆,真出事没人敢动。为什么?因为不知道按下去会怎样。这就回到可观测性。没有可观测性的降级,等于蒙眼拆炸弹。
可观测性也别只堆Dashboard。指标、日志、链路追踪,得能回答三个问题:现在坏在哪?影响谁?下一步动作是什么?我见过面板做得像飞机驾驶舱,真出事还是靠人肉猜。问题不在工具,在指标没跟业务结果对齐。SLO、错误预算、关键路径成功率,这些比CPU使用率更能救命。
最后说个科研和工程的结合点:抗风险技术设计正在从“静态冗余”走向“动态韧性”。静态冗余是备机、备库、多活;动态韧性是系统能感知环境变化,自动调整流量、降级非核心、隔离故障域。学术上叫自适应系统,工程上叫自愈。听着玄,其实已经有落地:比如根据错误率自动切流,根据延迟自动缩小批处理,根据容量预测提前扩容。
但别神化自动化。自动化决策也需要边界和人工兜底。半夜系统自动切流失败了,总得有人能接管。对吧?
写到这,回头看开头那句“机房又抖了”。抗风险技术设计的终点,不是让系统永远不抖,而是抖的时候,业务还能体面地活着。这话有点糙,但理不糙。