人机协同研发:别把AI当超级博士后,先搞定评价闭环
上周跟一个做新材料的团队吃饭。他们吐槽,算力买了不少,模型也训了,结果实验排队排到三个月后。
你看,这就是人机协同研发最尴尬的地方——算法跑得飞快,实验台还在原地踏步。中间那段路,没人修。
先别把AI当“超级博士后”
现在一聊科研AI,很多人脑子里就是:给个大模型,读文献、提假设、设计实验、写论文,一条龙。真挺诱人。可你到实验室蹲两天就明白,科研里最值钱的东西,往往不是“知道答案”,而是“知道该问什么”。
AI擅长的,是在高维空间里找模式。比如AlphaFold把蛋白质结构预测往前推了一大截,GNoME这种工作能在候选材料里做大规模筛选,A-Lab那套机器人平台也能在有限条件下连续跑实验。这些成果很硬。但它们背后都有人——有人定目标,有人洗数据,有人判断哪个结果值得追。
换句话说,人机协同研发不是让AI替科学家拍板,而是把“穷举、筛选、记录、复盘”这些脏活累活分给机器,把人留给判断和提问。这事儿听着不酷。但它管用。
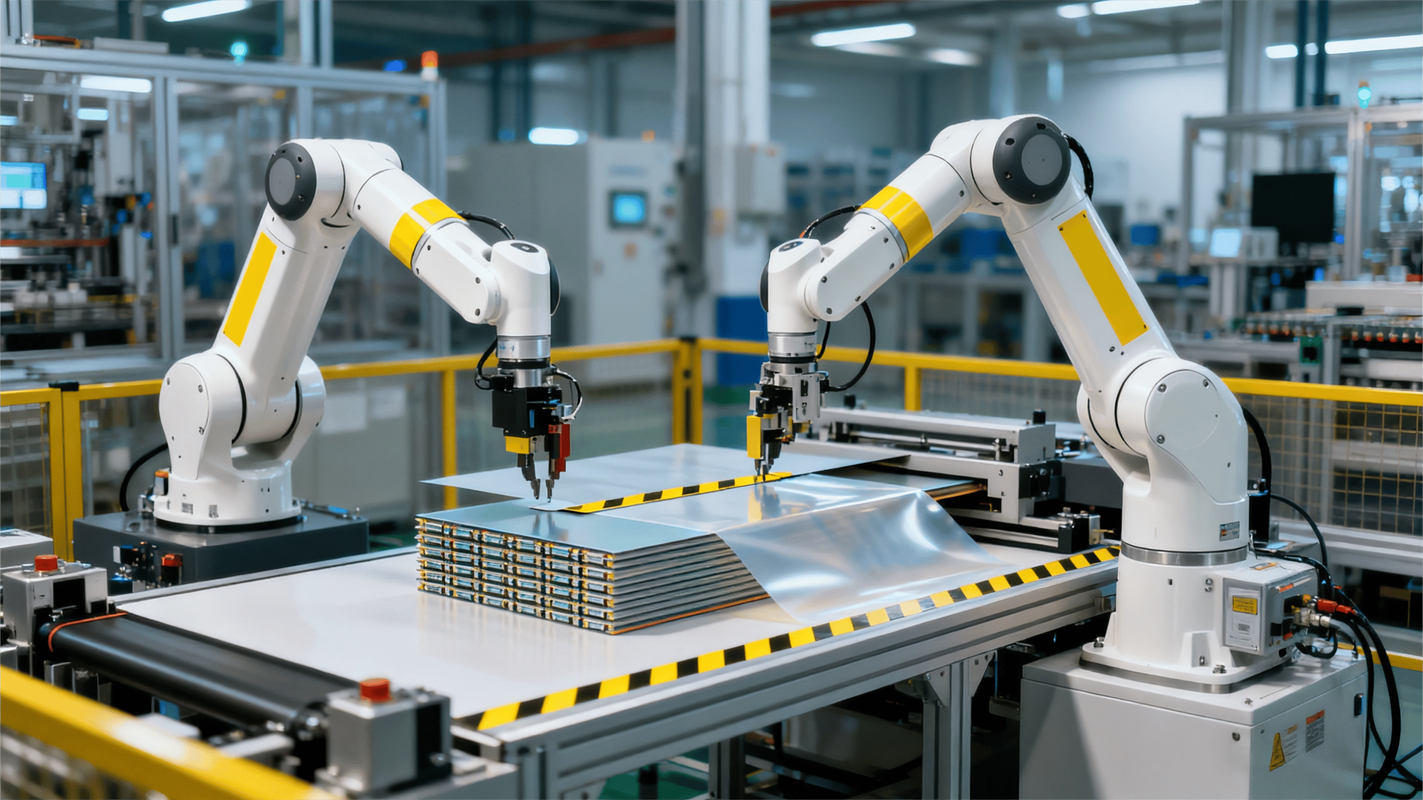 人机协同研发材料实验室机器人自动合成平台实景
真正难的是“评价函数”
我见过不少AI for Science项目,模型指标刷得漂亮,一上实验就露馅。为什么?因为科研没有像下棋那样的胜负判定。你让模型生成100个候选分子,它说这100个都有希望。然后呢?谁来判断先做哪个?
这就是人机协同研发里最容易被低估的一环:评价体系。说得直白点,没有可计算、可实验验证的评价函数,AI生成再多候选,也只是在给实验员增加工作量。
材料研发里,可以用形成能、带隙、稳定性做代理指标;药物发现里,可以用活性、选择性、毒性预测做初筛。但这些指标跟真实实验之间,永远有偏差。你得有人盯着偏差,得用主动学习、贝叶斯优化这类方法,把实验反馈再喂回去。闭环一旦跑起来,机器才不是“一次性生成器”,而是能跟着实验数据调整策略的协作者。
不过话说回来,闭环不是画个流程图就完了。实验记录得标准化,负样本得留下来,失败数据不能随手扔。很多团队嘴上说数据重要,硬盘里全是命名混乱的Excel。这个坑,真挺要命。
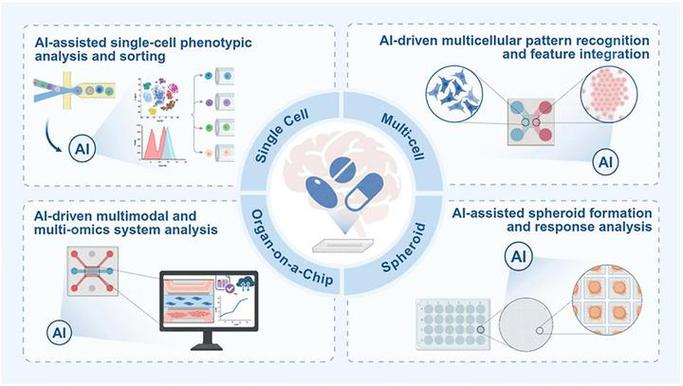 AI辅助药物分子筛选与人机交互反馈闭环界面示意图
从“人指挥机器”到“人机互相找茬”
早期的自动化实验平台,基本是人写好脚本,机器照着跑。现在往前一步,是机器人平台加AI调度:AI根据上一轮结果,决定下一轮做哪个配方、哪个温度、哪个浓度。人不再盯着每一步,而是盯整体方向和异常。
这听起来像“自动驾驶实验室”,对吧?但别急着吹全自动。真实研发里,异常值往往最值钱。一个看起来失败的实验,可能藏着新现象。机器按目标函数跑,容易把“意外”当噪声过滤掉。所以人机协同研发的关键设计,是让人能随时介入,给机器“踩刹车”,也给意外留入口。
我比较看好的一种模式是“互相找茬”:人提出假设,AI找反例、查文献、设计验证实验;实验跑完,人复盘,AI再更新模型。两边都不装权威。科学家别把AI当算命先生,AI也别把科学家当标注工。
组织上的坑,比模型里的坑还深
说个扎心的事实:很多AI科研项目不是死在算法上,是死在协作上。算法团队在云端调参,实验团队在另一栋楼排队,数据在第三个硬盘里躺着。大家开会都点头,回去各干各的。最后模型很漂亮,实验复现不了。
人机协同研发要落地,得把三件事打通:数据、实验、评价。数据要能让模型读得懂,实验要能让机器接得上,评价要能让两边都认。听起来像废话,做起来全是细节。比如实验记录里“少量”“适当”“加热至澄清”这种词,机器怎么处理?得有人把它变成结构化参数。再比如大模型写文献综述,幻觉一出来,年轻学生真敢信。得有审核机制。
行业里现在有个好苗头:越来越多团队把机器人平台、主动学习、领域知识图谱放在一个闭环里跑,不再追求“一个大模型解决所有问题”。这是好事。科研本来就不是端到端一键生成。
所以我现在看一个人机协同研发项目,先问三件事:数据能不能闭环?评价能不能落地?人愿不愿意改习惯?这三个问题答不上来,模型参数再大也白搭。