动态优化调整:科研闭环里最容易被做偏的那一步
先泼盆冷水。很多团队嘴里的“动态优化调整”,说白了就是每周重跑一次模型。数据变了,参数跟着变。听着挺动态,对吧?可科研里的动态优化调整,根本不是调参玄学。它是让上一轮实验的结果,反过来改变下一轮实验怎么做。这一步做偏了,后面全是白忙活。
我见过一些材料研发项目,静态实验设计一铺就是几十组。配方、温度、时间,全按表走。结果呢?一半样本落在没信息量的区域。钱花了,周期拖了,最后还得回头补实验。真让人懊恼。
别把动态优化调整做成“定期重跑模型”
动态优化调整的核心,是决策闭环。不是模型本身多花哨。你想,科研实验有噪声,有批次效应,有反馈延迟。今天做出来的样品,下周才出表征结果。这时候还按固定节奏更新,常常慢半拍。
更靠谱的做法,是把问题拆成几层:决策变量是什么,目标函数怎么定义,约束条件会不会变。比如催化材料研发,活性要高,选择性要好,稳定性不能差,成本还得压住。多目标。互相打架。你不能只盯着一个指标猛冲。
这时候,动态优化调整的价值就出来了。代理模型先给一个粗略地图。采集函数决定下一轮去哪儿做实验。探索和利用要平衡。说白了,别总在已知好区域里打转,也别瞎撒网。每轮数据回来,搜索空间要收,先验要改,约束要更新。慢着。这不是自动调参。这是在调实验决策。
 材料实验室自驱动实验平台动态优化调整闭环流程图
行业里现在很热的一个方向,是自驱动实验室。高通量平台加机器人加在线表征。论文里看着很顺。落地时一堆坑。样品制备的漂移、仪器校准的漂移、数据口径的漂移。你不做漂移检测,动态优化调整就会追着噪声跑。越调越偏。真的。
科研成果里,动态优化调整真正值钱的地方
 科研成果里,动态优化调整真正值钱的地方
科研成果最怕什么?怕只在论文里“最优”。换个批次,换个设备,性能掉一半。动态优化调整要解决的,是在不确定环境里持续做对下一步。这句话不玄。它对应的是鲁棒性、可迁移性和在线评估。
拿材料基因工程来说,多保真优化这两年很常见。低成本的仿真先筛一轮,高成本实验再验证。动态优化调整要决定:什么时候信仿真,什么时候必须上实验。预算有限。实验名额有限。采集函数不能只看预测均值,还得看不确定性。否则模型越自信,坑越大。
生物制造和合成生物学也一样。菌株改造、培养基优化、发酵工艺窗口。变量多,耦合强。静态设计很难覆盖。动态优化调整可以根据每轮滴度、副产物、生长曲线,动态收窄候选空间。这里的关键不是“算法先进”,而是反馈信号要干净,评估指标要稳定。指标老变,优化器就疯了。
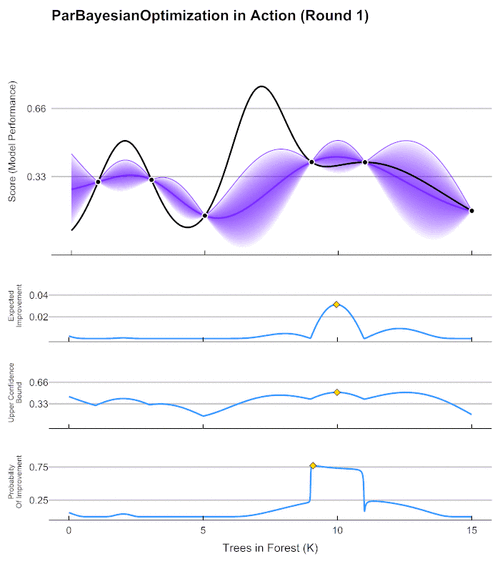 贝叶斯优化采集函数动态调整材料配方科研示意图
还有一个容易被忽略的点:约束会变。今天成本约束是A,明天供应链一波动,约束就变了。动态优化调整如果只优化目标,不管约束更新,最后给出的方案可能根本没法生产。科研和产业之间,常常就差这一口气。
行业动态很热,但落地卡在哪
 行业动态很热,但落地卡在哪
现在的行业动态,AI for Science、数字孪生、自动实验平台,一个比一个热闹。可真正跑通的团队,往往不是算法最强的。是数据治理最扎实的。听着不性感。但很真实。
第一道坎,是反馈延迟。实验不是点按钮就出结果。异步并行的时候,多轮实验同时在跑。动态优化调整要处理“旧数据还没回来,新决策已经发出”的问题。异步贝叶斯优化、批量采集、多保真调度,都是为此服务的。别拿单线程思路套并行实验。会乱。
第二道坎,是评估。离线指标好看,不等于在线决策好。你得看累计 regret、实验命中率、约束违反率、复现率。还要做决策审计。每轮为什么选这个点?是探索,还是利用?说不清,就不可复现。不可复现,科研价值就打折。
第三道坎,是组织。算法团队说模型准。实验团队说样品不稳。产线说窗口太窄。大家都在自己的局部最优里。动态优化调整要跨过这些墙。很难。但绕不过去。
 工业数字孪生产线动态优化调整控制界面图
工业侧也有类似逻辑。产线参数不是一成不变的。原料批次、环境温湿度、设备磨损,都会让最优工作点漂移。数字孪生加在线学习,能做动态优化调整。可前提是传感器数据可信,模型可解释,调整动作有安全边界。否则就是拿产线做冒险实验。谁敢?
我的建议很土:先把反馈闭环跑通,再谈智能。先定义清楚决策变量、目标、约束和评估窗口。再小步做动态更新。每轮只改一点。保留回滚。记录决策日志。别一上来就搞大而全的自治系统。容易翻车。
动态优化调整不是万能钥匙。它更像一个持续纠偏的手艺。数据脏了,要停下来洗。指标漂了,要重新校准。约束变了,要重写问题。科研没有一劳永逸的最优解。只有一轮一轮逼近。说实话,这挺烦的。但也正是它值钱的地方。