专家经验数字化:把老法师的‘手感’变成科研生产力
实验室里最贵的东西,往往不是那台千万级质谱仪。是老王退休前那句‘这个烧结曲线不对劲,停’。项目组没人接得住。三个月后复现失败,才想起来找他。电话打过去,老王说,当时炉膛声音发闷……你看,这就是专家经验数字化最扎心的地方:经验在,系统不在;人一走,判断就断。
先泼盆冷水。很多单位做专家经验数字化,第一步就走歪了——把专家当采访对象。录音、录像、做SOP,最后攒了一堆‘要注意温度’‘要关注杂质’的正确废话。真到实验台上,模型不敢用,新人也不会用。为啥?因为专家经验不是一段话,是一串条件反射,是边界感,是对异常的第一眼警觉。你只录了结论,没录触发条件,等于只抄了答案。
一、把‘手感’拆成决策点,别拆成口号
我见过一个材料实验室的做法,挺土,但管用。他们不急着上大模型,先让老专家带着两个年轻人做‘决策点标注’。啥意思?每做一轮配方,专家在关键节点按下标记:为什么加这0.5%的助剂?为什么这次保温多20分钟?看到哪条曲线抖动决定中止?这些标记跟实验记录、设备日志、甚至失败样品照片绑在一起。三个月,攒了八百多个决策点。脏活。真的脏。可这才是可计算的专家经验。
这里有个反常识:失败实验比成功实验更值钱。科研里阳性结果常被好好记录,阴性结果经常一句‘没做出来’就扔了。专家经验数字化最缺负样本。模型要知道‘什么不能干’,靠的不是成功案例堆砌,而是边界条件。比如化工放大,专家会说‘黏度到这个坎儿就别再加料’,这个坎儿不写进系统,大模型再能说也白搭。
 材料实验室专家经验数字化决策点标注界面
知识表示也别一上来搞花活。本体、规则、案例库、因果图,四件套够用。本体管概念关系,规则管硬约束,案例库管相似检索,因果图管‘改了A会不会影响B’。专家嘴里的‘手感’,拆开看,很多是条件规则加相似案例匹配。剩下那点说不清的直觉,留给专家在环。别硬编。
二、大模型不是万能药,先给它一副骨架
大模型火了以后,很多科研项目组第一反应是:把论文、实验记录、专家访谈全塞进去,问它‘下一步怎么做’。结果呢?回答漂亮,落不了地。科研容错低,一个参数幻觉可能烧掉几十万。大模型擅长语言组织,不擅长替你守安全边界。它得有个骨架:检索增强生成管知识召回,知识图谱管关系约束,贝叶斯网络或因果模型管不确定性。三者一咬合,才像那么回事。
说个行业动态。近两年AI for Science很热,自动化实验平台、机器人工作站、科研知识管理都在往‘专家在环’上靠。方向没错。但专家经验数字化不是把专家踢出去,是把专家的判断变成可追溯、可复用、可审计的资产。专家还得在关键节点拍板,模型负责缩小搜索空间、提示风险、记录理由。人机协同,不是人机互怼。
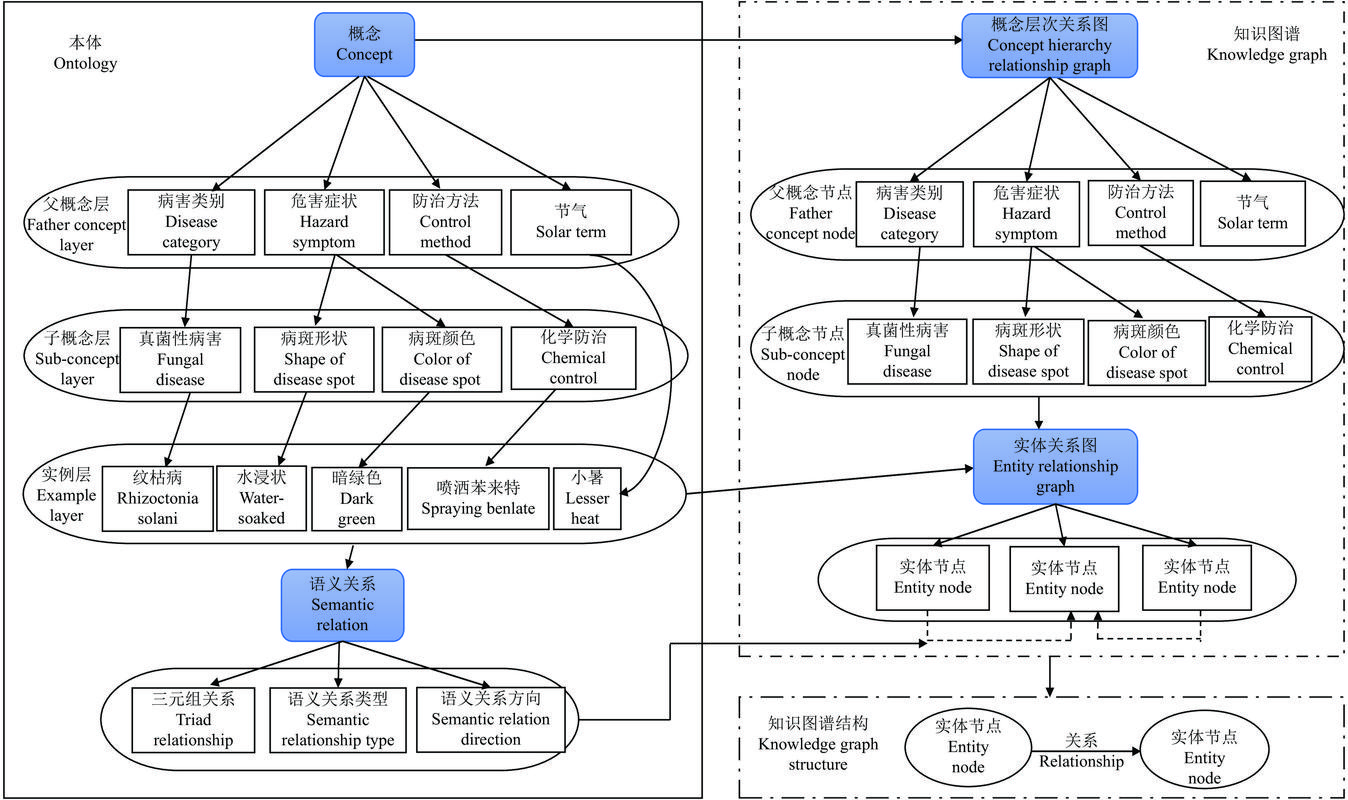 科研知识图谱专家经验数字化本体结构图
还有一个坑:别只看准确率。科研场景里,风险漏报率和专家采纳率更关键。模型说对了九次,第十次把危险工况判成正常,项目就废了。所以要做置信度校准,低置信度自动转人工。主动学习也好用:让模型挑它最不确定的样本请专家标,标注成本能砍一大截。这比无脑堆数据聪明多了。
三、一条能跑的流水线:从‘手感’到‘可计算’
落地别贪大。先选一个高频、高价值、边界清楚的子任务。比如‘烧结异常判断’‘色谱峰异常识别’‘故障排查第一步’。任务拆解到决策点,采集日志和失败样本,建小规模知识库,再上检索增强生成和规则引擎做原型。专家在环验证,每周复盘。跑通了,再扩场景。别一上来搞全实验室大脑——那玩意儿听着唬人,维护起来要命。
评估要诚实。拿历史案例做回放,看模型建议跟专家判断差在哪;做前瞻小规模试用,记录采纳和拒绝理由;把知识库版本、模型版本、专家签字都留痕。可追溯,才有信任。数字孪生可以上,但先把数据底座打牢。底座不稳,孪生就是动画片。
 自动化实验室专家在环主动学习流程图
四、坑与边界:别把数字化做成‘替代专家’
最后说点不好听的。专家经验会漂移。设备换了、原料批次变了、科研目标变了,老规则可能过期。知识库要有退休机制,定期让专家复核。还有责任边界:模型给的是建议,签字的还得是人。数据隐私、知识产权、实验安全,这些不能靠一句‘AI自动学习’糊弄过去。说实话,专家经验数字化最难的从来不是算法,是让专家愿意讲、让团队愿意记、让系统愿意认错。
我的建议很土:先从小场景啃。找一个老专家,配一个懂数据的年轻人,再配一个肯做脏活的工程同学。三周做一个能跑的原型,别写一百页方案。跑不通就改。真的,别一上来就搞全实验室大脑。先让系统学会老王那句‘停’。这就够值钱了。