当图表开始说谎:数据可视化技术的可信度工程
一张图的可信度,常死在口径上
把一张图当作结论,是数据可视化技术常见的误用。图能压缩信息,也会压缩前提。缺失值怎么补、分母是谁、时间窗多长、聚合到什么粒度——这些口径在绘图前就决定了读者能看见什么。
问题不在图表。口径先塌了。
我见过同一组销售数据,按周聚合呈稳步上升,按日聚合却出现多次断崖。原因不是渲染,而是退货入账延迟。若图中不标注数据血缘与更新时间,读者会把会计节奏误读为市场趋势。这类错误很难靠审美修复。
 城市交通流数据可视化监控大屏界面
更隐蔽的是分母漂移。用总用户数做分母,活跃率会被沉默账户稀释;用活跃用户做分母,功能渗透率又会被口径放大。两种图都“对”,结论却相反。怎么办?把分母写在图内,把过滤条件写在图注,把缺失比例放进同一视觉层级。否则,读者只能替系统补前提。
视觉编码不是装饰,它决定读者能看见什么
数据可视化技术的核心不是选颜色,而是把数据字段映射到位置、长度、面积、色相、亮度、纹理等通道。人眼对位置和长度的判断较稳定,对面积和色相的顺序判断更易失准。于是,饼图在类别多时不可靠;三维饼图更糟,透视会扭曲面积。
这不是说某类图不能用。条件很重要。类别少、差异大、只需粗略比例时,饼图可以工作。类别超过七八个,或者需要精确比较,条形图更稳。色相编码也一样:连续变量用亮度或感知均匀色带,类别变量用色相时需考虑色盲,并叠加形状或直接标注。
视觉编码的选择应被当作假设检验,而不是风格偏好。 比如双轴折线图,量纲不同却共享画布,容易暗示并不存在的相关。若必须使用,应明确两条轴的独立刻度,并避免用同一颜色暗示因果。截断纵轴也会放大波动;在金融和舆情场景中,这种放大常被误读为风险突变。
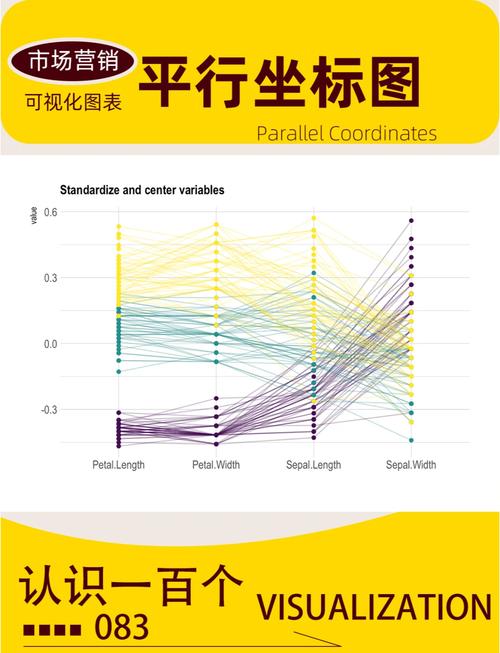 数据可视化技术平行坐标图交互筛选界面
图形语法把这种选择形式化:数据、映射、标度、几何对象、分面、坐标系统。好处是可复现。坏处是规格写错时,错误也会被批量复制。一个错误的聚合层级,会在所有分面图里同步出现。
交互与规模:性能瓶颈会伪装成设计问题
 交互与规模:性能瓶颈会伪装成设计问题
交互是数据可视化技术区别于静态图表的要害。筛选、缩放、刷选、细节按需,让读者从总览进入局部。但交互不是越多越好。延迟超过约一百毫秒,探索会变成等待;超过一秒,用户会改变策略,甚至放弃。此时界面看起来“设计不佳”,根因常在查询与渲染链路。
百万级散点图是典型反例。直接绘制会造成过绘制,密度被误读为结构。分箱、密度热力、采样能缓解,但分箱会掩盖离群点,采样会漏掉稀有事件。较稳妥的做法是多尺度表达:总览用密度,局部切换原始点,并明确当前视图的采样率。WebGL、GPU聚合、增量查询能提升吞吐,但会引入精度与一致性问题。性能优化不能悄悄改变统计口径。
交互还会改变推理路径。刷选一个区域后,用户容易把局部模式当成总体规律。系统需要保留总览参照,或者提供回退轨迹。否则,探索越深,偏差越隐蔽。
标注、叙事与可访问性:别让读者替系统补前提
图表的标题、单位、基线、注释,属于可视化规格的一部分,不是排版附属。省略单位会制造量级误读;省略基线会让截断轴看起来像自然起点;省略样本量会让小样本波动被当作趋势。自动叙事生成需要谨慎,它擅长把图翻译成句子,却不擅长声明句子的适用条件。
可访问性也常被忽略。颜色不是唯一通道。对色觉障碍用户,纯色相区分会失效;对屏幕阅读器,画布需要替代文本与数据表。把可访问性留到发布前补,通常只能补出形式合规,补不出可读性。
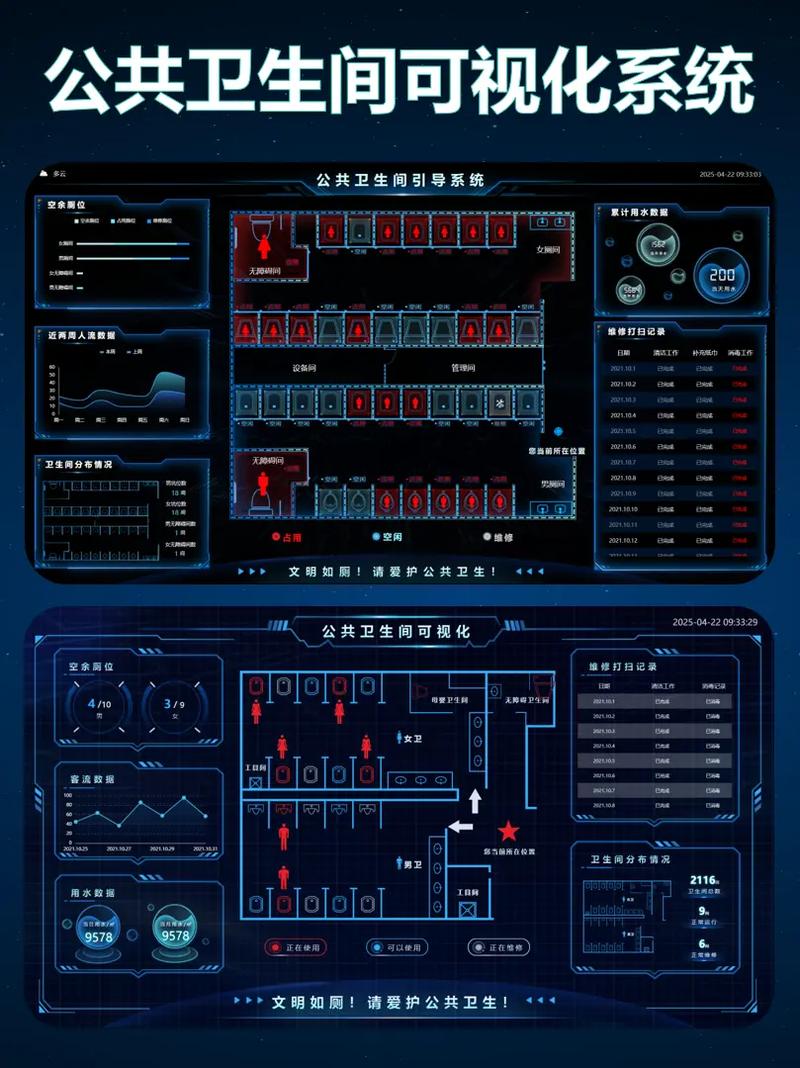 公共卫生统计数据可视化看板交互标注界面
叙事层还有一个风险:动画与过渡会制造因果错觉。两个变量依次变化,并不等于一个导致另一个。动画适合表达状态转移,不适合暗示机制。若没有时间戳与事件标注,动图只是视觉糖。
验证与边界:把图当作可审计的推理装置
评估数据可视化技术,不能只看“好不好看”。可测的指标包括任务完成时间、错误率、洞察记录、回看次数、协作中的引用频率。更关键的是可审计性:图的数据版本、变换步骤、过滤条件、编码映射能否复现。没有这些,图只是截图。
高风险决策场景需要保留反例与不确定性。置信区间、样本量、缺失比例、异常点标记,应与主图同等可见。否则,平滑的曲线会制造虚假的确定性。可视化不能替代统计推断,它能做的是把推断的前提摊开。
趋势上,自然语言查询与自动图表推荐会降低门槛,也会放大口径错误。系统若只优化“生成一张图”,而不暴露数据变换,风险会转移给读者。较有价值的方向是声明式可视化规格与可测试的数据变换,让图成为可版本化、可回归测试的产物。
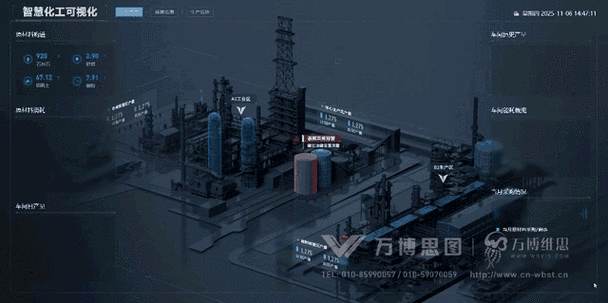 医学影像三维体数据可视化工作站着色界面
边界也要说清。探索性分析需要快速、粗糙、可丢弃的图;对外发布需要可复现、可解释、可追责的图。两者不能用同一套验收标准。把探索图直接搬上决策页,是常见事故。
图会说话,但常常说错。数据可视化技术的专业性,不在于画得多,而在于让读者知道这张图在什么条件下成立。