场景构建方法:别急着堆设备,先把变量摁住
先说实话:大多数场景构建项目死得很难看。不是技术不行,是一开始就把场景当成了PPT里的背景图。
我见过一个机器人抓取课题,实验室买了机械臂、相机、传送带,场景搭得挺像工厂。结果论文复现时,换了个光照,抓取成功率从87%掉到31%。问题出在哪?场景构建方法里最要命的一步被跳过了:变量分层。他们只搭了“看起来像”的场景,没定义哪些变量该控、哪些该随机、哪些必须记录。
先把场景拆成可测的零件,别急着上引擎
场景构建方法不是3D建模教程。建模只是外壳。科研场景的核心是对象、关系、事件、约束、评价这五件套。对象是场景里有什么,关系是谁挨着谁、谁挡着谁,事件是什么时候发生什么,约束是物理规则和实验边界,评价是你到底拿什么指标说话。
拿自动驾驶仿真举例。行业里现在流行参数化场景库,不是手工摆几辆车就完事。一个Cut-in场景,得说清楚:主车速度区间、目标车切入距离、相对加速度、路面附着系数、传感器噪声模型、天气光照参数。少一个,场景就不可复现。论文里写“构建了复杂交通场景”,审稿人心里会翻白眼。
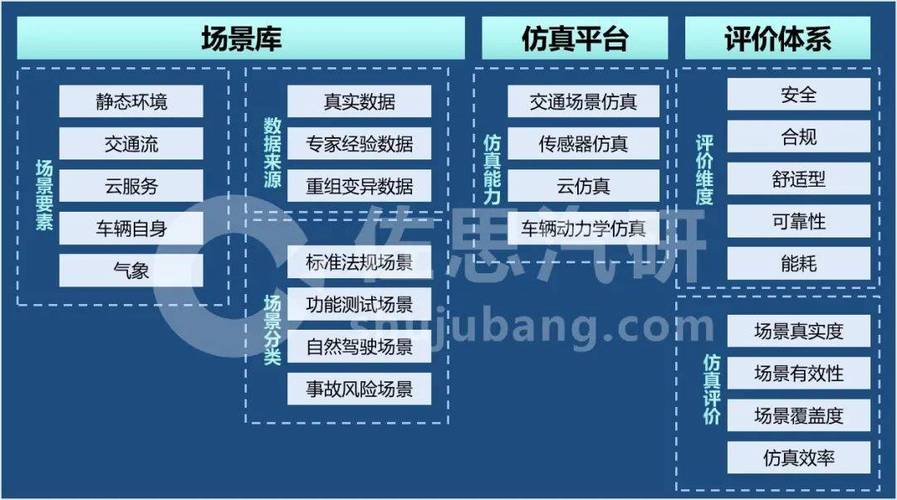 自动驾驶仿真场景构建方法参数化场景库图
再说变量分层。我习惯把变量分成三层:可控变量、噪声变量、不可控变量。可控变量是实验者主动调的,比如物体材质、相机帧率、任务难度。噪声变量是必须记录但不能完全控制的,比如环境光波动、传感器温漂。不可控变量是现实里躲不开的,比如被试情绪、网络延迟。场景构建方法的关键动作,是给每一层变量建表,标好取值范围和随机种子。
听起来笨?对。但科研最怕聪明人拍脑袋。一个场景卡写清楚参数,比十页漂亮渲染图有用。
数据不够?合成场景不是魔法,是配方
这两年生成式AI和具身智能把场景构建方法推到了台前。合成数据很热,热到有些团队以为拍几张照片、跑个扩散模型就能喂模型。别闹。合成场景的价值不在“多”,在“可标注、可控制、可回溯”。
我们做过一个抓取实验的场景构建:真实采集只覆盖了12种物体,长尾样本少得可怜。后来用仿真引擎做参数化变体,把材质、摩擦系数、堆叠方式、光照方向拆开组合,生成了几千个场景。重点来了——每个场景必须带参数日志,否则你根本不知道模型学到的是形状还是光照。合成数据不是替代真实,是给真实数据补盲区。
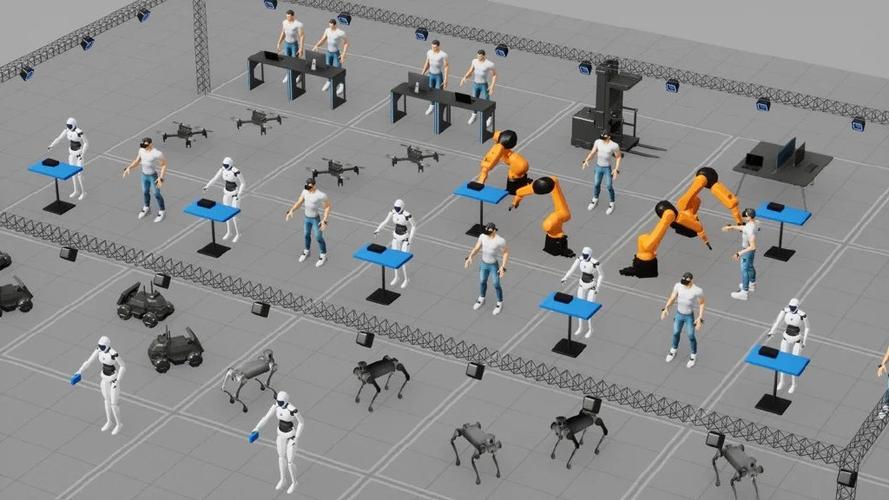 具身智能机器人抓取实验场景构建布局图
行业动态也印证这点。自动驾驶公司建场景库,拼的是长尾覆盖率和场景复用率;具身智能团队建训练场,拼的是物理一致性和交互脚本;数字孪生实验室拼的是虚实校准。场景构建方法正在从“手工搭景”变成“场景工程”。不过话说回来,工具越花哨,越容易掩盖实验设计的懒。仿真引擎再强,也救不了一个没定义的评价指标。
验证闭环:场景有没有用,跑三组对照再说
 验证闭环:场景有没有用,跑三组对照再说
场景搭完不算完。你得验证这个场景真的能区分方法好坏。怎么验?我一般看三件事:对照实验、消融实验、场景覆盖率。对照实验看基线差异,消融实验看哪个变量在起作用,覆盖率看你的场景库是不是只覆盖了容易样本。
有个坑得提醒:别用测试场景去调训练场景。听起来像废话,实际项目里天天发生。场景构建方法里要留一个“冻结集”,谁都不能碰。随机种子、设备日志、标注版本,全给我锁死。不然复现时又是一地鸡毛。
还有评价指标。场景构建方法必须跟指标一起设计。你做VR心理学实验,场景里的光照、纹理、声音、交互延迟都会影响被试反应。只写“构建了沉浸式场景”没用,得写清楚沉浸感量表、任务完成时间、生理信号采样率。科研不是 demo,场景得能回答问题。
团队协作里,场景文档得像代码一样活着
最后聊点脏活。场景构建方法落地时,最容易被低估的是文档。场景卡、参数表、随机种子、设备配置、版本号,一个都不能少。我见过团队用共享表格管场景,三个月后没人知道哪一版是论文里那版。崩溃。
比较靠谱的做法:场景库 Git 化。每个场景一个文件夹,里面放配置文件、脚本、采样数据、变更记录。场景构建方法不是一个人的手艺,是团队资产。行业里做自动驾驶场景库的团队,早就在用版本管理、场景血缘、自动回归测试。科研团队也可以抄作业,别嫌麻烦。
场景构建方法这活儿,说到底是把混乱的现实切成可管理的碎片,再一块块拼回去。拼得丑没关系,能复现、能测量、能迭代,才算数。下次有人跟你说“我们把场景搭好了”,你就问他一句:变量表呢?随机种子呢?评价指标呢?他要是愣住,你心里就有数了。