机房被水淹了,订单为什么没丢?聊聊韧性技术系统的降级美学
韧性技术系统不是“不出事”,是“出了事还能体面”
很多人把韧性技术系统跟高可用混着说。说实话,两件事挨着,但不是一回事。高可用更像“尽量别断”,韧性更像“断了以后怎么不烂成一锅粥”。机房进水、光缆被挖断、云厂商某个可用区抽风、大促流量翻五倍——这些事你很难靠祈祷避开。韧性技术系统干的事,是让系统在冲击里吸收一部分、限制一部分、放弃一部分、再恢复一部分。
我拿南京城墙打个比方。它不是一堵孤零零的墙。有瓮城,把冲进来的东西先关一道;有排水,雨大了能导走;有马道,守军能快速调动。韧性技术系统也像这样:不是堆一堆服务器就完事,而是要有“瓮城”把故障关起来,有“排水”把流量导走,有“马道”让值班的人能快速切过去。
 南京明城墙瓮城排水系统实景
所以它重要在哪?重要在故障不是均匀发生的。平时推荐服务挂了,用户顶多觉得“猜你喜欢”不准;支付回调挂了,订单就卡在半空。韧性技术系统要回答的是:哪些功能必须保,哪些可以暂时关,故障会不会从一个小接口串到整个交易链路。这个问题,比“买几台高配机器”难多了。
故障来的时候,先别让它串门
我们那次处理得很土:先把非核心入口关掉。推荐、积分、排行榜、弹窗广告,全降级。支付、库存扣减、订单落库保留。用户还能下单,只是页面没那么花哨。有人会问,这不就是阉割功能吗?对,降级不是丢人,是拿体验换核心链路活着。你总得让用户把单下了,对吧。
技术上有几个动作很关键。限流,就是给入口装个水龙头,别让洪水直接灌进数据库。熔断,是发现某个下游一直超时,就先别再喊它,免得把调用方线程全拖死。舱壁隔离,是把不同业务放进不同“水密舱”,一个舱进水,别让整条船沉。还有重试——这玩意儿最容易好心办坏事。下游已经喘不过气了,上游还拼命重试,最后就是重试风暴。我们吃过亏:一个库存接口超时,订单服务重试三次,三个实例一起重试,库存服务直接被打挂。后来加了退避、抖动、最大重试次数,才消停。
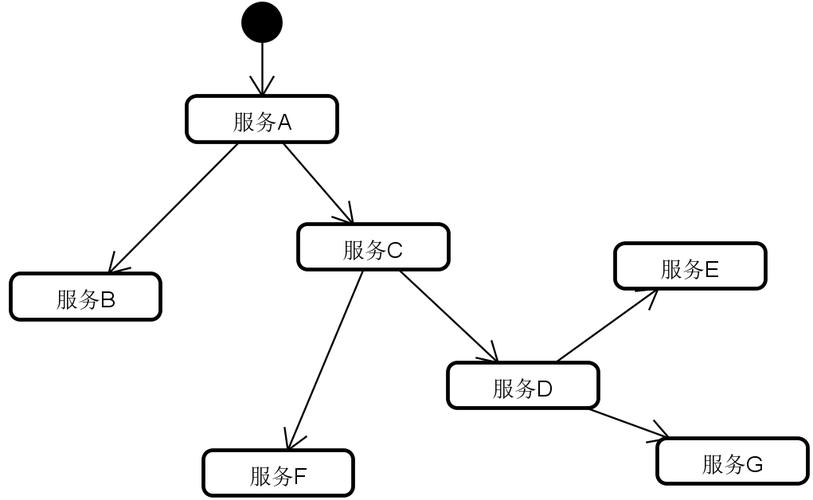 分布式系统服务熔断降级链路示意图
再往细里说,幂等得做好。幂等就是同一个请求来多次,结果只算一次。订单号去重、支付回调验重、消息消费带唯一键。不然降级切来切去,用户被重复扣款,那韧性就变成事故了。可观测性也别虚:日志、指标、链路追踪,得能让你在十分钟内知道“哪条链路在超时、哪个机房在抖、哪个版本刚发”。SLO 这东西听着像管理词,其实就是给系统定个“体面线”,错误预算烧太快,就别硬上新功能了。
备份不是韧性,能恢复才算
 备份不是韧性,能恢复才算
有个误区特别常见:多副本等于安全。真不一定。副本全在同一个机房,同一个电源,同一套网络,水一泡全泡。我们做演练时故意断过一个可用区,结果发现某个中间件的主备切换配置写错了,切过去起不来。平时看不出来,故障时就是大坑。
数据层要看两个很硬的指标:RPO,能丢多少数据;RTO,多久能恢复。备份成功不等于能恢复。备份文件损坏、恢复脚本过期、依赖的密钥找不到,这种事不演练根本发现不了。我见过一次恢复演练,数据库拉了四十分钟还没起来,业务方脸都绿了。后来我们把核心表拆小、冷热分离,准备只读降级页,至少让用户能查订单,不至于全黑。
组织层的韧性同样重要。值班表是不是真的有人?预案是不是只有一份 PPT?复盘是找根因还是找人背锅?韧性技术系统不是运维一个团队的事。业务得拍板哪些功能可以关,研发得把开关做在配置里,测试得定期拉闸演练。混沌工程也别神化,就是有护栏地制造小故障,看看系统怎么反应。别在高峰期搞,别一上来就拔核心库网线,那是鲁莽,不是勇敢。
它用在哪,以及别把它供起来
 它用在哪,以及别把它供起来
地铁闸机离线码、医院挂号缓存、支付限额、政务云灾备,背后都是同一套思路:核心保住,边缘让路,故障隔离,恢复有路。但韧性有边界。强一致账务场景不能随便降级,金融交易不能一句“先记着”就完事。冗余也不是越多越好,堆多了复杂度上去,故障定位更难,成本还高。降级更会伤体验,得业务点头,不能技术自己拍脑袋。
还有个常见误解:监控只看 CPU 和内存。真出事时,CPU 可能很闲,线程池却满了;机器活着,依赖的下游已经挂了。韧性技术系统像城市排水,平时看不见,暴雨那天决定体面。我们做工程的,别老想着永远不出故障。得想着故障来了,哪扇门先关,哪盏灯还亮。