看不见的错配:基因编辑脱靶检测的盲区与破局
CRISPR技术落地临床的最大绊脚石,从十年前到今天,从来都是它。
能精准剪断目标基因,却没人能打包票说,其它位置完全没动过。这些错剪的痕迹,藏在三十亿个碱基对里,找出来,难;找全了,更难。
为什么脱靶的坑,之前一直填不平
脱靶的本质很简单:向导RNA带着Cas酶找位点的时候,只要有一两个碱基对不上,Cas酶也有可能下手切割,或者编辑。要是错切在了抑癌基因上,一次编辑就可能直接诱发肿瘤,风险完全不可控。
早期的检测思路,全靠猜。根据gRNA的序列相似性,预测出十几个可能错配的位点,然后用PCR扩增完测序,只测这几个地方。问题是,人类基因组里有成千上万个相似度很高的序列,非编码区还有大量重复片段,猜得到第一个,猜不到第一千个。漏网的脱靶,就是埋在病人身体里的定时炸弹。
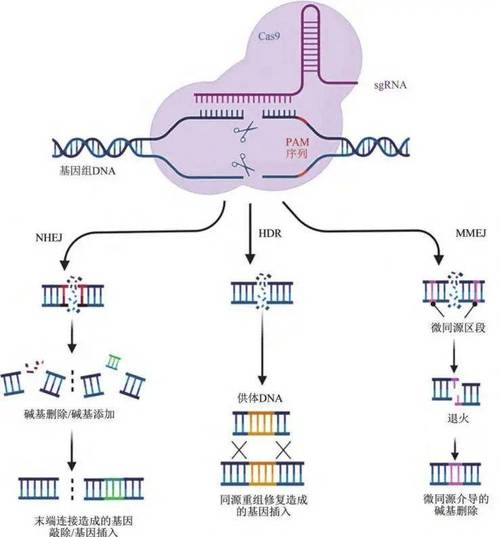 CRISPR基因编辑错配切割示意图
后来有人想到用全基因组测序,把编辑后的细胞整个基因组测一遍,和未编辑的对照比,找差异。这个思路听起来完美,实际操作起来满是坑。
正常细胞本身复制就会出错,每一次分裂都会带几个新突变,你拿到的差异位点里,哪些是编辑带来的脱靶,哪些是细胞自己长出来的背景突变?很难分清楚。而且,要是编辑后只有千分之一的细胞带这个脱靶,短读长测序的深度不够,信号直接就被背景噪音吞了,根本看不见。
低频率脱靶才是临床应用中最危险的那一类,偏偏早期方法抓不住它。这就是之前十多年,整个行业都卡在这儿的核心原因。
现在的主流方法,各有各的脾气
最近七八年,陆续出来了一批新的检测方法,各有各的适用场景,也各有各的解决不了的问题。
用的比较多的是GUIDE-seq,原理就是在Cas酶切割产生双链断裂后,把带生物素标记的短寡核苷酸序列插入到断裂位点,最后把带标记的片段抓出来测序,哪里有标记,哪里就是脱靶位点。这个方法比猜位点准多了,但是它的插入效率太低了,一百次断裂才能抓住十几次,低频率的脱靶还是抓不到,而且寡核苷酸只能转染容易培养的细胞系,临床用的原代细胞、干细胞根本转不进去,也就做不了临床样品的检测。
还有针对体外检测的CIRCLE-seq,把基因组提取出来打碎,让Cas酶在体外完成切割,然后把切出来的末端加接头测序,灵敏度比GUIDE-seq高不少。但是问题来了,体内的基因组是缠绕在组蛋白上的,很多预测的脱靶位点根本被包在染色质里面,Cas酶碰都碰不到,你体外切出来一堆脱靶,放到体内根本不会发生,等于虚惊一场,还耽误时间。
 不同脱靶检测方法灵敏度对比图
那针对不用切双链的编辑工具呢?现在大火的碱基编辑、引导编辑,大部分脱靶都是单碱基的替换,根本不产生双链断裂,你那些抓断裂位点的方法,完全没用。相当于拿着捕兽夹去抓蚊子,有劲使不上。前两年《自然》发过一篇研究,说两种常用的胞嘧啶碱基编辑,在小鼠体内会产生数百个额外的单碱基脱靶,这些脱靶之前用传统方法根本检测不到,直接引发了行业对碱基编辑安全性的大讨论。你看,工具迭代了,方法跟不上,照样出问题。
现在新出的一些方法,比如针对单碱基脱靶的直接捕获,或者结合DNA损伤标记的免疫沉淀测序,都在补这个缺口,但是还没有哪一种方法,能说自己通吃所有编辑工具,覆盖所有类型的脱靶。
临床落地前,还有几个绕不开的坎
 临床落地前,还有几个绕不开的坎
现在已经有几款基因编辑疗法获批上市,多是体外编辑:把病人的造血干细胞拿出来,编辑完筛选一遍,把没有脱靶的细胞扩增完再输回去,风险可控。但接下来要做的大量体内编辑疗法,直接把编辑工具打到病人体内,比如治疗视网膜病变、地中海贫血,你根本没办法提前筛选,脱靶检测必须一步到位,又准又便宜。
第一个坎,就是灵敏度和成本的平衡。要测到万分之一频率的脱靶,全基因组测序需要做到50X甚至100X的深度,一个样品的测序成本就要几万块,临床上不可能给每个病人都做这个检测,成本降不下来,就很难大规模推广。现在大家想到的办法是先用AI预测可能的脱靶位点,再针对性的做靶向测序,成本降了一大半,但是预测模型总有漏检,漏一个致癌位点就是大问题。
第二个坎,就是嵌合样品的分辨率不够。体内编辑后,只有少部分细胞被编辑,脱靶也只存在于这些少部分细胞中,混合测序的信号被大量未编辑的细胞稀释,很难区分哪些是真实脱靶,哪些是测序错误。现在单细胞测序的成本太高,还没法大规模用在这上面。
说实话,这一行的进展已经够快了,十年前连准确找十几个脱靶都难,现在已经能做到全基因组范围千分之一灵敏度的检测。但是技术就是这样,差一步,就是从实验室到手术室的距离。
不过话说回来,我们搞这行的,不就是填坑吗?把一个个盲区找出来,把一个个坎跨过去,哪天能拍着胸脯说,这个编辑的所有错配都找到了,基因编辑才能真正走进寻常百姓家,解决那些现在治不了的病。