量子机器学习:别吹"碾压传统AI",我在实验室蹲了半年看到的真相
上个月跟所里刚出站的博士后吃火锅,他拍着桌子吐槽,现在外面创投圈讲量子机器学习,张嘴就是“十年后替代所有AI算法”,听得他毛骨悚然。
我刚好半年前在量子计算中心蹲过一个联合项目,沾过量子机器学习的边,今天就说点书上PPT上不会写的真话。
别找百科定义,先搞懂量子到底给机器学习加了什么buff
很多人一听到这个词,第一反应就是“量子计算机+机器学习=超级AI”,不对。现在大家说的量子机器学习,核心逻辑很简单:传统机器学习处理问题,本质上就是在一个超级大的空间里找最优解——你可以理解成蒙着眼在一片起伏的山区找海拔最低的山谷,一次只能站在一个点摸周边的地形,慢慢挪。
量子的叠加态特性,相当于你一次能站满所有你要搜的点,同时感知所有点的高低,找到最低山谷的速度自然就快了。
当然,这是极简的类比,实际要复杂得多,要处理量子退相干,要做测量,还要修正误差,说出来全是头疼的问题。
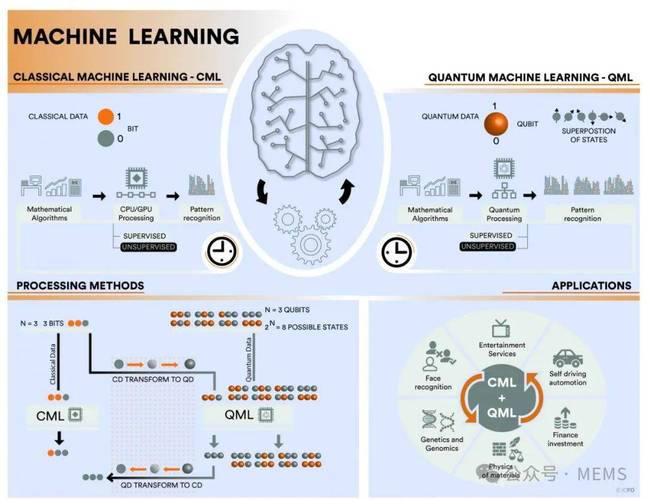 量子机器学习寻优过程传统对比示意图
另一个方向反过来,用传统机器学习来处理量子物理的实验数据,也能归到量子机器学习的范畴里,今天就不说这个了,就聊大家最关心的:用量子加速机器学习。
我参与过的两个落地尝试,离商用到底有多远
第一个项目是药物分子筛选,找能结合特定致癌靶点的小分子候选物。这个问题传统解法有多疼?每个小分子的量子态都要算,找结合能最低的构象,稍微复杂点的分子,传统超算跑一个就要几天,筛一百个候选就要几个月。
我们当时拉了三个学校的团队,折腾了三个多月,用云量子计算平台的127比特超导量子处理器测结果。筛小分子的速度确实比传统方法快了近四倍,可误差也比传统方法高出了十二个百分点。稍微超过50个原子的分子,量子比特就不够用了,根本装不下整个分子的量子态信息。
第二个项目是高维金融数据的异常特征筛选。传统机器学习筛1000维以上的风险特征,要挨个做相关性计算,跑一次大概半小时。我们用量子退火算法来做,三分多钟就出结果。但你猜怎么着?筛出来的特征,最终模型的准确率只比传统方法高了1.8个百分点,成本却是传统方法的一百多倍——调用量子计算资源的费用,懂的都懂。
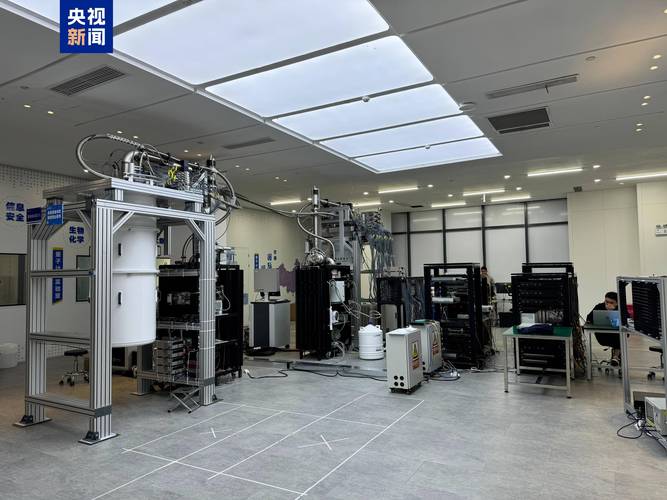 超导量子比特量子计算机实验室内部图
说实话,做完这两个项目我最大的感受就是,现在大部分对外宣称的“落地”,都是实验室环境下的Demo,拿特定的测试集跑出一个好看的速度,放到真实场景里,要么精度不够,要么成本扛不住,根本没法用。
不少创业公司把Demo剪个PPT,就敢出去说“已经实现商业化落地”,割一波投资人的钱,本质就是蹭热点。
最大的误区:量子不是要取代传统AI,是补位
 最大的误区:量子不是要取代传统AI,是补位
我见过最多的扯谈就是“量子机器学习会碾压现有的所有AI,ChatGPT出来都要被淘汰”。扯到没边。
现在我们用的大语言模型、图像识别模型,都是跑在GPU集群上,成熟稳定,成本也越来越低,量子机器学习在这些场景根本没有优势。你让量子计算机跑个GPT级别的模型,现在全球加起来的量子比特都不够用,误差能大到让你认不出来输出的是什么。
量子机器学习真正的用武之地,从来都是那些天生带有量子特性的科学计算问题,这是传统AI根本搞不定的。比如新材料设计,要算新的储能材料的电子结构,传统方法算一年都不一定能算准,量子机器学习天生就能处理量子态,可能几周就出结果。比如可控核聚变里的等离子体模拟,也是一样的道理。
这些才是它真正该去的地方,不是去抢互联网公司推荐算法、人脸识别的活,那些活传统AI干得好好的,轮不到量子来凑数。
不过话说回来,我从来不是唱衰这个方向。我反而觉得,这是未来几十年最有潜力的方向之一。就像七十年前第一台通用电子计算机出来的时候,体积有一个房间大,算个加减法都要好几秒,那时候谁能想到今天每个人口袋里的手机都比当年的超级计算机快几百万倍?
量子机器学习现在就处于那个阶段,硬件不行,软件也不行,全是一堆待解决的问题,但不代表它以后不行。只是现在泡沫太大了,太多人蹭热点圈钱,把一个好方向吹得变了味。
上次去南京参加行业沙龙,散场的时候一堆创业者上来递名片,开口闭口都是“量子机器学习赋能千行百业”,我问了句你们实际用到量子硬件了吗,对方说我们是做软件层的,调用云厂商的接口就行,再追问细节,就开始打太极讲商业模式了。
害,不说了。真正啃硬骨头的,都在实验室里天天跟退相干、比特误差较劲呢,吹牛皮的都在台上讲生态讲未来。量子机器学习本身是个好东西,只希望大家别被吹得神乎其神的PPT忽悠,交了智商税。