代码大模型:正在重构软件开发的隐形规则
上个月在南京江北的产学研沙龙上,跟几位常年泡在一线的开发负责人聊天,聊起当前最火的生成式技术,有人点了根烟笑,说全是虚的——能跑通demo的到处都是,能直接用到生产环境的,一只手数得过来。
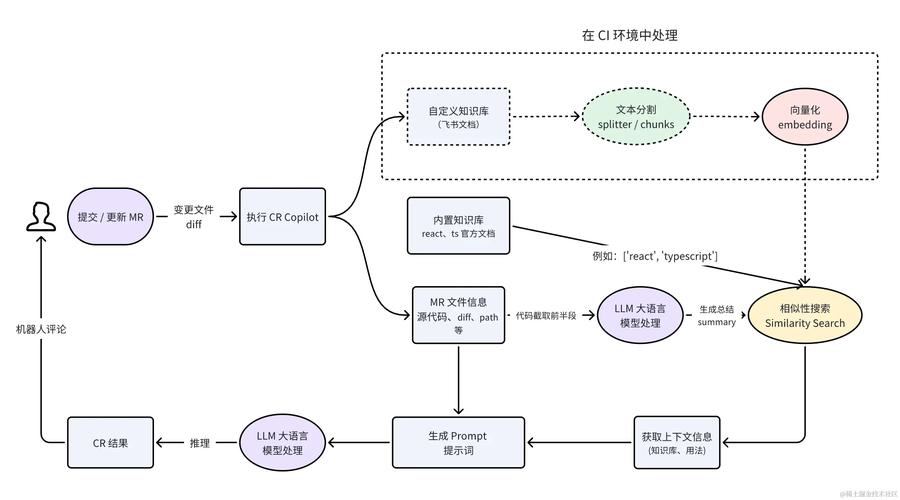 代码大模型生产环境适配流程图
去年我看过一份不对外发的内部测试报告,测试者让不同模型实现同一个电商系统的用户身份校验模块,结果超过六成的模型生成代码,完全没有考虑现有系统的多租户权限继承逻辑,直接套用了通用的校验规则。要是真把这段代码上线,不出一周就会出现越权访问的漏洞,后果不堪设想。
说实话,很多人只看到它写代码的速度比人类快三倍,没看到改它错代码的时间,是人类自己写的五倍。这种账,很多宣传者从来不会算给你听。对吧?
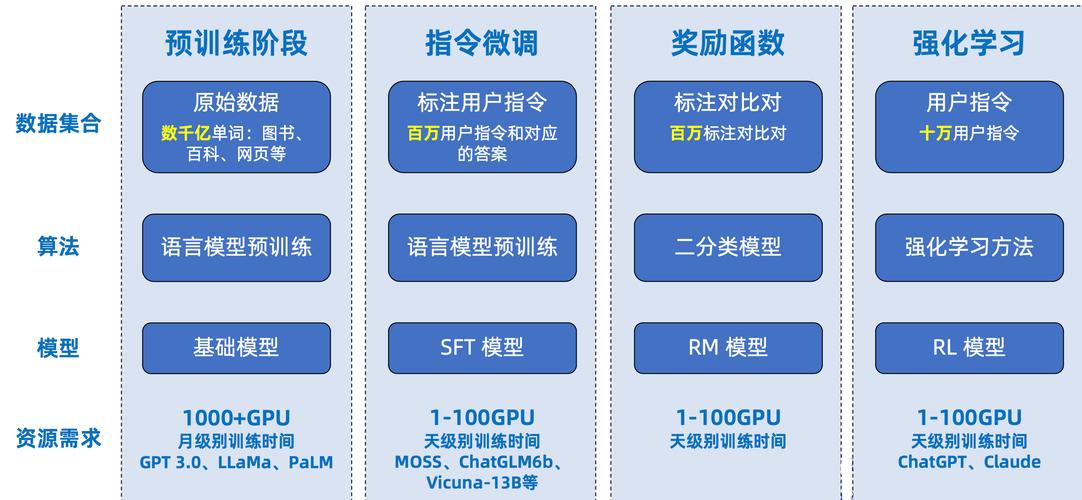 代码大模型训练数据质量分级示意图
比数据更难的,是隐性经验对齐。通用大模型对齐的是人类自然语言的指令逻辑,代码领域的对齐,要对齐的是工程规范、业务约定、只有内部才知道的隐性规则。
举个最简单的例子,金融行业的核心系统,要求所有日期转换必须统一用UTC+8,绝对不能用服务器本地时间,避免分布式部署的时候出现时间差。这种规则不会写在公开教程里,只会出现在团队内部的开发手册上,模型没接触过这类数据,就永远写不对符合要求的代码。
不过话说回来,最近一年已经有不少团队摸到了门道:用垂直领域的生产级代码做小参数微调,出来的效果反而比千亿参数的通用模型好得多。方向错了,堆再多参数都是浪费资源。
 被过度掩盖的应用边界与风险
现在铺天盖地的宣传都在说,它要取代程序员,要重构整个软件行业。这种话听听就好,别当真。
它现在能做好的,从来都是重复性的模板类工作:写CRUD接口,生成基础的单元测试用例,补全注释,转换不同语言的代码语法。这些本来就是初级开发用来熟悉业务的练手活,交出去完全没问题,能解放人力。
但到了核心领域,比如架构设计、需求转译、业务逻辑拆解,它一点竞争力都没有。为什么?因为用户和产品经理提的需求永远是模糊的:“我要给核心客户开个专属快速通道”,这句话背后有无数隐含条件:核心客户的等级怎么判定?流量高峰的时候通道怎么降级?怎么对接现有的计费和日志系统?这些信息从来不会完整出现在给模型的提示词里,它怎么可能生成正确的代码?
更不要说那些被刻意弱化的风险。最大的问题就是知识产权风险,目前绝大多数训练数据都来自公开开源社区,很多代码是带限制协议的,如果模型生成的代码和原代码重合度超过阈值,商业项目用了就是侵权。去年欧洲已经出现了针对这类模型的知识产权诉讼,后续还会有更多。
其次是安全风险。模型天生喜欢生成“看起来正确”的代码,很多藏在角落的漏洞,比如SQL注入、内存泄漏、未授权访问,测试的时候很容易漏过去,真出了事就是重大事故。我听过圈内一个真实的例子,某创业公司用生成的代码写了支付模块的退款逻辑,测试跑了半个月没发现问题,上线三个月才查到,用户每退一笔款,系统就会多算一块钱,最后只能自己掏钱给所有用户补差价,赔了几十万才摆平。
未来真正靠谱的方向,从来不是全替代,而是人机耦合:程序员负责做决策、做设计、把握核心逻辑,模型负责干脏活累活,帮你写模板、查文档、生成测试用例、改格式,把人类从重复劳动里解放出来,去做更有创造性的工作。
前两年AI绘图刚火的时候,也满大街喊要取代画师,结果呢?现在好画师都把AI当起稿和找灵感的工具,效率翻了好几倍,身价反而涨了。这就是工具的正确打开方式。
它不是什么包治百病的银弹,也不是圈钱的骗局,就是一个还在快速进化的生产工具。工具能发挥多大作用,从来都不取决于工具本身,取决于用工具的人,能不能找对它的位置。
通用能力不等于生产落地
大众对这类技术的认知,大多停留在“能自动写代码”的表层,很少有人深究,生产场景对代码的要求,和公开demo完全是两个维度。 能跑通单元测试只是最基础的门槛。真正上线的代码,要兼容团队沿用了十年的老依赖库,要符合内部千奇百怪的编码规范,要适配现有业务的权限逻辑,甚至还要满足监管对日志输出、数据加密的硬性要求。随便一个要求没满足,生成的代码就是一堆废字符。代码大模型生产环境适配流程图
去年我看过一份不对外发的内部测试报告,测试者让不同模型实现同一个电商系统的用户身份校验模块,结果超过六成的模型生成代码,完全没有考虑现有系统的多租户权限继承逻辑,直接套用了通用的校验规则。要是真把这段代码上线,不出一周就会出现越权访问的漏洞,后果不堪设想。
说实话,很多人只看到它写代码的速度比人类快三倍,没看到改它错代码的时间,是人类自己写的五倍。这种账,很多宣传者从来不会算给你听。对吧?
核心卡点不在参数量,在数据与对齐
现在行业里有个很怪的风气,动不动就比参数量,仿佛参数堆得越大,能力就越强。其实核心卡点根本不在这。 决定输出质量的核心,从来都是训练数据的质量,不是数量。你拿一千万行经过生产验证的干净代码,和一亿行Github上充斥着错误、玩具项目、复制粘贴垃圾的公开数据比,训练出来的模型效果,前者一定会吊打后者。很多开源模型拿了一堆低质量数据训练,学了一堆错误的编码模式,自然输出不对。代码大模型训练数据质量分级示意图
比数据更难的,是隐性经验对齐。通用大模型对齐的是人类自然语言的指令逻辑,代码领域的对齐,要对齐的是工程规范、业务约定、只有内部才知道的隐性规则。
举个最简单的例子,金融行业的核心系统,要求所有日期转换必须统一用UTC+8,绝对不能用服务器本地时间,避免分布式部署的时候出现时间差。这种规则不会写在公开教程里,只会出现在团队内部的开发手册上,模型没接触过这类数据,就永远写不对符合要求的代码。
不过话说回来,最近一年已经有不少团队摸到了门道:用垂直领域的生产级代码做小参数微调,出来的效果反而比千亿参数的通用模型好得多。方向错了,堆再多参数都是浪费资源。
被过度掩盖的应用边界与风险
被过度掩盖的应用边界与风险
现在铺天盖地的宣传都在说,它要取代程序员,要重构整个软件行业。这种话听听就好,别当真。
它现在能做好的,从来都是重复性的模板类工作:写CRUD接口,生成基础的单元测试用例,补全注释,转换不同语言的代码语法。这些本来就是初级开发用来熟悉业务的练手活,交出去完全没问题,能解放人力。
但到了核心领域,比如架构设计、需求转译、业务逻辑拆解,它一点竞争力都没有。为什么?因为用户和产品经理提的需求永远是模糊的:“我要给核心客户开个专属快速通道”,这句话背后有无数隐含条件:核心客户的等级怎么判定?流量高峰的时候通道怎么降级?怎么对接现有的计费和日志系统?这些信息从来不会完整出现在给模型的提示词里,它怎么可能生成正确的代码?
更不要说那些被刻意弱化的风险。最大的问题就是知识产权风险,目前绝大多数训练数据都来自公开开源社区,很多代码是带限制协议的,如果模型生成的代码和原代码重合度超过阈值,商业项目用了就是侵权。去年欧洲已经出现了针对这类模型的知识产权诉讼,后续还会有更多。
其次是安全风险。模型天生喜欢生成“看起来正确”的代码,很多藏在角落的漏洞,比如SQL注入、内存泄漏、未授权访问,测试的时候很容易漏过去,真出了事就是重大事故。我听过圈内一个真实的例子,某创业公司用生成的代码写了支付模块的退款逻辑,测试跑了半个月没发现问题,上线三个月才查到,用户每退一笔款,系统就会多算一块钱,最后只能自己掏钱给所有用户补差价,赔了几十万才摆平。
未来真正靠谱的方向,从来不是全替代,而是人机耦合:程序员负责做决策、做设计、把握核心逻辑,模型负责干脏活累活,帮你写模板、查文档、生成测试用例、改格式,把人类从重复劳动里解放出来,去做更有创造性的工作。
前两年AI绘图刚火的时候,也满大街喊要取代画师,结果呢?现在好画师都把AI当起稿和找灵感的工具,效率翻了好几倍,身价反而涨了。这就是工具的正确打开方式。
它不是什么包治百病的银弹,也不是圈钱的骗局,就是一个还在快速进化的生产工具。工具能发挥多大作用,从来都不取决于工具本身,取决于用工具的人,能不能找对它的位置。